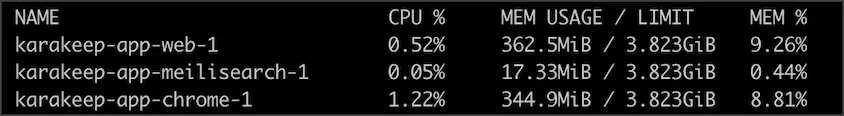
Karakeep 0.34.0 发布,GitHub 星标近 3 万。本次更新包括:网页抓取改用 Patchright 和完整 Chrome,提升反爬与 Cloudflare 验证处理能力;移动端支持自动离线下载和完整列表离线保存;新增手动保存视频功能;修复内存泄漏,常驻内存降低约 40MB;优化数据库与搜索。注意:认证已迁移至 Better Auth,网页用户需重新登录。
本文介绍如何用Python构建AI网页抓取器:先抓取网页,用BeautifulSoup清理HTML,再用markdownify转为Markdown,最后调用OpenAI模型回答用户问题。通过减少噪音和token消耗,输出简洁的Markdown答案。文章还讨论了成本考量,建议根据需求选择自建或使用现成工具。
本文区分了网络爬虫与网页抓取,并推荐了2026年七款最佳爬虫工具:Olostep(首选,性价比高)、Firecrawl(适合RAG)、ScrapeGraphAI(开源本地运行)、Scrapling(Python框架)、Crawl4AI(自托管)、Scrapy(成熟稳定)和Crawlee(多语言支持)。选择工具需权衡控制力、易用性、价格和速度。
Amazon Bedrock AgentCore 提供托管的联网搜索和网页浏览能力,支持多种 Agent 接入。用户可通过简单配置实现实时搜索和网页抓取,解决自建方案的运维和稳定性问题。该服务在 AWS 内部运行,确保数据安全与合规,适合企业快速部署和使用。
这篇文章介绍了一个全栈网页抓取课程,旨在帮助用户绕过现代网站的反自动化检测。课程由Gavin Lon开发,内容涵盖使用Playwright和Cheerio工具、配置住宅代理和浏览器指纹,以及构建可视化实时数据的MERN应用。课程在freeCodeCamp.org的YouTube频道上提供,时长6小时。
Firecrawl现已在Vercel市场上线,帮助开发者利用结构化网页数据支持AI代理和应用。该工具能够将网页抓取为markdown、HTML或结构化数据,支持单次调用检索完整页面内容,并与动态网站互动。
Obscura是一个用Rust开发的无头浏览器,专为AI Agent和网页抓取设计。与Headless Chrome相比,Obscura内存占用更低(30MB对比200MB+),并具备内置反检测能力,避免被网站识别。它兼容Chrome DevTools协议,便于与现有自动化工具(如Puppeteer)对接,旨在提升AI Agent的操作效率,降低成本,适合个人项目和原型开发。
文章比较了browser-use和Playwright在网页抓取中的应用。通过构建Hacker News合成器展示了browser-use的优势,但在复杂的Newegg抓取任务中表现不佳。分析了选择这两种工具的最佳时机。
AngleSharp 是一个基于 .NET 的开源库,用于解析 HTML、CSS 和 DOM,遵循 Web 标准,提供与现代浏览器一致的解析行为。它支持强大的 CSS 选择器,易于使用,适合网页数据抓取和 DOM 操作。通过 NuGet 引入后,开发者可以方便地解析 HTML 和操作文档对象,适合需要精细化网页处理的项目。
作者开发了《洪绘存图》插件,满足图片保存、网页抓取和截图需求,支持多种常见格式,具备轻量级抓取功能和网页截图。
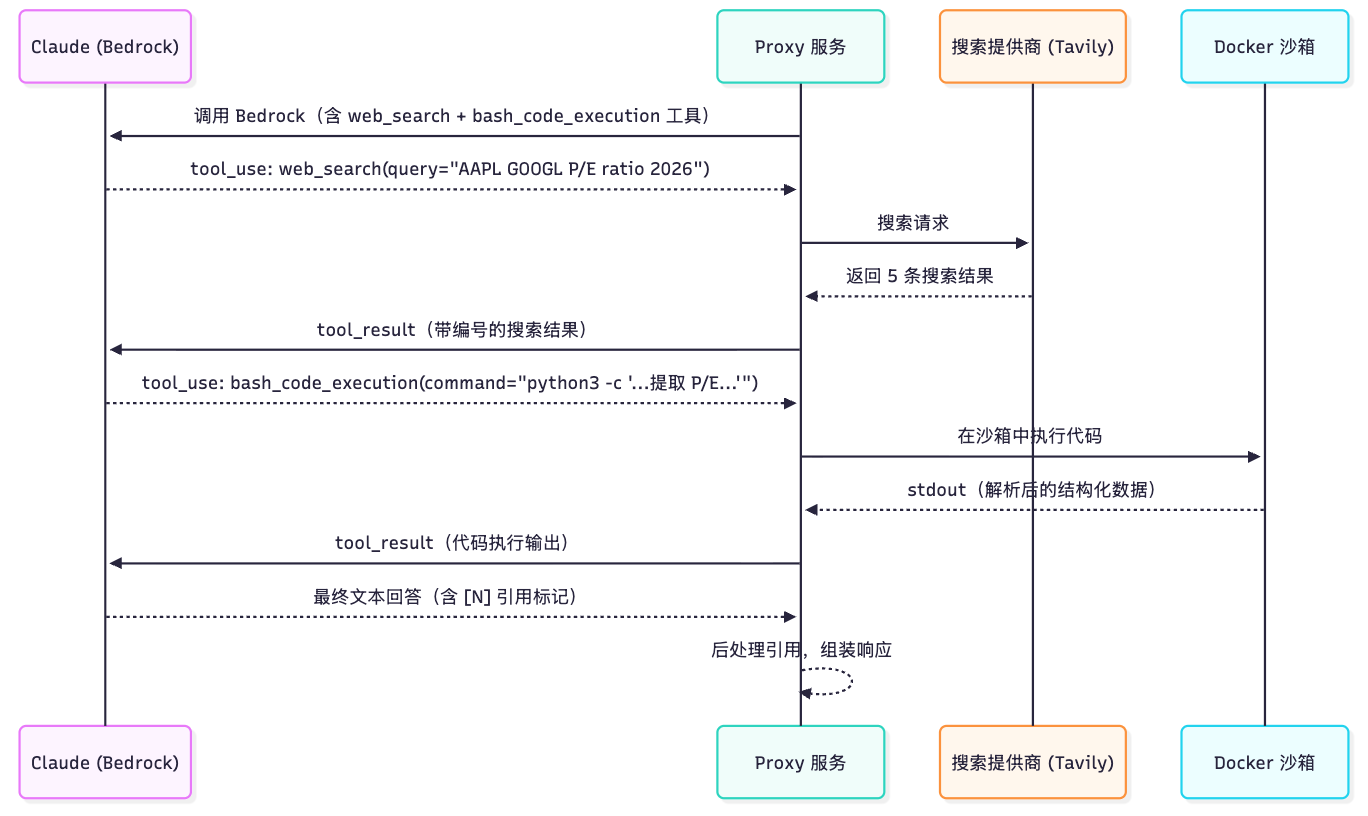
本文介绍了如何在Amazon Bedrock上实现动态过滤的Web搜索和网页抓取功能。通过自建Proxy服务,用户可以利用Claude模型进行实时搜索和抓取,支持动态过滤以提高查询准确性。该方案兼容Anthropic官方API,允许无缝迁移,且无需修改客户端代码。文章还探讨了实现原理、架构设计及其优势,包括降低Token消耗和提升推理效率。
文章介绍用Python的lxml库抓取网页数据,认为它比BeautifulSoup更快,适合解析规范HTML。以抓取Craigslist房源为例,演示用XPath提取索引页链接并保存,再进入详情页抓取帖子ID等字段。建议将XPath封装成函数或存入字典,避免重复写try/catch和硬编码。
本文介绍了10个免费的API,帮助数据科学项目获取高质量实时数据,涵盖基础数据存储、网页抓取、地理天气、金融市场和社交社区数据,便于快速选择和使用。
大型语言模型因依赖过时数据,无法及时捕捉当前事件。Bright Data提供AI-ready的网络数据基础设施,支持网页抓取和商业智能。通过与LlamaIndex集成,AI代理可实时访问相关数据,执行数据提取和网页搜索等任务。
Oxylabs与LlamaIndex结合,提供高效网页抓取解决方案,降低LLM网络搜索成本。用户可通过安装Python包,轻松抓取Google、Amazon和YouTube数据,构建实时搜索代理,获取最新信息,为开发网络应用奠定基础。
GoLogin是一款反检测浏览器,帮助开发者管理多个浏览器配置文件,适用于网页抓取和多账户管理。它通过修改浏览器指纹,确保每个配置文件看起来像不同用户,适合社交媒体自动化、隐私保护和QA测试。GoLogin支持API集成,兼容Selenium和Puppeteer,并提供灵活的定价和免费试用。
数据抓取是自动从网站提取数据的过程,旨在将非结构化数据转化为可分析格式。主要步骤包括发送请求、获取网页、解析HTML、提取数据和存储。数据抓取可分为网页抓取、API抓取、屏幕抓取和社交媒体抓取,广泛应用于市场研究、情感分析和商业智能等领域。抓取时需遵循法律和道德规范,避免违反服务条款和数据隐私。
AP新闻是美联社的新闻平台,ScrapeStorm是一款支持Windows、Mac和Linux的人工智能网页抓取工具,用户可创建抓取任务、配置规则,并将数据导出为Excel和CSV等多种格式。
本文介绍了如何为智能应用加载、解析和清理文档,强调数据清洁的重要性,遵循“垃圾进,垃圾出”的原则。涵盖数据收集、文本提取、元数据提取和网页抓取等技术,旨在将原始文档转化为结构化数据,提高AI应用的准确性和可靠性。
本博客介绍了如何使用Python的Parsel库进行网页抓取,支持XPath和CSS选择器,便于提取HTML数据。内容包括环境设置、数据提取、处理复杂HTML结构以及数据清洗与保存,适合初学者和轻量工具用户。
完成下面两步后,将自动完成登录并继续当前操作。