PolarDB 采用计算与存储分离架构,多个节点可访问同一共享块设备,但仅允许一个节点以读写方式挂载,否则会导致数据损坏。原代码只用本机 fcntl 锁防止同机二次挂载,跨主机仍可能脑裂。为此 PolarFS 新增磁盘 Paxos 租约:每台主机在 paxos 文件中占用一个 512 字节扇区,通过准备、验证、获取、冲突检查的两阶段投票进行仲裁,租约每秒续期;续期失败则分层自隔离(abort、定时 SIGKILL、内核看门狗重启),确保至多一个写者。
文章梳理了MySQL高可用五层体系:单机层依靠WAL、redo/binlog两阶段提交与双1参数,保证崩溃时不丢数据;复制层通过异步或半同步方式将数据传到备库;GTID为事务提供全局唯一标识,使切换后能自动对齐且不重复;主备切换需先追平数据,并用fencing防止脑裂;Orchestrator以反证法检测故障并自动选主,probe-agent补充主机内部视角与执行能力。最后强调应用侧也需配合异步化、降级与熔断。
vip-manager v5更新带来重要变更:配置重构,需移除弃用参数;DCS不可达时自动移除VIP,避免脑裂但可能短暂中断;修复etcd watch取消后的VIP状态同步问题。升级前需在非生产环境测试,更新监控告警和故障处理流程,确保配置与v5兼容。
Anthropic公司开发的Claude模型在技术上表现出色,但其意识形态和道德框架引发用户不适。文章探讨了技术与道德的矛盾,强调对权力结构的警惕,警告绝对正确的信念可能带来的危险。尽管产品实用性强,但对用户思想控制的担忧依然存在。
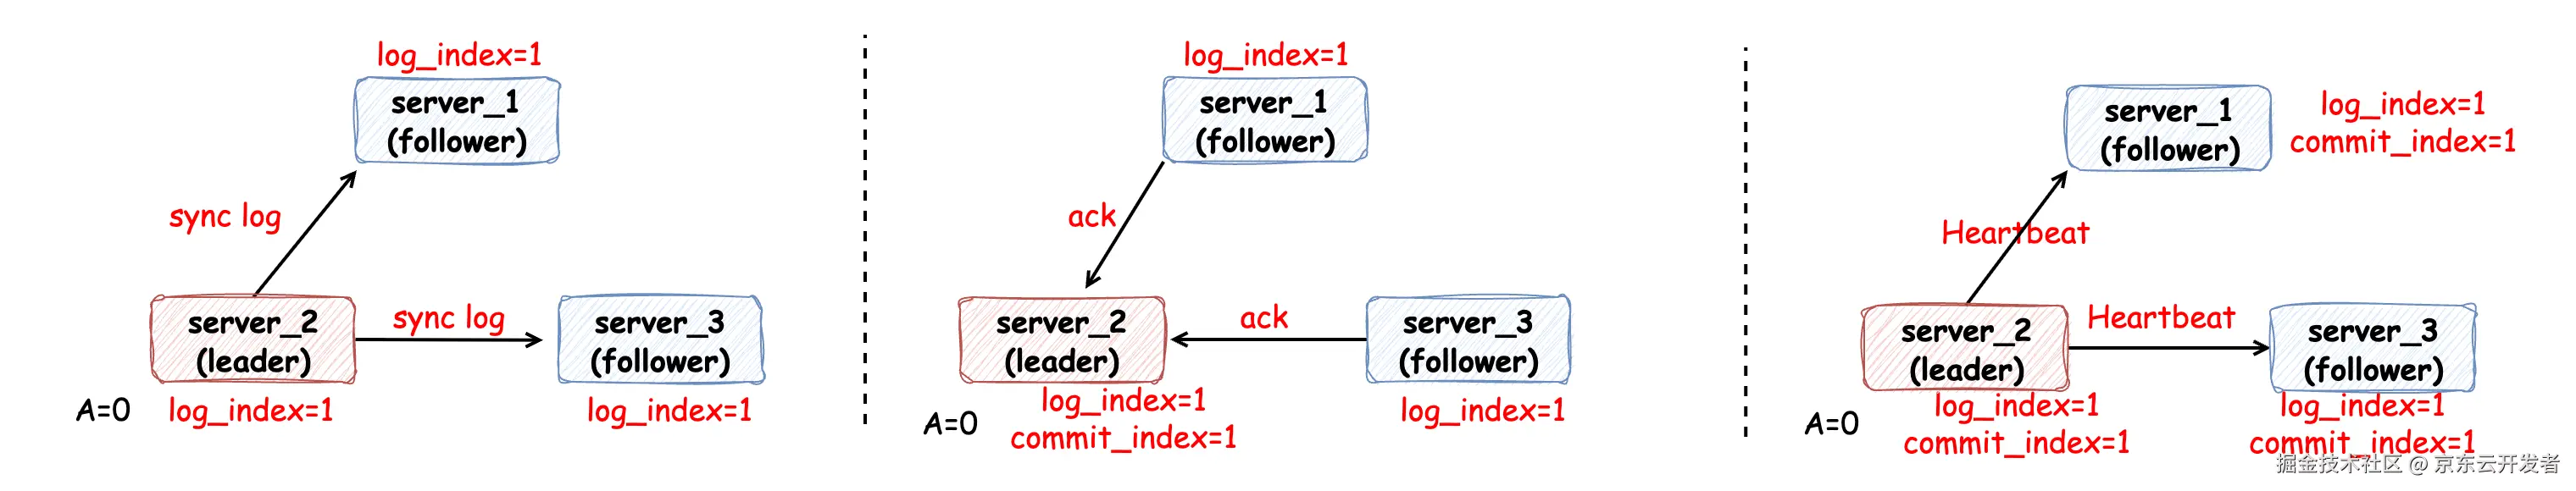
分布式系统面临网络不可靠、时钟不稳定和节点故障等问题。为解决数据不一致,采用Raft共识算法。Raft通过选举Leader节点确保数据线性一致性,Leader处理写请求并记录日志,Follower节点按顺序应用日志。Raft支持线性一致性读,利用ReadIndex和Lease Read优化性能。脑裂问题通过过半数机制和Term机制避免,确保系统稳定性。
用户在虚拟机中启动 Keepalived 时遇到脑裂问题,导致出现两个 master 节点。经过排查发现,VRRP 协议的组播流量未被物理机的 macvtap 接口接收。解决方法是设置接口以接收所有组播流量,从而正常处理 VRRP。
在分布式系统中,时间处理复杂。物理时钟因网络延迟和同步误差不可靠,逻辑时钟如Lamport时钟可解决此问题。超时处理需在失败检测延迟和过早超时间权衡,分布式事务中常用重试解决。节点超时可能导致脑裂,可用token fence方法。计算机有time-of-day和monotonic两种时钟,后者用于计算时间间隔。Google的TrueTime API通过GPS和原子钟提高时钟可靠性。
本文介绍了防止裂脑问题的方法,包括使用多种连接方式、监控报警、增加仲裁机制、启用磁盘锁等。提供了脚本解决裂脑问题。需要根据业务需求确定是否能容忍损失。
在实际生产环境中,我们可以从以下几个方面来防止裂脑问题的发生: 同时使用串行电缆和以太网电缆连接,同时用两条心 […]
介绍Redis集群选举、脑裂、完整性、批量操作和哨兵leader选举。集群需要三个master节点,选举需要半数以上同意。min-replicas-to-write可规避脑裂问题。cluster-require-full-coverage可控制完整性。哨兵集群推荐奇数节点。
MySQL半同步复制是一种增强数据持久性和一致性的机制,确保在主服务器提交事务前,至少有一个副本确认接收变更日志。尽管提高了数据耐久性,但在网络隔离或主服务器故障时可能导致可用性降低和数据不一致。因此,合理配置和监控复制拓扑至关重要。
完成下面两步后,将自动完成登录并继续当前操作。