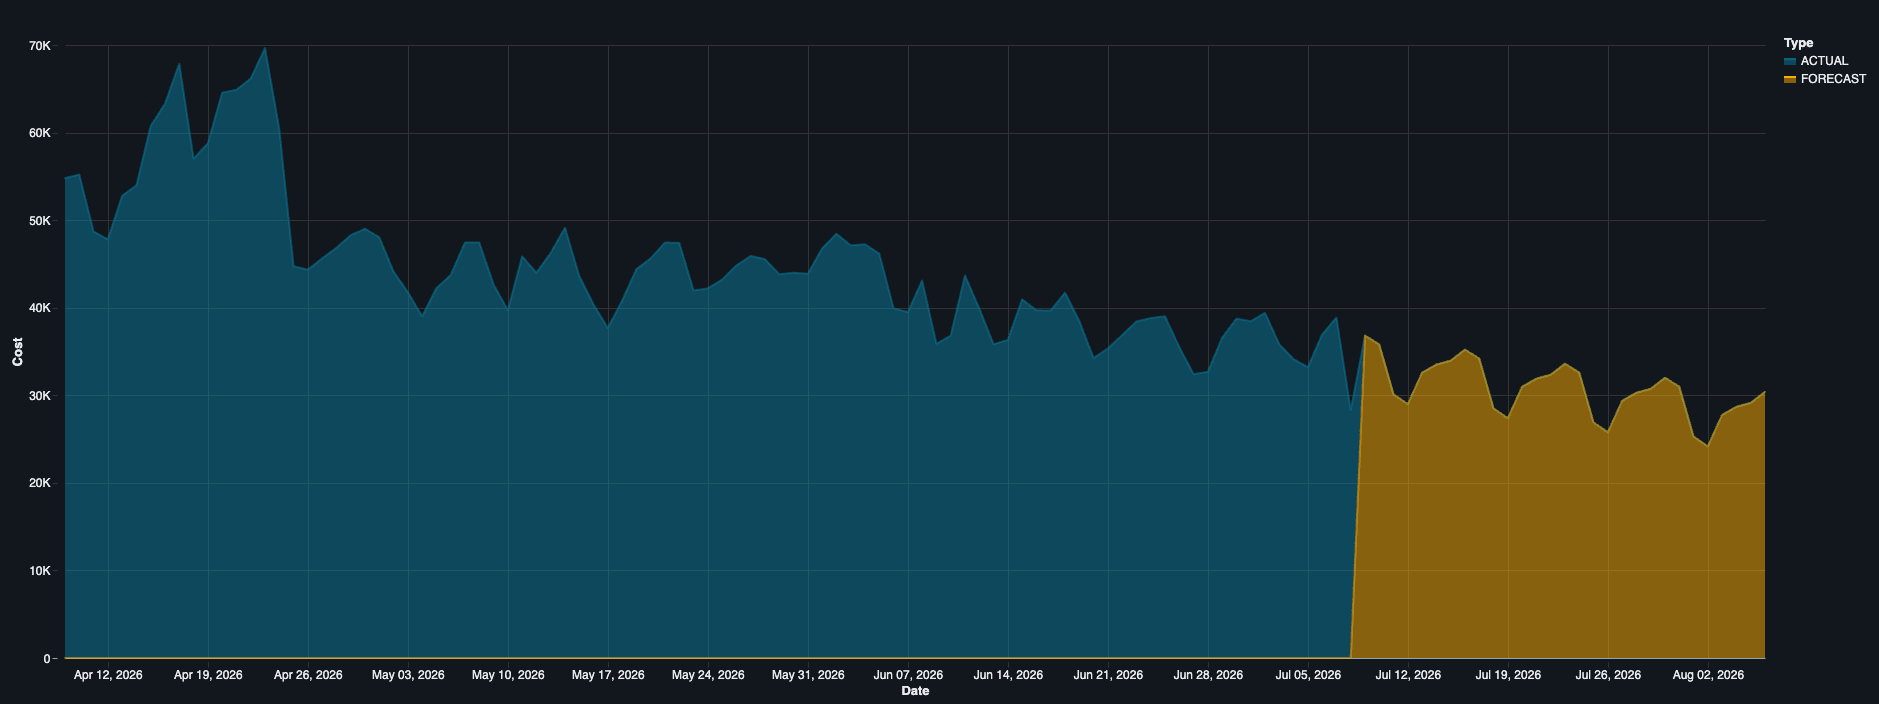
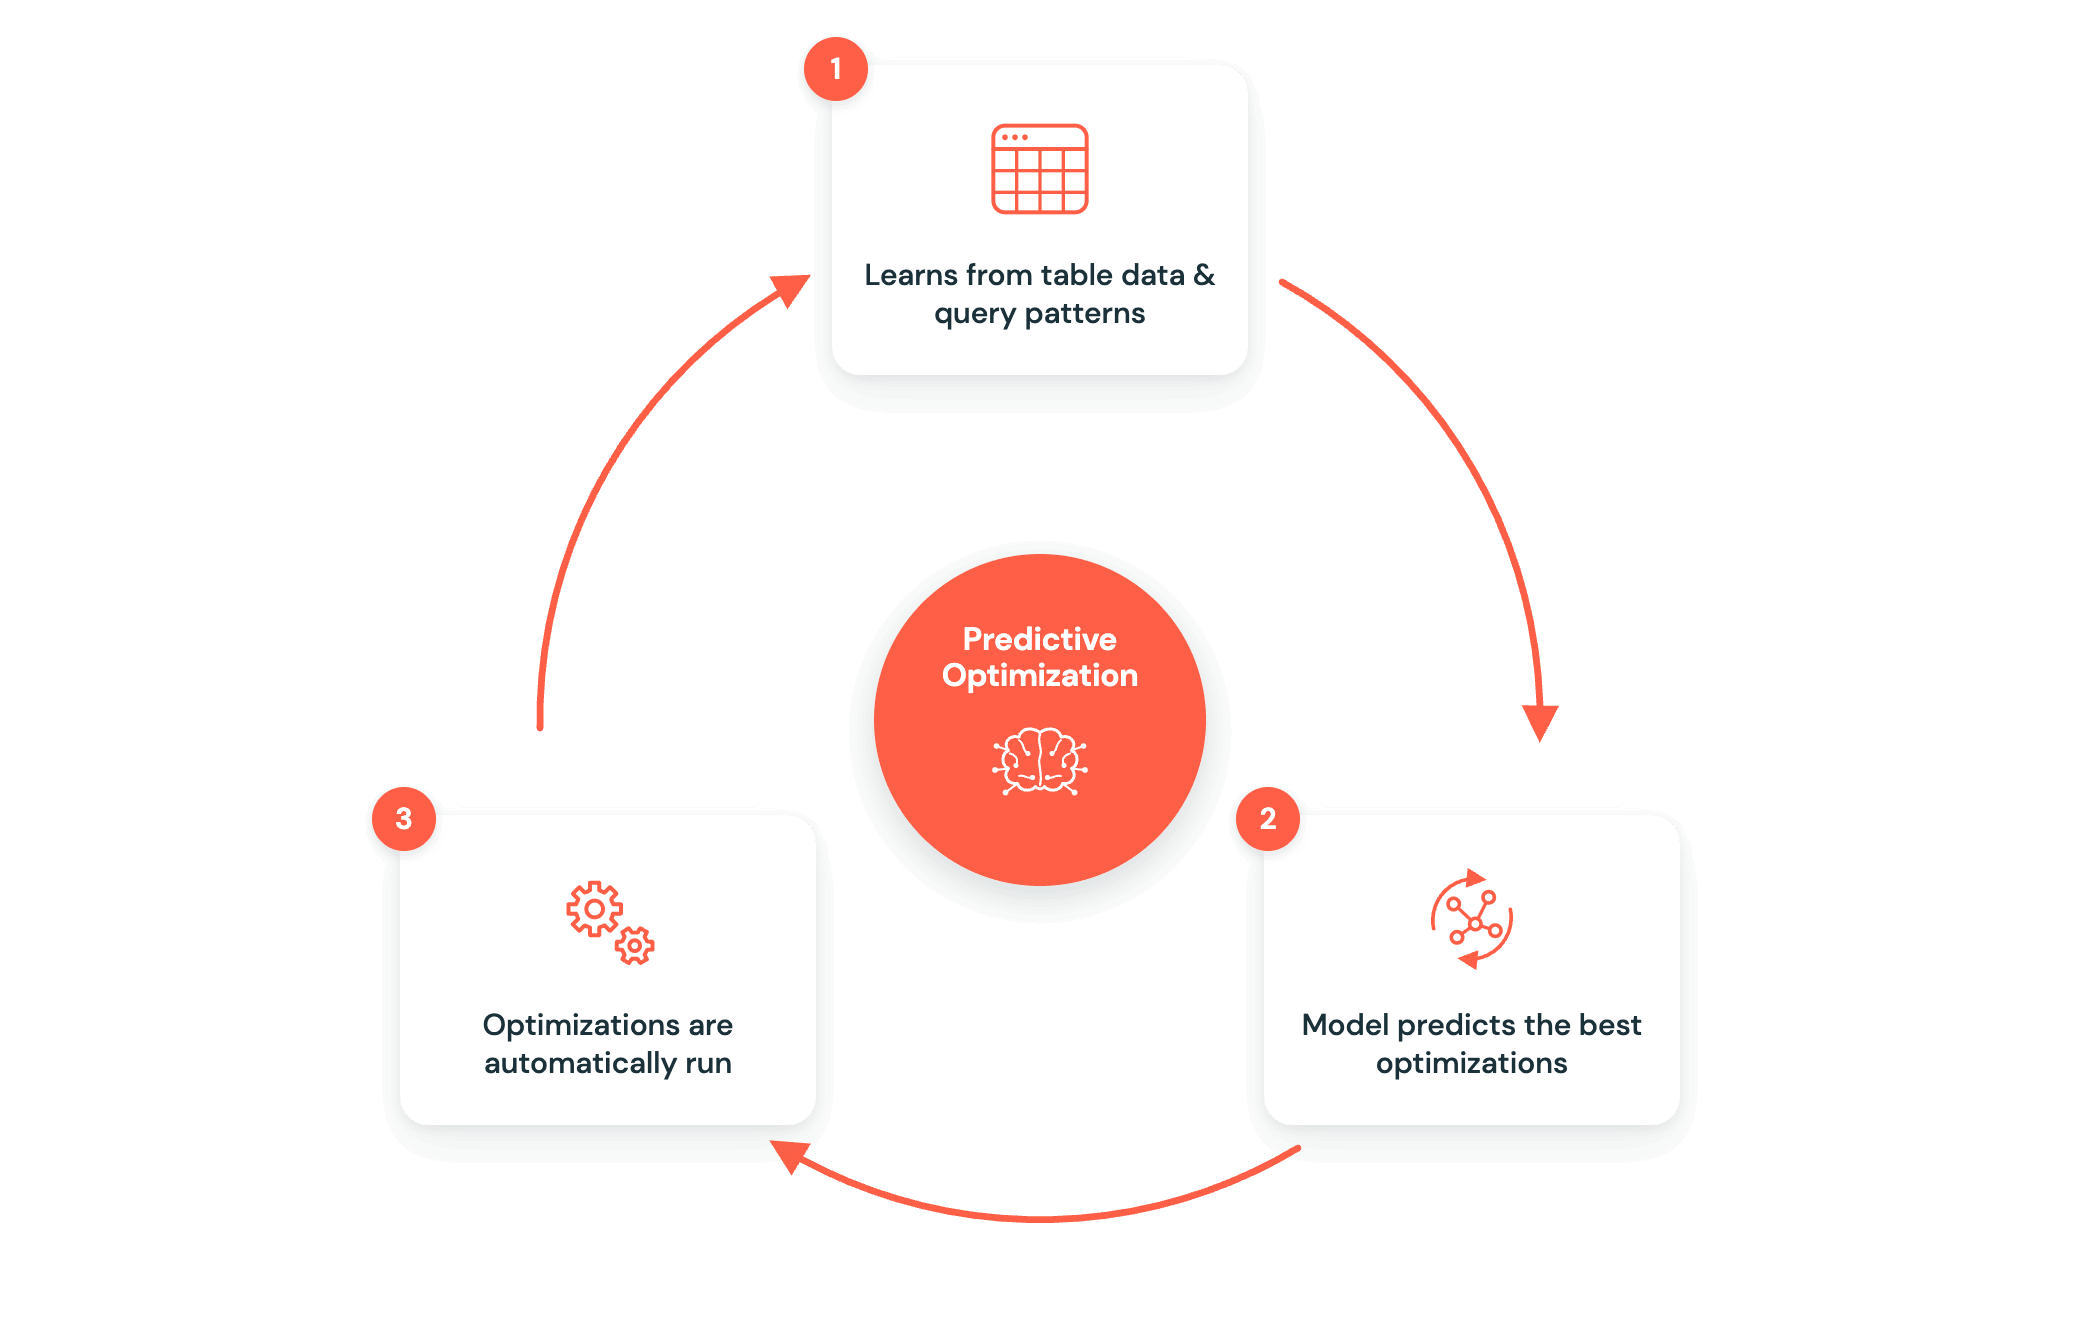
Databricks系统计费表可用于成本分析。本文提供五个SQL查询:按日与产品统计支出、按SQL仓库和标签归因成本、用14天滚动均值标记异常支出,并用AI函数预测下月账单。建议将这些查询嵌入AI/BI仪表板,用于每周成本审查与预算规划。
云值守选型需综合衡量延迟、并发、双向音频、利旧兼容、留证合规五个维度,五者相互制约,无全能方案。应先按“最不能承受哪类失败”排定权重,再打分对比:存量设备多则利旧优先,坐席扩张快则并发优先,纠纷高发则留证合规优先。ZEGO等成熟RTC平台在四维有可验证能力,但存量安防设备利旧接入不占优,需提前计入工程量。
苹果2026秋季发布会后,官网更新爱马仕表带,旗舰款Grand H Titane售价17999元,采用5级钛金属,可延长10毫米。同时发布Apple Watch Series 12和Ultra 4,并推出多款新表带,售价4099元起。
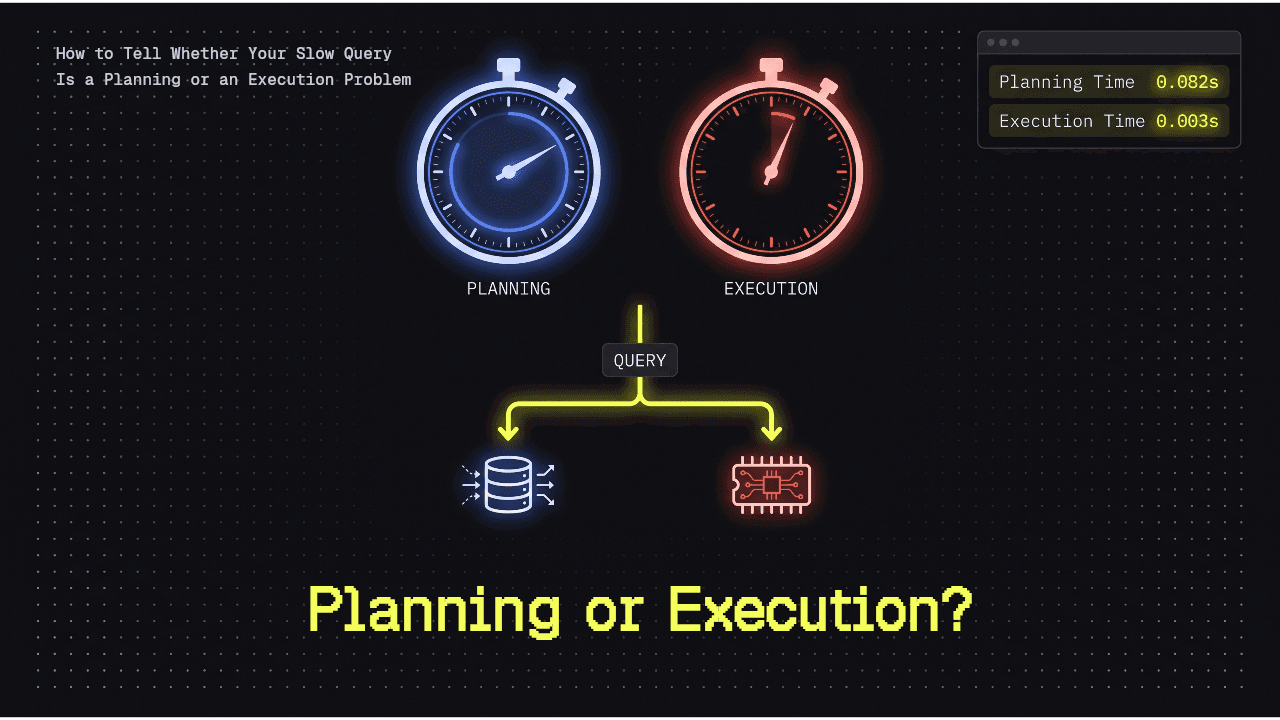
本文介绍如何通过分析PostgreSQL的EXPLAIN ANALYZE输出中的Planning Time和Execution Time,区分慢查询是规划问题还是执行问题,并提供相应优化建议。
文章剖析湖仓Catalog本质:它只是替对象存储保管表指针,核心是一次单行CAS,底层多为PostgreSQL。随着S3支持条件写,独立Catalog技术必要性下降,却成新收费点。治理难题源于控制面不在数据路径上,撤权、行级安全等只能靠引擎自觉。作者主张元数据回归数据库,DuckLake、pg_lake即此路线。
聊天、Agent和工作流三种AI工具各有适用场景:聊天适合一次性问答,Agent能读取文件并交付成品,工作流则用于固定步骤的重复执行。选择时应先明确交付物,依次问三个问题:是否需要答案、成品或重复操作。建议从简单方案开始,涉及不可撤回动作时需人工确认,最终根据任务需求匹配工具。
本文介绍etcd排障的五轴坐标系:Raft共识、WAL持久化、MVCC存储、Watch同步、Lease TTL。通过症状映射到对应轴,提供诊断工具和指标,如endpoint status字段解读。强调先定位问题轴再下钻组件,避免盲目defrag或restore。附K8s控制面对照表和证据包写法建议。
开放表格式(如Apache Iceberg、Delta Lake和Apache Hudi)为数据湖添加ACID事务、模式演进和时间旅行功能,将对象存储中的文件转化为可查询的表。三者各有侧重:Iceberg适合多引擎分析,Delta Lake适合Spark管道,Hudi适合高频更新。它们均基于Parquet文件,并通过元数据管理提升性能,支持并发写入和数据版本控制。选择时需考虑引擎兼容性,并建议进行概念验证。
DB-Scheduler是一款基于数据库的Java任务调度库,仅需一张表即可实现集群部署和任务持久化,吞吐量可达每秒2000至10000次。它采用乐观锁和心跳机制管理任务,但存在长任务重复执行、不支持毫秒级精度、缺乏监控等局限。相比Quartz的11张表,它更简洁高效,适合简单场景,但复杂需求下可能成为瓶颈。
本文介绍JanusGraph基于TinkerPop接口,将图数据存储于Cassandra等宽行后端,采用邻接表布局,边双写,事务非必然ACID,依赖后端一致性。对比Neo4j原生存储,JanusGraph牺牲局部性换取可扩展性,用vertex-centric索引应对超节点,适合已有宽表集群的场景。
本文介绍Excel数据透视表的核心功能与应用场景。它通过合并同类项、定义指标,将细节数据转化为宏观报告。常见用途包括:按区域或产品生成二维统计、自定义利润率等指标、按季度或收入区间分组、用切片器制作动态报表,以及快速合并单元格排版。文章以销售数据为例,演示操作步骤,帮助用户高效分析数据。
xAI发布Grok 4.5,宣称在编码任务上以约四分之一token数匹配Claude Opus 4.8,价格更低。测试显示两者代码结果几乎相同,但Grok用23%的token、三分之一时间完成,成本仅约2美元,而Opus需5.14美元。尽管Opus在文档上更细致,Grok在效率和成本上优势明显,适合关注token消耗的开发者。
Unity Catalog现已进入公共预览阶段,支持外部引擎访问管理的Delta表。企业可以在统一治理下灵活使用多种引擎,享受性能优化和成本节约。通过开放API,外部引擎如Starburst和DuckDB可直接与Unity Catalog集成,实现数据的创建、读取和写入。这提升了数据治理和跨引擎的互操作性,确保了数据访问的安全性和一致性。
第四阶段引入了表、目录和CSV批量加载功能,支持定义模式、逐行添加数据并持久化存储。表由行组和附加状态组成,目录管理所有表的注册信息。CSV加载器将CSV列映射到表列并转换数据类型,为后续的查询执行引擎奠定基础。
本文讨论了对象存储中目录式分区表的缺陷,如并发写入导致的部分提交、查询规划成本高和缺乏快照隔离。为解决这些问题,开放表格式(如Iceberg、Delta、Hudi)提供了原子提交、快照隔离、文件级统计裁剪和schema演进等功能,确保数据一致性和高效查询。
ORC和Parquet是两种列式存储格式,分别源自Hive和Twitter/Cloudera。ORC适合Hive事务表,支持ACID,且在整数和时间戳数据上压缩效果好。Parquet是跨引擎的通用格式,广泛应用于AI和数据分析工具。选择时需考虑具体应用场景和数据特性。
Iceberg通过四层不可变元数据树解决了对象存储中的目录管理问题。这四层分别存储表的状态、快照信息、manifest列表和数据文件,确保原子提交和快照隔离。查询时,Iceberg利用元数据快速定位数据文件,避免了传统方法中的高成本LIST操作,并支持高效的分区裁剪和文件裁剪,提升查询性能。
本文探讨了Parquet文件的结构与性能优化,包括数据的物理切分(行组、列块、页面)、元数据存储方式,以及通过裁剪元数据(如列索引、偏移索引、布隆过滤器)提高查询效率。Parquet采用“先写数据、后写元数据”的设计,文件尾部包含所有统计信息,支持高效的谓词下推和投影下推,显著减少读取数据的IO量。
Iceberg通过隐藏分区和分区演进解决了Hive的分区问题。隐藏分区允许用户在数据列上写谓词,系统自动裁剪分区,避免全表扫描。分区演进则允许在不重写历史数据的情况下修改分区方案,保留旧数据的同时新增分区规范。这些设计提高了数据管理的灵活性和效率。
本文探讨了数据湖与开放表格式的关系,分析了Hive表的局限性及其在对象存储中的应用问题。Hive表依赖目录重命名,缺乏原子提交,导致部分提交和并发写入问题。开放表格式(如Iceberg、Delta、Hudi)通过将表拆分为不可变数据文件、可变元数据和原子切换的catalog指针,解决了这些问题,实现了在对象存储上支持ACID和时间旅行的能力。
完成下面两步后,将自动完成登录并继续当前操作。