Google Flow 推出五款由创作者开发的 AI 视觉叙事工具:Character Poster 可将故事概念转为精美海报;Character Arc 展现角色跨年龄变化;Pixel Machine 生成像素、ASCII 等复古风格;Lucid Glass 模拟玻璃折射与光晕效果;Pocket Studio 将手机素材转为多角度精致镜头。
美团发布LongCat 2.5正式版原生多模态模型,总参数1.6T,采用MoE架构,推理激活48B,重点提升视觉理解与智能体编程能力,支持复杂代码库开发、多轮工具调用及视觉编码。训练引入长程任务轨迹与强化学习。上下文窗口104K,输出上限26.2K。已开放API和在线体验,并计划继续开源。
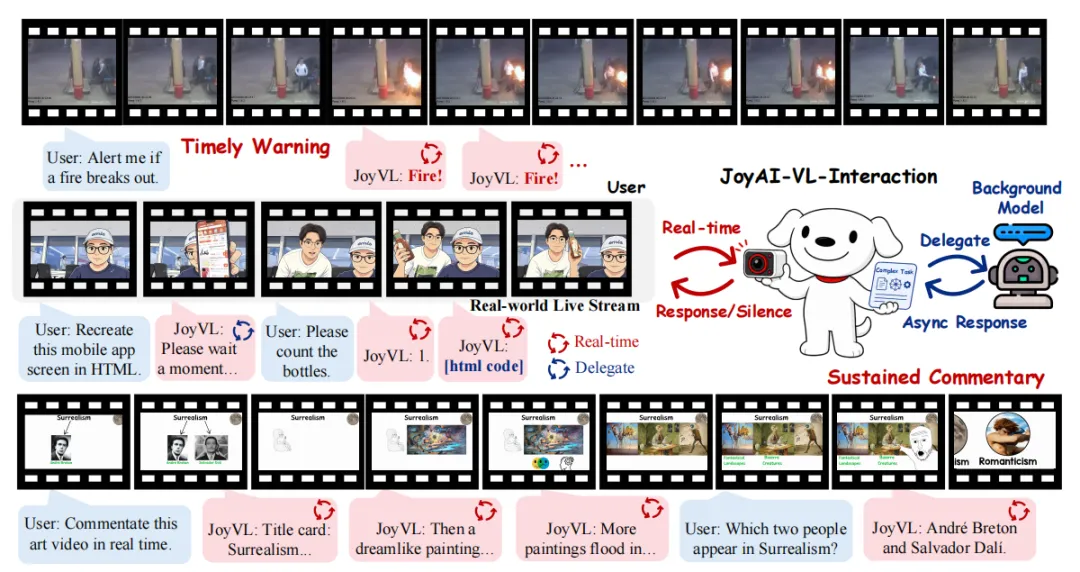
京东探索研究院提出8B规模视觉驱动交互模型JoyAI-VL-Interaction,可持续接收视频流并每秒自主决定回应、沉默或委派后台任务。模型通过时间对齐数据、加权监督微调与强化学习训练交互时机,结合AdaCodec编码、双循环架构和分层记忆支持长时交互。在六类58个案例中,其人类偏好胜率对豆包和Gemini分别为77.6%和87.9%。
GigaWorld-Policy-0.5是一种以动作为中心的世界动作模型:训练时利用未来视觉动态提供密集监督,推理时仅解码动作、不生成未来视频,从而降低计算开销。它采用混合Transformer架构,将视觉动态建模与动作生成分配给不同专家模块,在RTX 4090上推理时延约85毫秒。预训练结合动作条件世界建模与WAM训练,并用AutoResearch流水线自动搜索训练配置。实验表明,该模型在保留未来视觉监督优势的同时显著提升了推理效率。
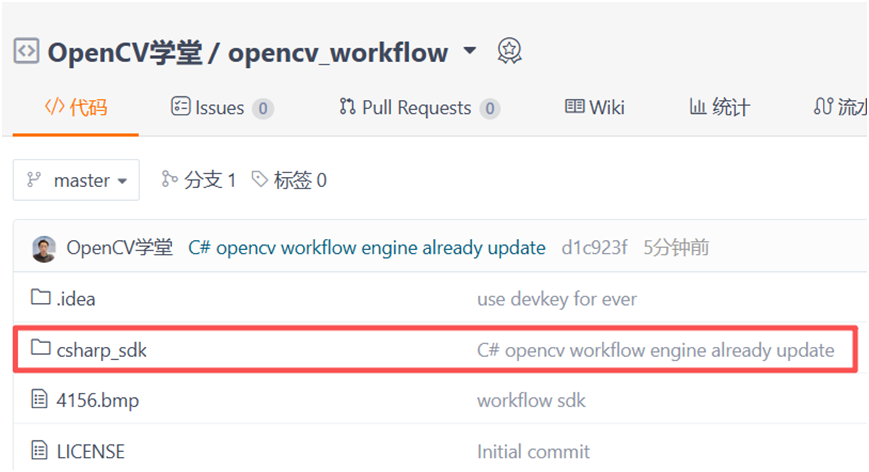
OpenCV工作流引擎支持C++、C#、Python,可复用可视化算子节点图,涵盖图像预处理、找圆找边、模板匹配及YOLO系列模型部署。C#集成仅需三行代码即可完成对象检测与实例分割推理,降低OpenCV学习与开发难度。
文章介绍使用Java 17标准HttpClient调用视觉Responses API,让模型输出商品图的JSON候选信息,再根据置信度和字段完整性决定自动发布(AUTO)或转人工复核(REVIEW)。强调模型输出仅为候选,高风险品类必须人工确认,并需设置超时、审计记录和分层评测集。
Perplexity 发布 pplx-embed-v2-late 视觉检索模型,可直接搜索 PDF 页面图像,无需 OCR。每页约 1700 个向量,float32 下占 856KB,百万页需 800GB。Qdrant 用 TurboQuant 将其压缩至 1 比特,每页仅 40KB,缩小 21 倍,保留 96.5% 检索质量,重排序后达 99.9%。测试显示页面图像检索优于 Markdown,OCR 应变为可选。
文章介绍用Java 17为视觉识别票据金额设置安全门禁:模型只负责提取字段,Java用BigDecimal、币种白名单和金额上限判断能否进入人工复核,避免浮点误差与误报销。代码无需外部依赖,并强调超时、幂等、原图留存与审计,适合低风险票据预分流,不适用于自动付款或税务认定。
文章介绍用 Python 调用 Responses API 识别发票图片的最小实现:模型仅输出候选字段,本地用 Decimal 重算含税金额并校验币种与上限,通过后才进入人工确认。强调不用浮点数算钱、不让模型决定批准、不记录密钥和原图,并给出超时与结构化输出等失败处理建议。
微软在Windows 11预览版中重构搜索功能,将多栏大面板改为单一列表以减少视觉干扰,并改进拼写与同义词匹配。用户可直接在搜索结果中操作,如切换深色模式、蓝牙、静音、调亮度等,无需跳转设置。后续将支持文件预览、网页结果预览及手机操作。
本教程介绍用 Python 调用 Gemini 3.8 Flash 抽取票据字段,并通过 Pydantic Schema 与本地 Decimal 规则双重校验。金额以字符串传输以避免浮点误差;差额超过 0.01、币种未知或图像不清时转人工处理。模型仅负责识别,本地代码负责判断,结果进入待审批队列而非自动打款,同时需防范重复报销与隐私泄露。
谷歌在安卓设备推出Gemini Live“引导视觉”功能,为盲人及低视力用户提供实时视觉解读。用户共享摄像头即可听到环境描述、追问细节并获取语音提示。该功能与Aira合作,经超千名测试者训练,支持读小字、找物品、辨颜色等日常任务,兼容安卓9及以上系统,但并非医疗或导航设备。
Flex-π 是华盛顿大学与英伟达提出的 60 亿参数世界-动作模型,旨在调和 VLA 与 WAM 之争。它用单一冻结 VAE 同时编码 RGB 与 3D 点图,用 DINOv3 提供物体语义,经 Mixture-of-Transformers 融合。训练时随机掩蔽视觉流并施加跨模态强制,使单一权重在推理时可灵活选择快慢路径,兼顾实时性与泛化,无需额外传感器或重训先验。
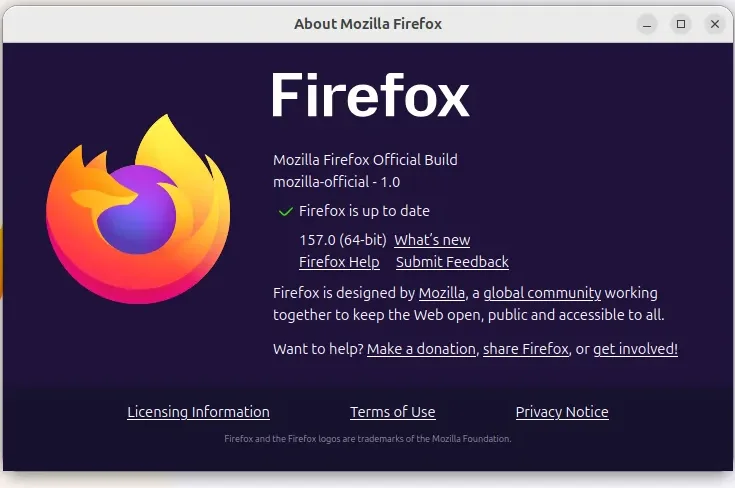
Firefox 157 发布,最大亮点是 Nova UI,对浏览器面板、侧边栏和菜单进行视觉革新。新版支持 WebRTC 视频通话硬件 AV1 解码,修复 HDR 视频问题,改进变速播放时的音视频同步,并移除亚马逊内置搜索引擎。
VLX-Seek是OmAI Lab推出的细粒度视觉语言模型,面向机器人、无人机等边缘具身视觉场景,结合语言理解与区域级视觉感知,支持目标定位、指代理解、区域OCR、描述与计数,并引入目标缺失拒识机制,为具身智能连接环境感知与行动决策提供基础能力。
麻省理工学院可感知城市实验室新书《AI如何看城市》探讨视觉AI对城市研究的价值与风险。作者指出,AI可大规模分析图像数据,用于交通、污染、绿化等研究,但普遍监控会侵犯隐私,训练偏差也可能强化社会偏见。AI并非中立,应审慎、批判且创造性地使用。
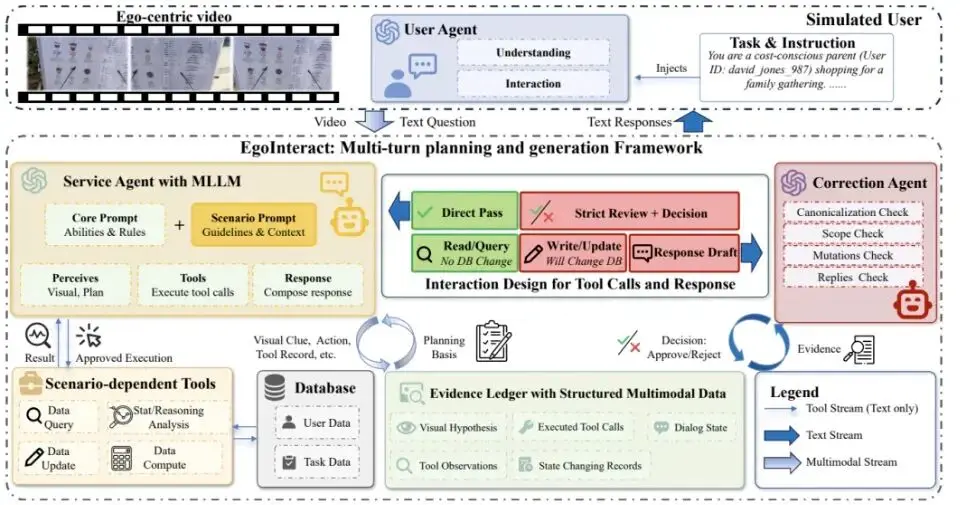
上海交大团队提出EgoInteract系统,用于EgoLink挑战赛Track 2的第一人称社会场景交互任务。该系统包含场景感知服务Agent与范围受限自纠正Agent,通过证据账本统一视觉假设、工具观测与对话状态,防止无依据的状态变更。官方评测中排名第一,联合成功率0.844,微平均准确率0.916。消融实验显示场景规则贡献最大,纠正机制提供针对性防护。
ReferTrack是一种用于具身视觉跟踪(EVT)的“指代-再跟踪”范式,机器人仅靠单摄像头,根据自然语言指令识别目标并规划轨迹跟随。它先从检测到的带索引边界框目录中选择目标,再预测航点。通过滑动窗口队列和TVBI token注入目标几何特征,保留运动线索。模型结合自建Refer-QA数据联合训练,强化指代能力,实现端到端策略,提升拥挤场景下的跟踪鲁棒性。
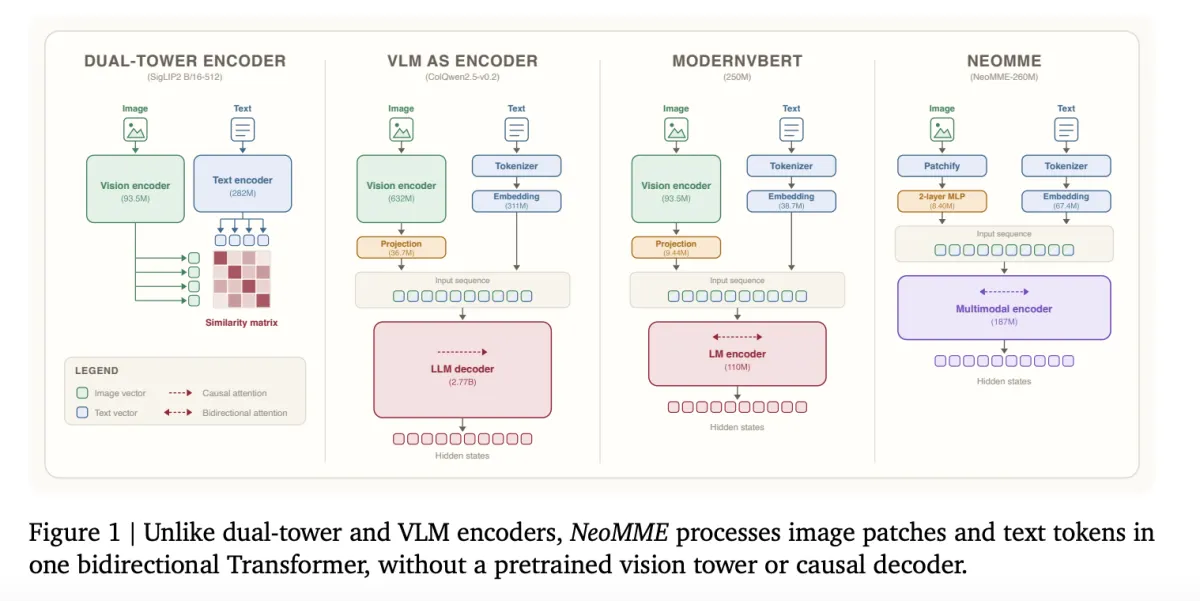
H公司发布NeoMME系列双向编码器,采用单塔架构同时处理文本与图像块,移除视觉塔和因果解码器。其中NeoMME-Retriever-260M在ViDoRe v3基准上达到0.523 nDCG@10,性能媲美3.75B模型,但体积小14倍。该模型支持高效索引压缩,但纯文本检索能力较弱。
商汤科技发布SenseNova-U1.5-8B-MoT统一多模态模型,支持图像生成、编辑与理解,提升4K画质和文字渲染。HyperAI官网更新数据集、教程及百科词条,涵盖语音、地震数据及多模态模型部署,并预告9月截稿顶会。
完成下面两步后,将自动完成登录并继续当前操作。