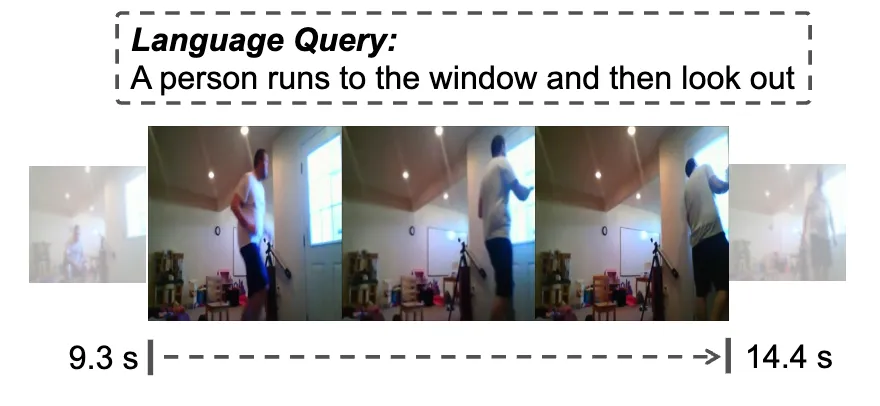
视频时序定位是视频理解的关键任务,旨在根据自然语言查询精确定位视频片段。火山引擎与南开大学联合研发的TempSamp-R1框架,通过创新的混合策略采样、非线性优势塑造和混合CoT训练,显著提升了视频时序定位的效率和精度,已在多个数据集上刷新记录,推动智能剪辑技术的发展。
本文介绍了多种视频时序定位(VTG)方法及其框架,如UniVTG和VTG-GPT,强调了它们在不同数据集上的有效性和灵活性。研究还探讨了无监督学习、跨模态特征融合及新型视频编辑框架,以提升视频定位和编辑性能。
本文综述视频时序定位(TVG)研究进展,涵盖统一框架UniVTG的零样本定位、边界回归新范式、轻量TVG模型、零样本视频字幕、多属性视频编辑、视觉提示文本定位、弱监督文章定位任务WSAG及数据集YouwikHow、TSGV综述、无监督深度语义聚类,以及端到端多模态Transformer模型GTR等成果。
该文综述视频时序定位与场景图生成中的去偏研究:提出D-TSG模型消除检索选择偏差,实现常见与罕见情况下的时序句子定位;设计新评估协议与指标校准IoU分数;采用因果推断、混洗视频、Siamese采样及自监督方法缓解时间与推理偏差;并通过因果图、两阶段因果建模和TEMPURA框架减少场景图生成偏差,提升泛化性与无偏性。
完成下面两步后,将自动完成登录并继续当前操作。