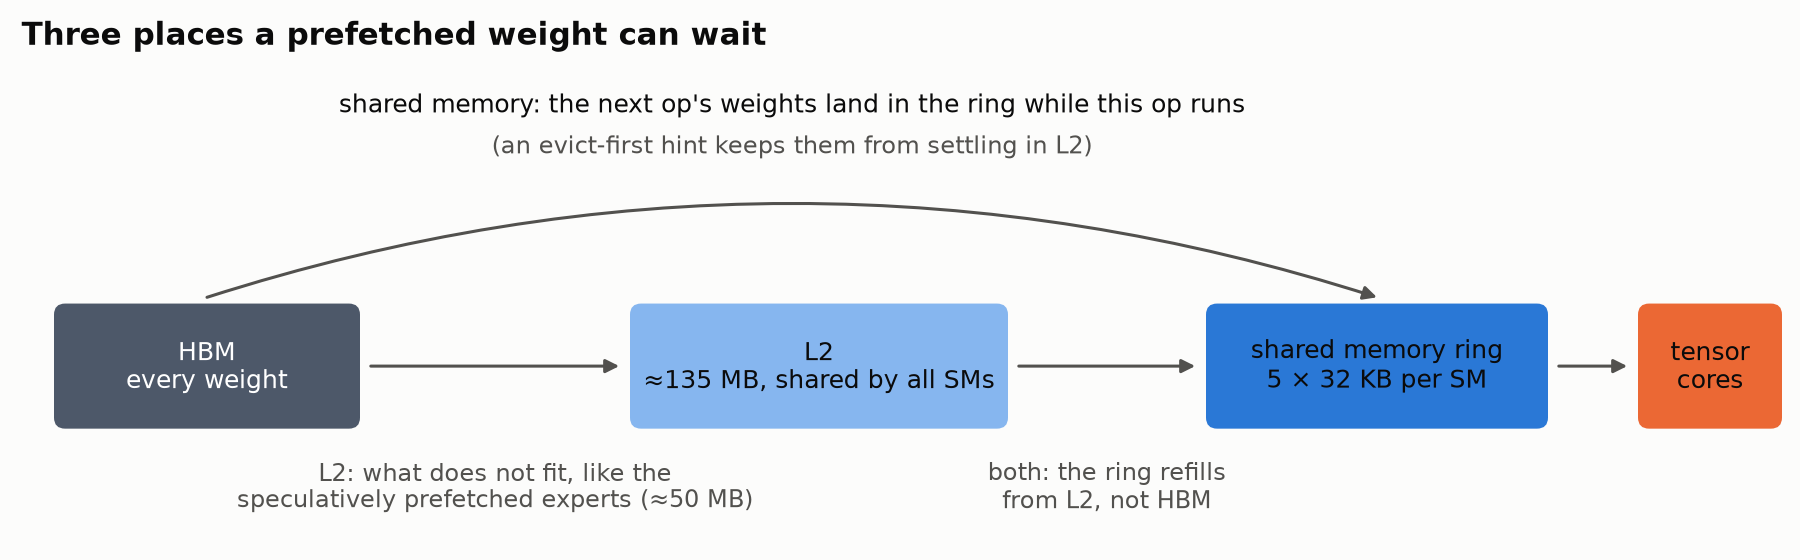
SGLang团队为Muse Spark Open模型开发了“巨型内核”,将每层注意力与MoE合并为单次内核启动,通过预取权重、指令缓存预热和无栅栏同步等技术实现延迟隐藏,使Blackwell GPU解码速度从517提升至1,109 tok/s。文章还介绍了新型张量并行、投机解码优化,以及未来支持更大批次和GPU操作系统的方向。
DeepSeek团队提出的Native Sparse Attention(NSA)通过动态分层稀疏策略,优化了长序列的计算效率。NSA结合压缩、选择和滑动窗口注意力机制,显著提升了64k序列下的推理和训练速度,实现了11.6倍的解码加速,并首次实现了可训练的稀疏注意力架构,确保了训练的稳定性和性能提升,为大语言模型应用提供了新思路。
完成下面两步后,将自动完成登录并继续当前操作。