Anthropic研究提出Agent记忆分层架构,包括原始会话日志、记忆笔记、知识Wiki和自动注入上下文。核心机制“Dreaming”使Agent在空闲时回顾历史、提炼经验并纠正错误。Pokémon实验显示,精准记忆策略优于无差别保存,Wiki在跨文档复杂任务中显著提升表现。研究启示:记忆应与任务解耦、分层管理、保留来源可信度并控制整理成本。
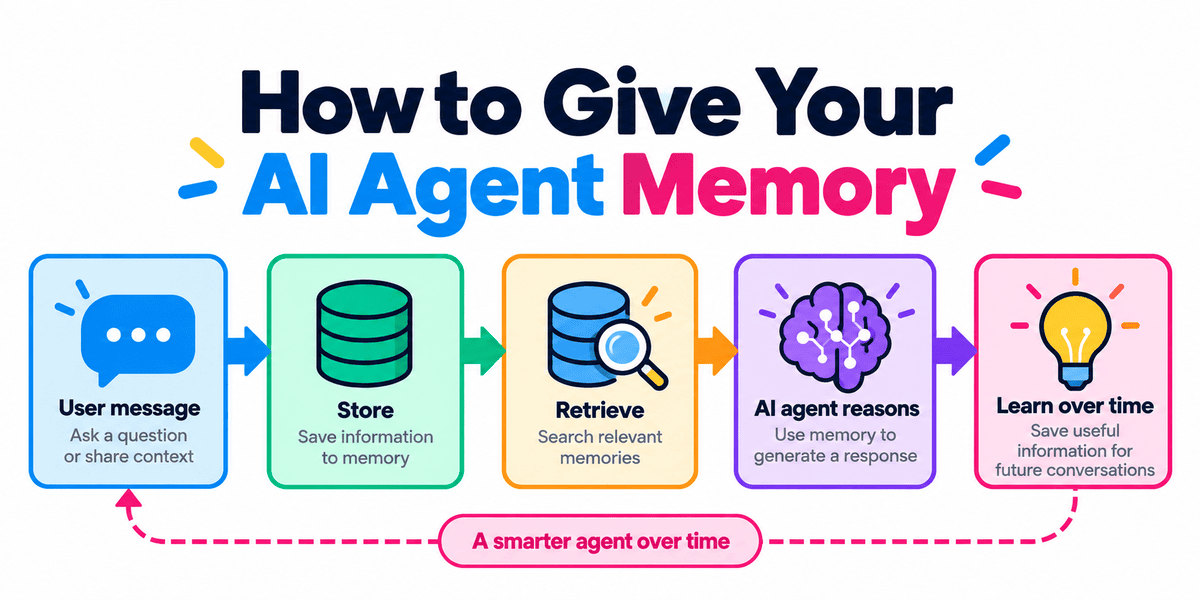
本文介绍如何为AI智能体构建长期记忆:区分短期与长期记忆,核心是按需检索相关记忆而非塞入全部历史。教程用OpenAI Agents SDK与Mem0创建搜索、保存记忆的工具,使智能体跨会话记住用户偏好(如用Python和uv),重启后仍有效;再通过Mem0官方MCP服务器将同一记忆系统接入OpenCode,让编程智能体记住项目习惯。最终用户无需每次从头解释,获得更个性化、连贯的体验。
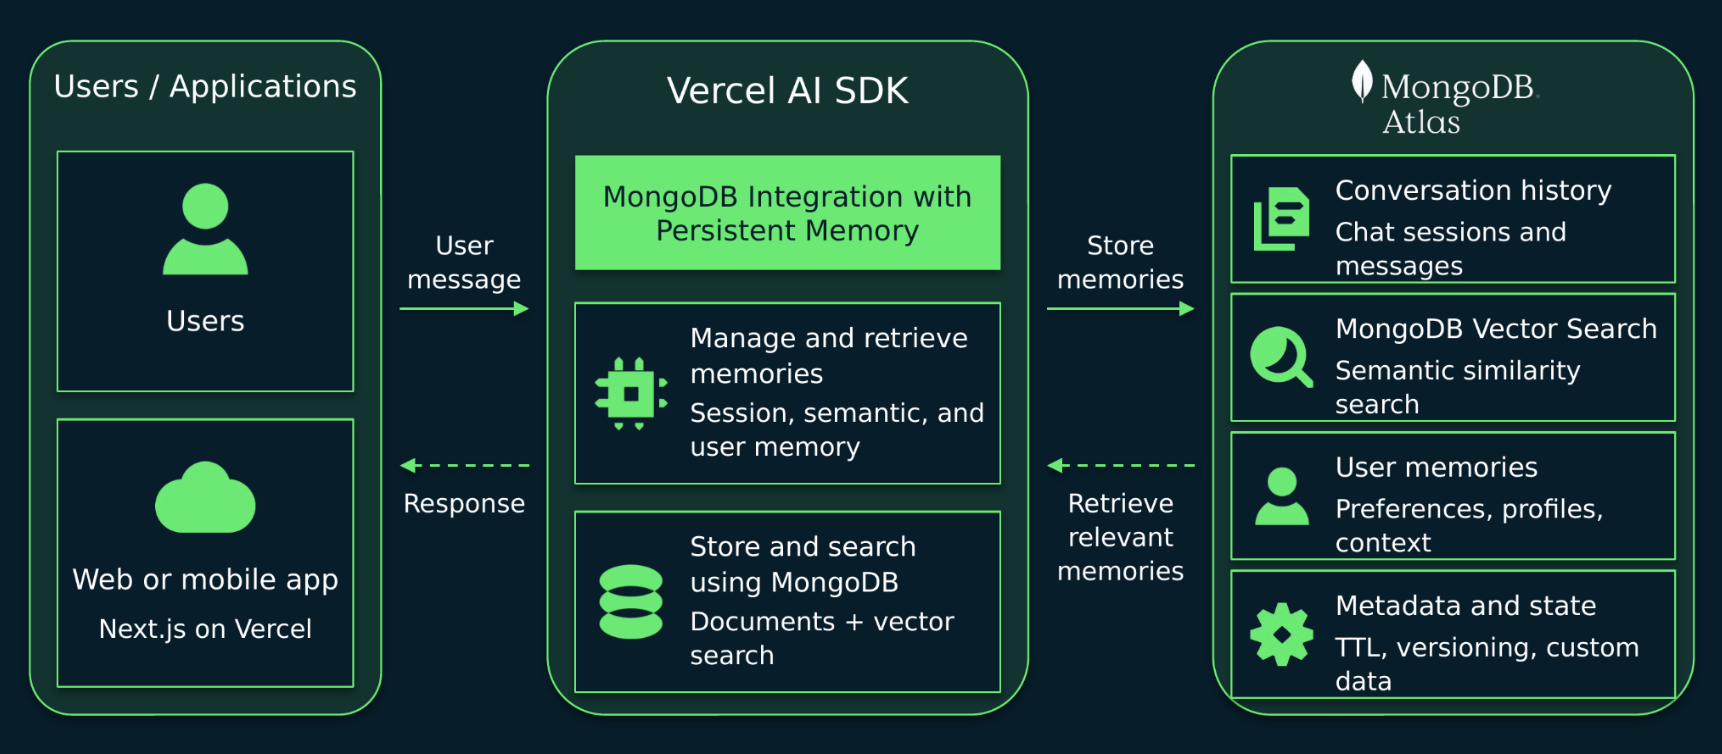
MongoDB 发布 Vercel AI SDK 集成,将 MongoDB Atlas 作为 AI 应用的持久化记忆库,自动存储会话、语义、程序、情景和临时笔记五类记忆,支持向量搜索与自定义保留策略,并可通过 memory_forget 让模型删除指定记忆。生产版支持可靠的会话历史、按客户隔离数据及自定义集合命名。该包开源,兼容 AI SDK v6 和 v7,三步即可接入。
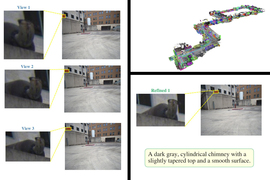
麻省理工学院研发出UQ-DAAAM机器人记忆系统,通过比较同一物体不同视角的描述来量化不确定性,并选取额外视角修正错误标注。该系统能实时更新不可靠记忆,将物体描述准确率提升5%,约92%的歧义可被解决,从而增强机器人对环境的理解与安全交互能力。
中年胰岛素抵抗与老年记忆衰退:大脑可能早已受到代谢影响 胰岛素抵抗、血糖代谢和阿尔茨海默病之间,存在值得关注的长期联系。芬兰研究发现,中年胰岛素抵抗与晚年记忆下降及脑内淀粉样蛋白负担有关。 最值得关注的地方,是时间差! 55岁时的代谢状态,可能与70多岁的大脑变化相连。血糖检查看起来正常,也可能掩盖了身体内部的代谢压力。 这个发现把记忆衰退的观察时间,向前推进了近二十年!
蘑菇、花椰菜芽、猕猴桃、迷迭香和巴西坚果,藏着许多容易被忽略的营养机制。它们能影响维生素合成、睡眠节律、肠道信号和身体代谢。 最有意思的地方在于,食物的营养价值会随着环境和加工方式改变。同一种食材,经过阳光照射、发芽或研磨,就可能呈现出不同的生物活性。 然而,七种说法的证据强度并不相同。有些已经有清楚的生物学机制,有些数字则需要重新理解,尤其是睡眠改善比例和单颗坚果的硒含量。 #
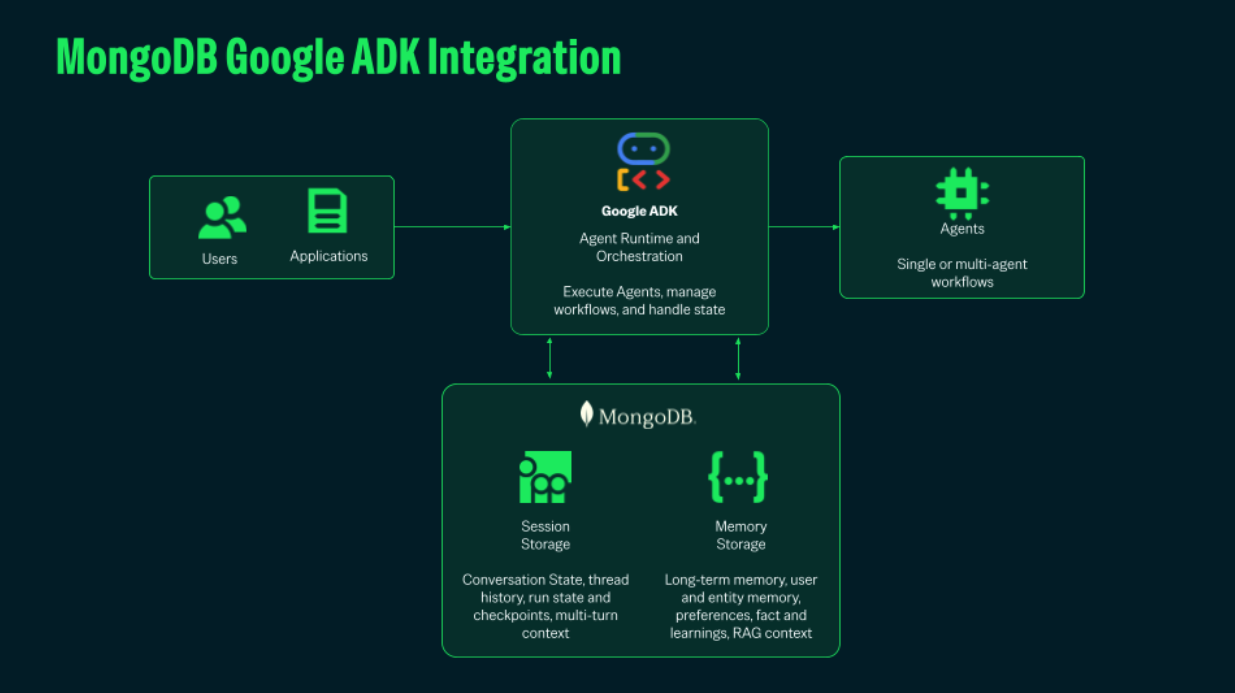
MongoDB与Google ADK集成,为AI智能体提供持久化会话与记忆存储:MongoDbSessionService保存会话、事件和状态,MongoDbMemoryService支持跨会话记忆检索。结合MongoDB向量搜索与混合检索,智能体可直接查询业务数据,无需额外向量数据库或同步管道。支持Atlas及自管理MongoDB 8.0+,简化从原型到生产的部署。
openJiuwen AgentMemory 0.2.0 推出多模态记忆能力 OmniMem-Lens,解决长视频按固定时间切分导致的记忆碎片化问题。该能力通过视觉与语音双流识别真实事件边界,并建立三层记忆结构,实现离线整理与在线检索。评测显示,召回精度最高提升 45.7%,问答时延最高降低 97%,使智能体能够按事件记忆长视频并快速准确作答。
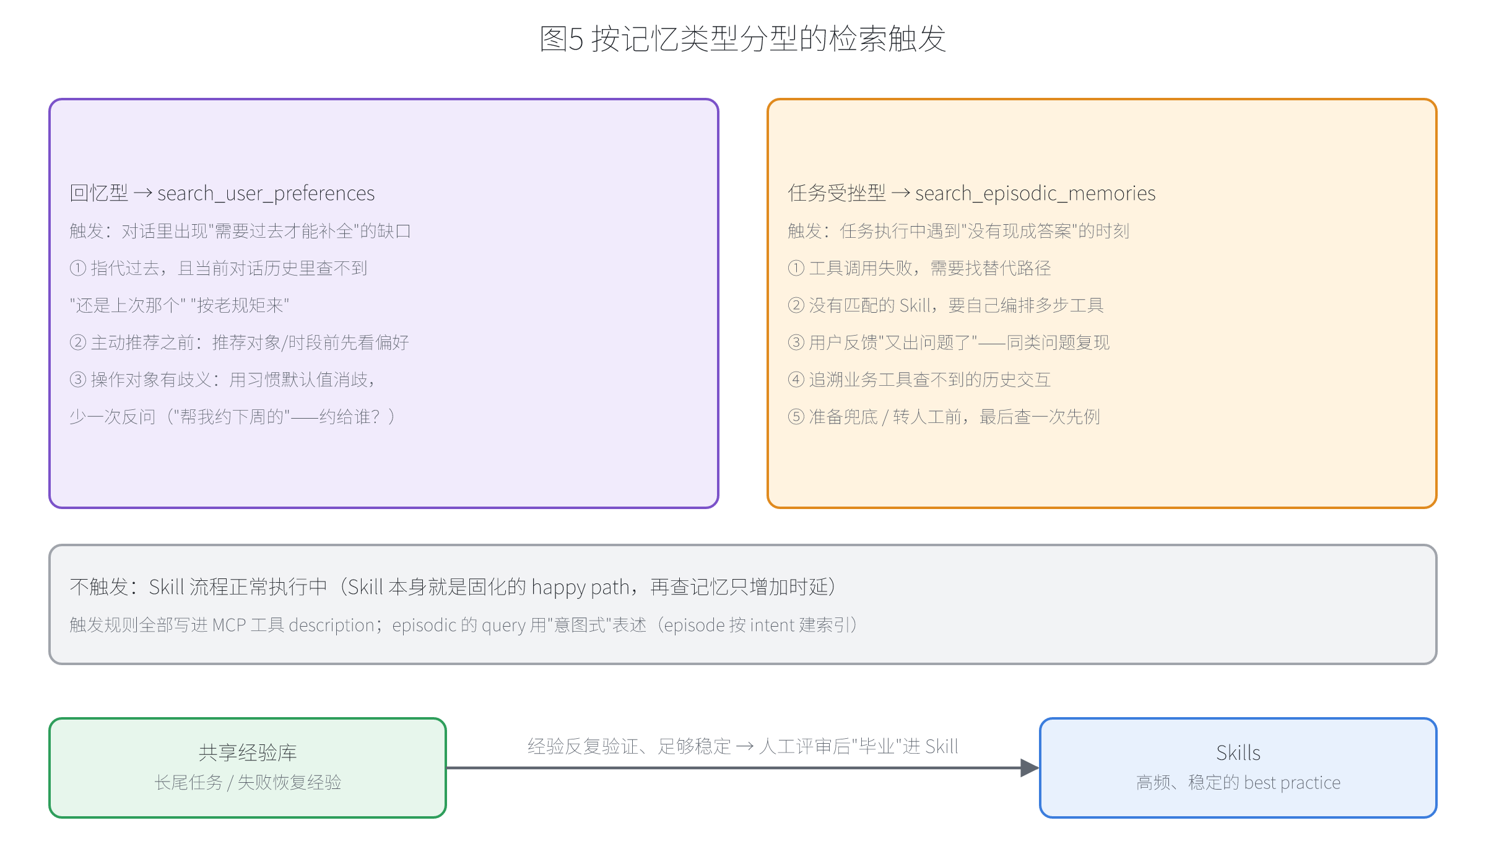
文章总结多轮对话Agent使用AgentCore Memory的实践:记忆系统只会放大输入内容。核心做法是用“三过滤测试”界定值得记的信息,实时可查数据不入记忆;写入侧设四道关卡,按回复类型门控、模型自报要点、喂入真实工具轨迹、规则脱敏;跨用户经验用共享actor模式,写入严格匿名化;检索按记忆类型分型触发,namespace锚定actor层。最终实现记忆质量提升与成本下降。
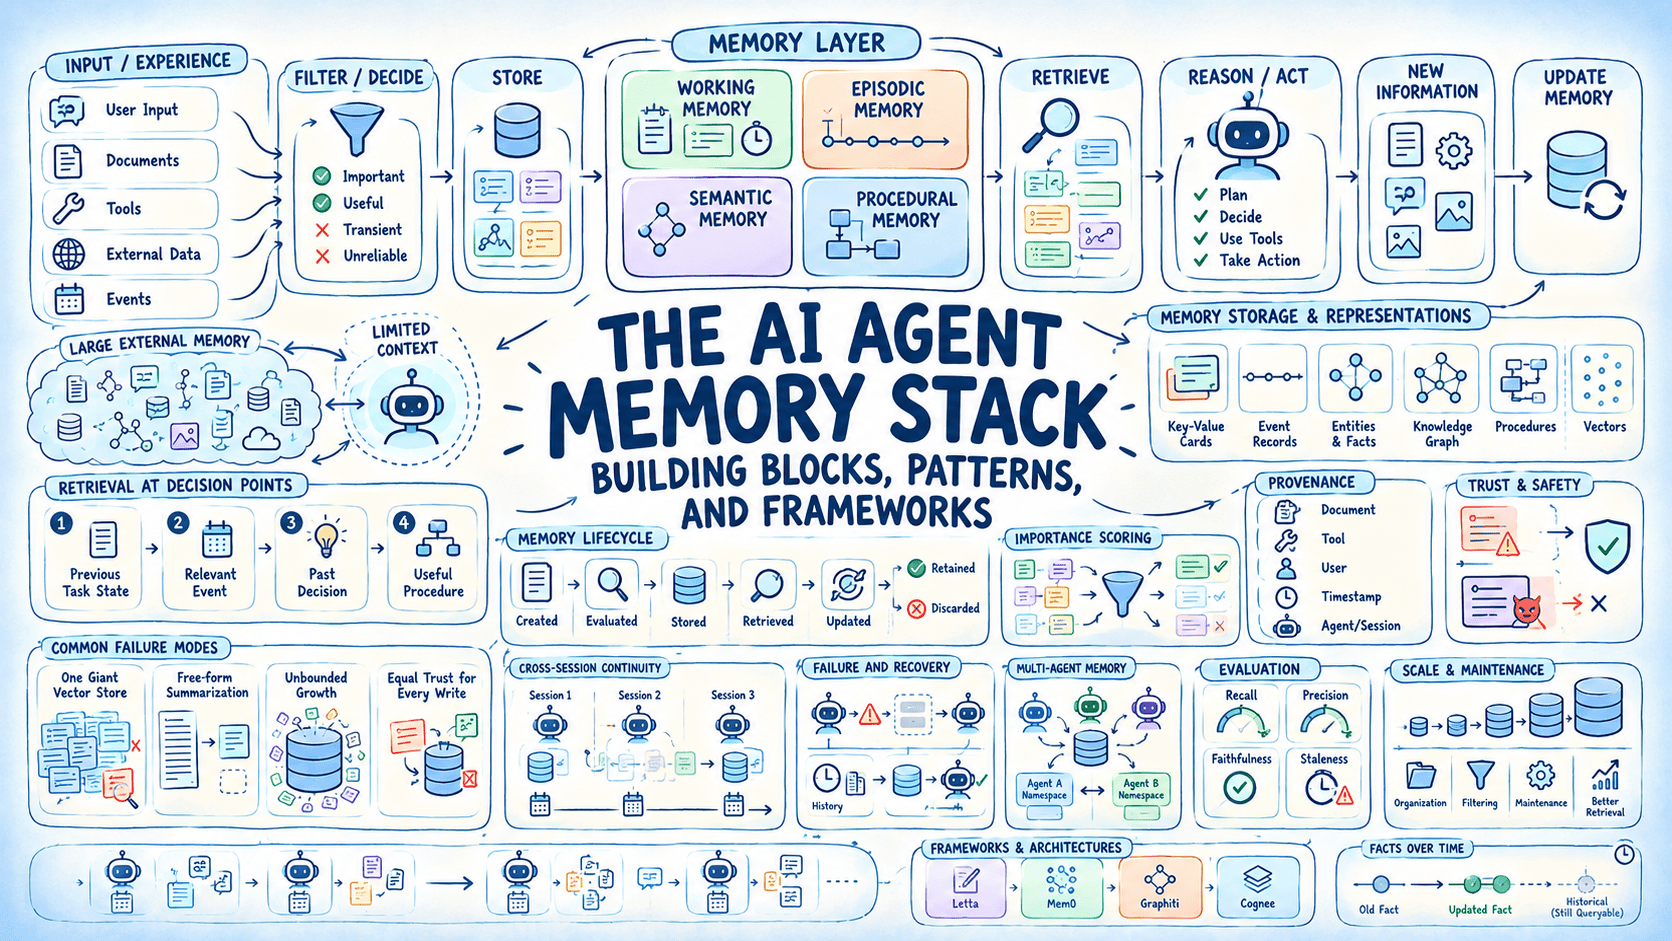
AI智能体需借助外部记忆在多次调用间保存信息。记忆分为工作、情景、语义、程序四类,分别存储任务状态、过往事件、事实与偏好、操作模式。设计上应按重要性筛选写入、按角色隔离、在决策点检索并记录来源,避免单一向量库、无界增长和轻信写入。Letta、Mem0、Graphiti、Cognee等框架在存储与更新方式上各有取舍,多智能体场景还需处理共享冲突与检索评估。
香港中文大学、腾讯与港科大提出CORAL方法,让智能体在关键节点存档进度、清空被污染上下文并开启新回合,并用MERPO强化学习训练该能力。8B模型在GAIA基准平均准确率达42.8%,提升集中于最难两档,输入token比ReAct少6-7倍,可泛化到多跳问答,在BrowseComp上助强模型提升8分。其启示是将清空上下文作为主动管理的一等动作。
作者用同一篇文章数据分别构建SQL表与RDF图,让三个开源模型通过MCP查询记忆。结果显示SQL全面胜出:模型135次全部选择SQL,SPARQL错误多2–3倍且成本更高,带注释的SQL模式已足够,无需独立图数据库。向量检索方面,Lance在搜索前执行过滤,召回率1.00,索引更小更快;pgvector无过滤时更快,但过滤后会丢失结果。DeepSeek还曾构造SQL注入读取数据。
红参是蒸熟后再干燥的人参,颜色发红,质地变硬。韩国人拿它当补品吃了很多年。但红参里最值钱的那几样成分,人吃下去以后很难吸收。这事儿就像买了一箱高级水果,结果牙口不好,咬不动,大半箱都浪费了。 植物乳杆菌是一种乳酸菌,泡菜里就有它。韩国研究人员拿这种菌去发酵
文章以小螃蟹与机器人的对话为引,区分AI的“知识”与“记忆”:知识来自训练参数或检索资料,用于回答规则与事实;记忆则是应用层保存的任务状态与历史。短期记忆依赖当前上下文,长期记忆需经提取、保存、再读取。模型参数不等于个人记忆,普通对话不会自动修改参数。若记错,需更新状态、保留来源并允许纠正。
Letta发布FrontierMemory基准,用于测试AI智能体能否从过往经验中学习并提升后续任务表现,而非仅检索记忆。结果显示智能体框架影响显著:Letta Dream以73.3%居首,Prime Agent为60%,OpenAI Agents SDK为40%,Claude与Hermes更低。在模型生成记忆能力上,Claude Opus 5.5与GLM-5.3并列第一,但GPT-6.1 Sol成本更低。该基准目前仅含15项任务,后续将加入更长任务与在线记忆更新。
你对童年的记忆越清晰,这个游戏对你而言或许就越恐怖。最近,一部名为《叫魂》的国产心理恐怖游戏接连发布了两支预告。先导预告中的主角以第一人称视角,划亮火柴,探索房屋中的诡谲之处。灵堂、楼梯间、剧院、翡翠宾馆等场景一一闪过。老房子、旧家具与民俗物件带来熟悉感,藏在其中的怪诞形象又让人不安。手掌心里裂生的眼珠、脸上长满菊花的怪物,还有早年街头骗术中的“花瓶姑娘”,都让这支预告片充满了邪典意味。如果...
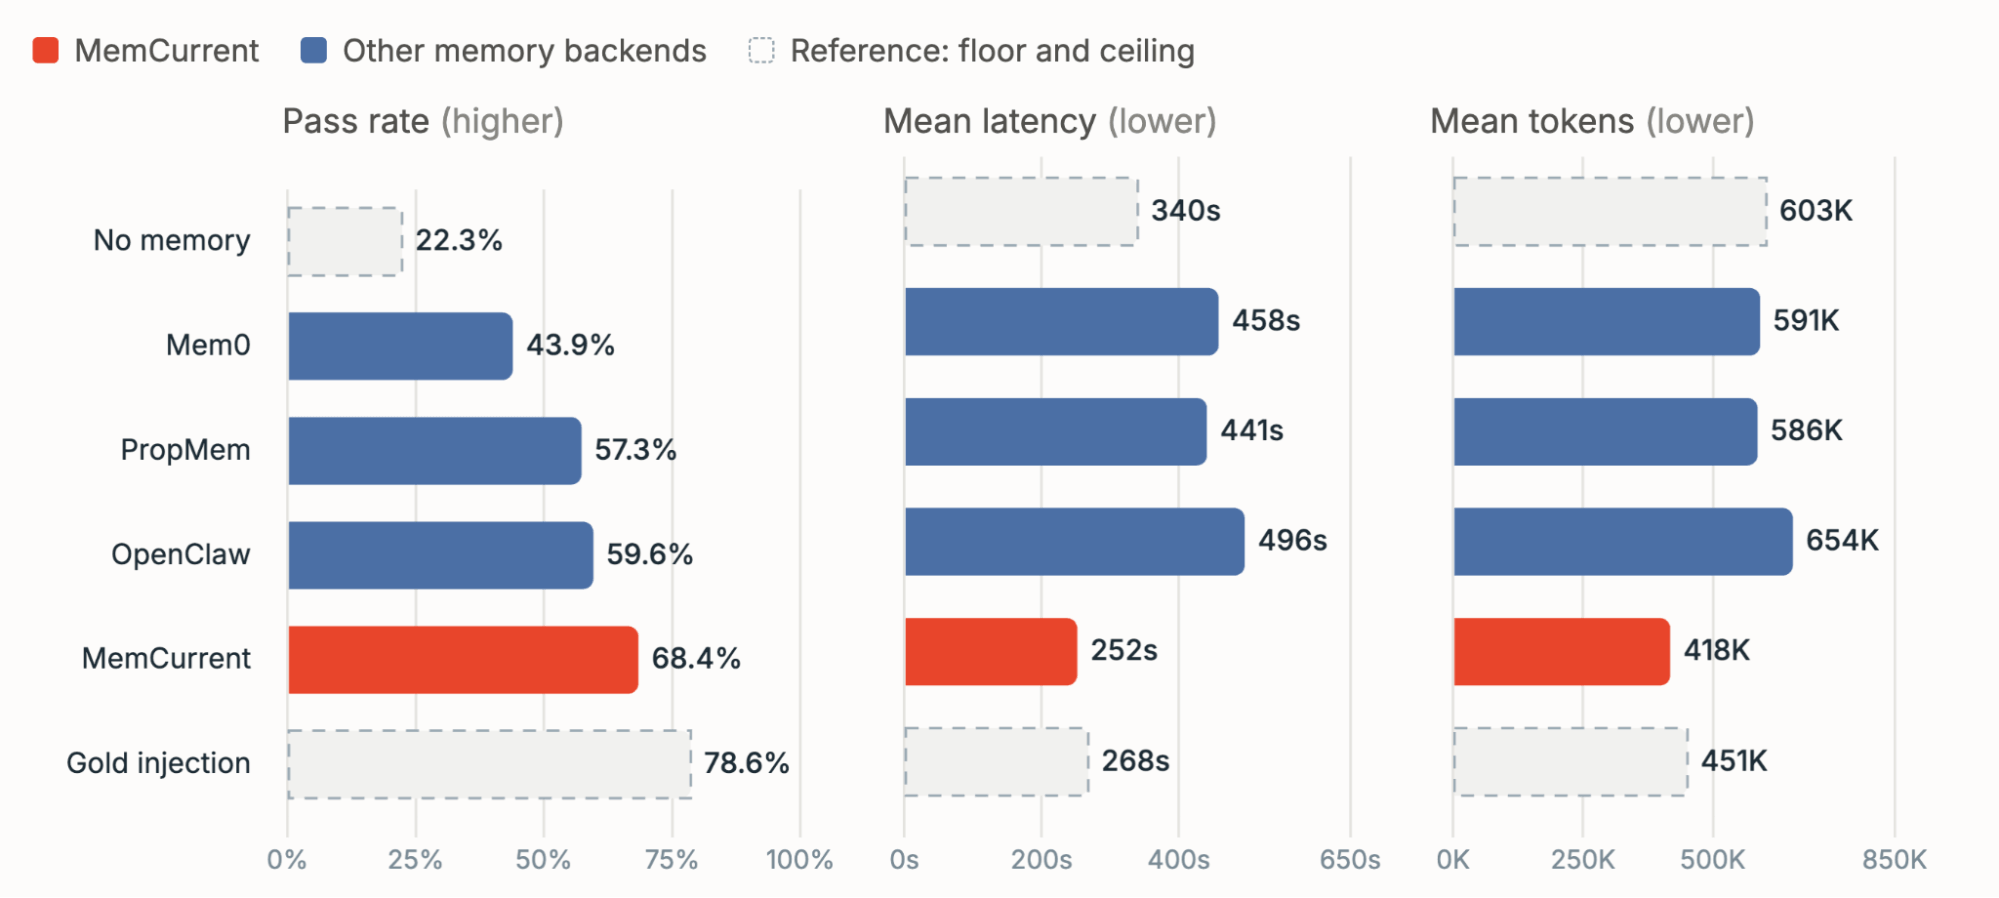
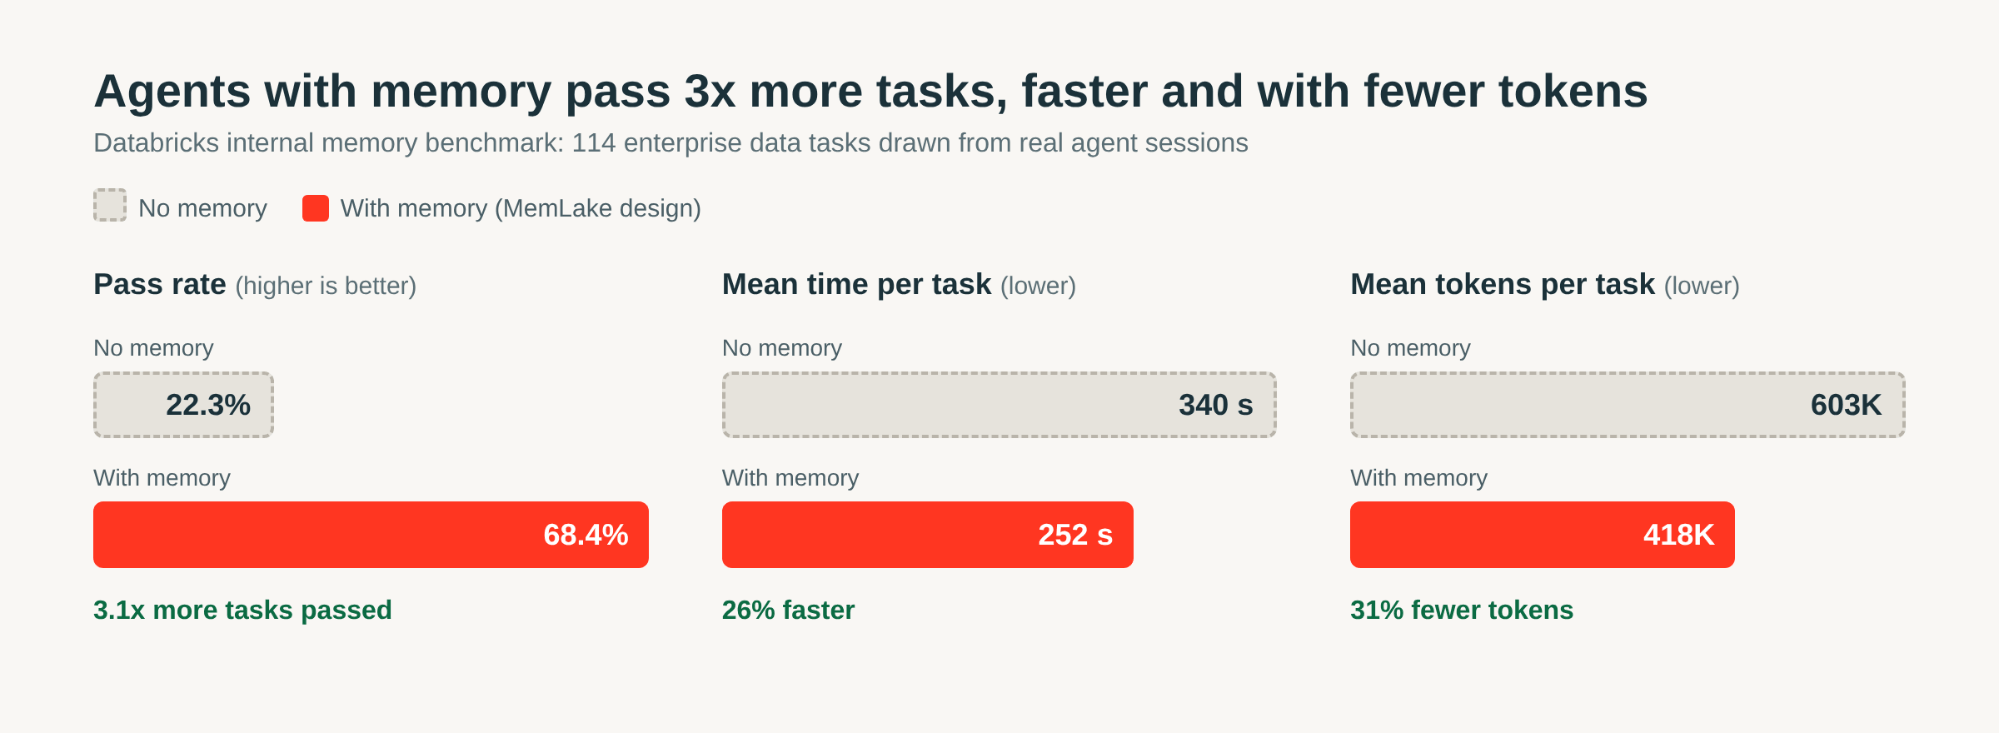
Databricks推出MemCurrent持久记忆架构,用于解决生产级智能体的质量与效率权衡问题。该架构结合原始会话的情景记忆与提炼知识的派生记忆,通过插件自动读写、工具按需调用、离线“做梦”流程整合三种方式运作。在内部企业基准上,通过率提升至无记忆的三倍,同时token减少31%、速度提升26%;在开源基准上以约十二分之一token达到全上下文性能。
Databricks在Agent Bricks平台推出智能体记忆功能(Beta版),基于MemCurrent架构并运行于Lakebase。该功能通过自动记录上下文、按需调用工具及后台整合记忆三种方式,存储关键事实、偏好和工作流,以减少重复错误。内部测试显示,任务通过率提升约三倍,令牌用量减少31%。该功能已用于Genie,开发者可通过CLI快速部署。
本文介绍 Koog 1.3 的知识增强设施:Embeddings 模块通过 LLMEmbedder 生成向量,但 DeepSeek 客户端不支持嵌入,需搭配 Ollama 或云端服务;rag-base 定义存储抽象,rag-vector 提供文档向量化与检索原型,仅适合本地测试;检索可作为工具供 agent 按需调用,实现 agentic RAG;LongTermMemory 将检索与入库功能化,支持自动或手动模式,需注意分桶、去重与持久化限制;生产环境应基于 rag-base 自研向量库适配器。
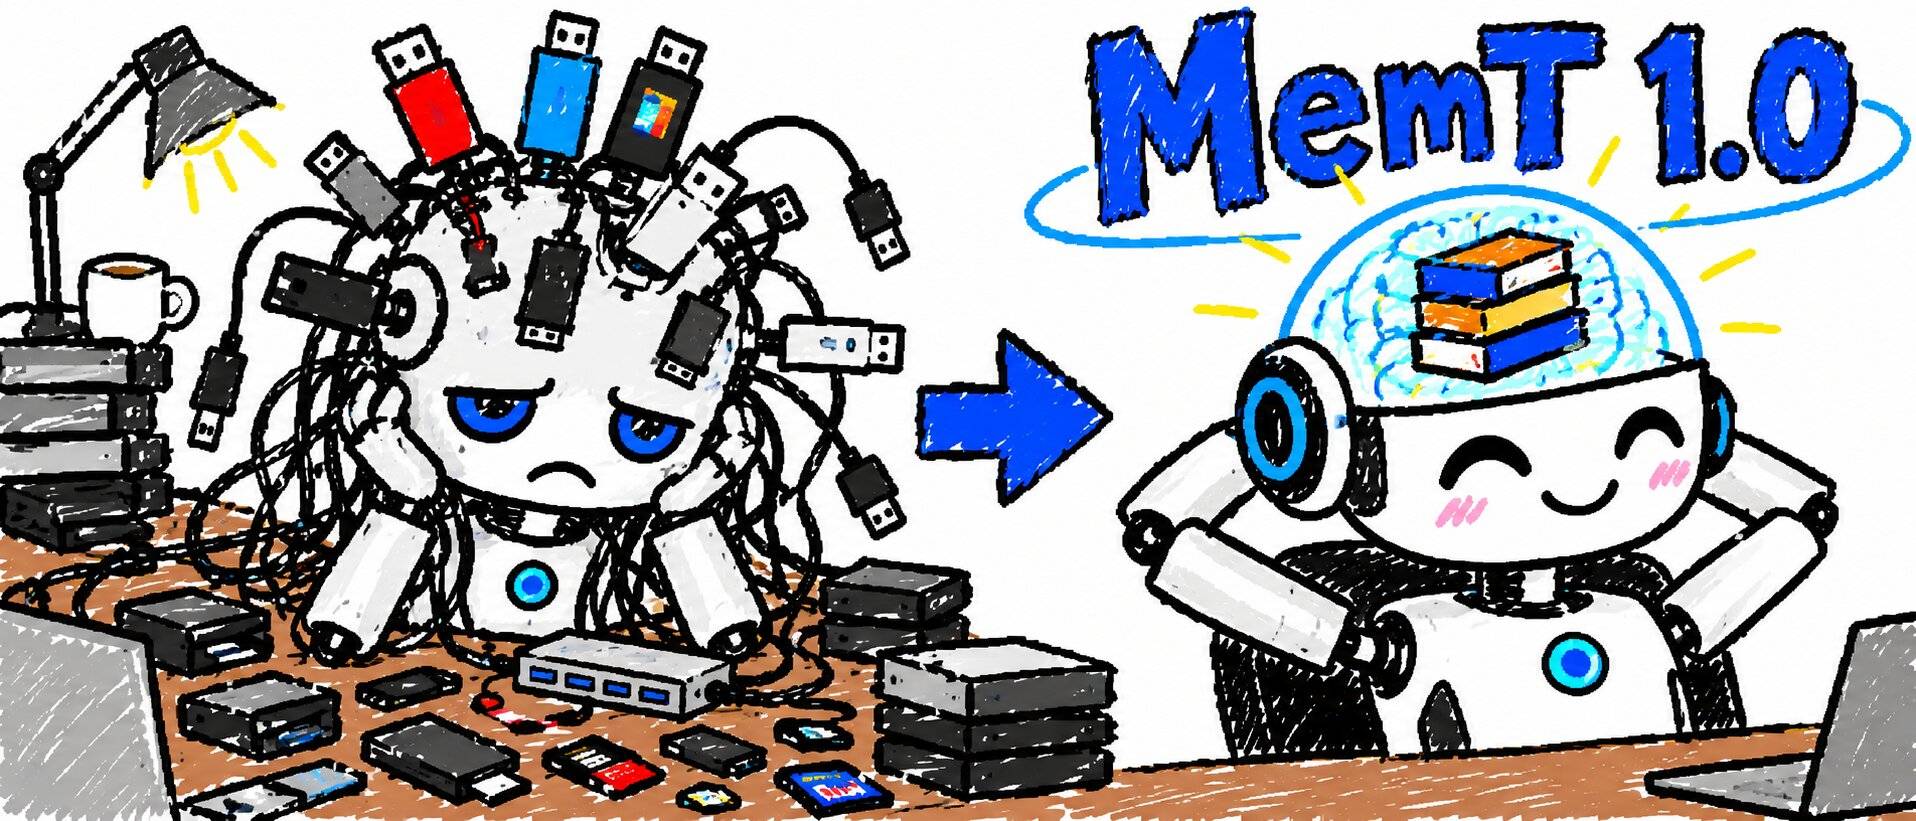
记忆张量发布开源记忆原生大模型MemT 1.0,将记忆内化进模型架构而非外挂检索。模型通过训练自主学会读写、更新和调用记忆,在长对话中能区分定论与备选、不编造未知信息;在编程任务中可将踩坑经验写入记忆并实时调用,提升任务成功率。其固定体积记忆状态显著降低长上下文推理成本,使AI在长期陪伴中越用越聪明。
完成下面两步后,将自动完成登录并继续当前操作。