丹麦数字化部试点以开源办公套件Collabora替代微软Office,仅在案件处理系统中测试,期间出现文档格式错乱、空白页面和修订追踪等问题。试点于2026年春季选举后悄然结束,官方确认无重启计划,原定评估未完成,也未发布汇总报告。
Scale AI 的 AgentEnv 框架现已支持在 Vercel Sandbox 上运行,用于测试智能体任务并评分。该支持从 AgentEnv 0.9.1334 版本起提供,智能体与任务环境分别在独立沙箱中运行。用户可通过 Vercel CLI 登录并指定团队和项目,运行示例评估并查看得分与操作记录。
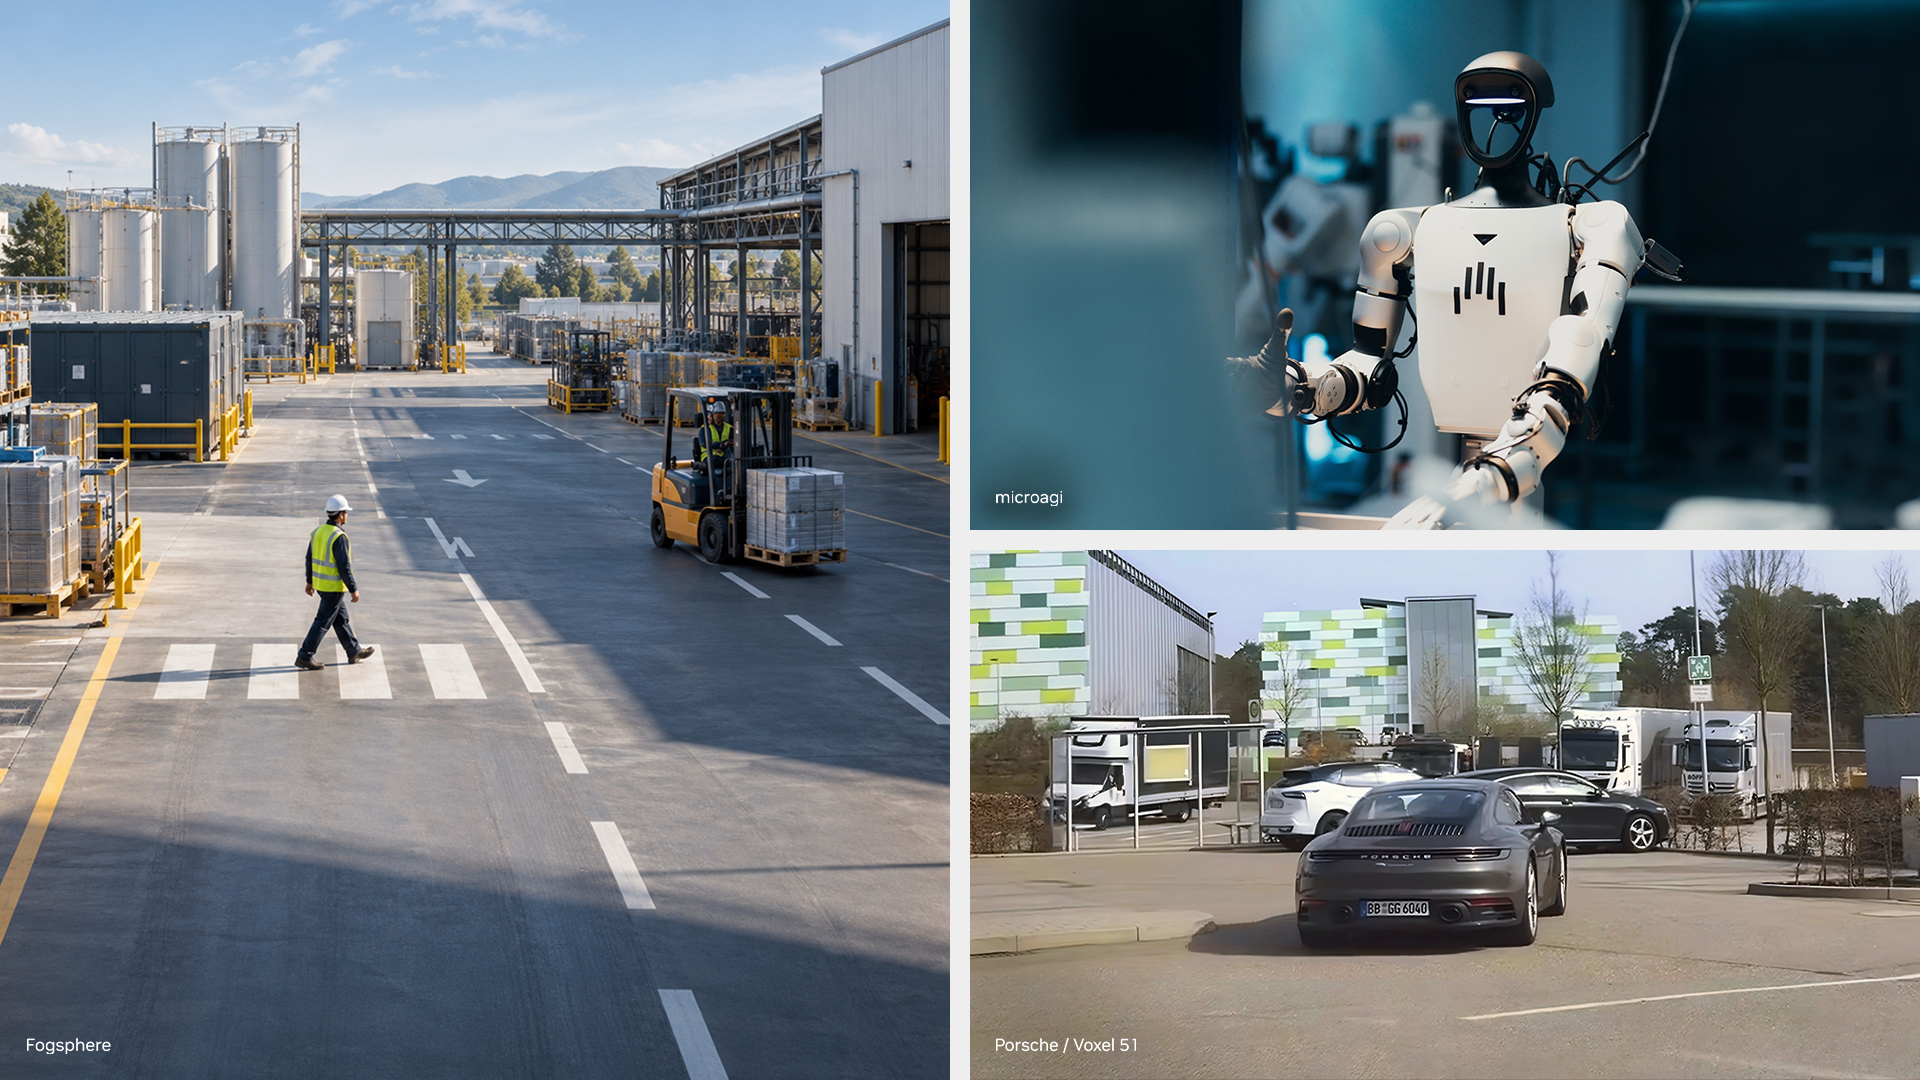
英伟达扩展Cosmos平台,新增训练工具、仿真检查点和数据工厂蓝图,帮助开发者更高效地训练、评估和部署世界模型。Cosmos数据工厂提供五类云端蓝图,用于自动驾驶、缺陷检测等合成数据生成;框架支持微调、强化学习、蒸馏和量化。保时捷、ANYbotics等已应用,可大幅减少实车测试并缩短开发周期。
陶哲轩发短文称,“First Proof”将于美东时间今日下午3点在ICARM主办的线上研讨会公布第三批评估结果,需注册参加。
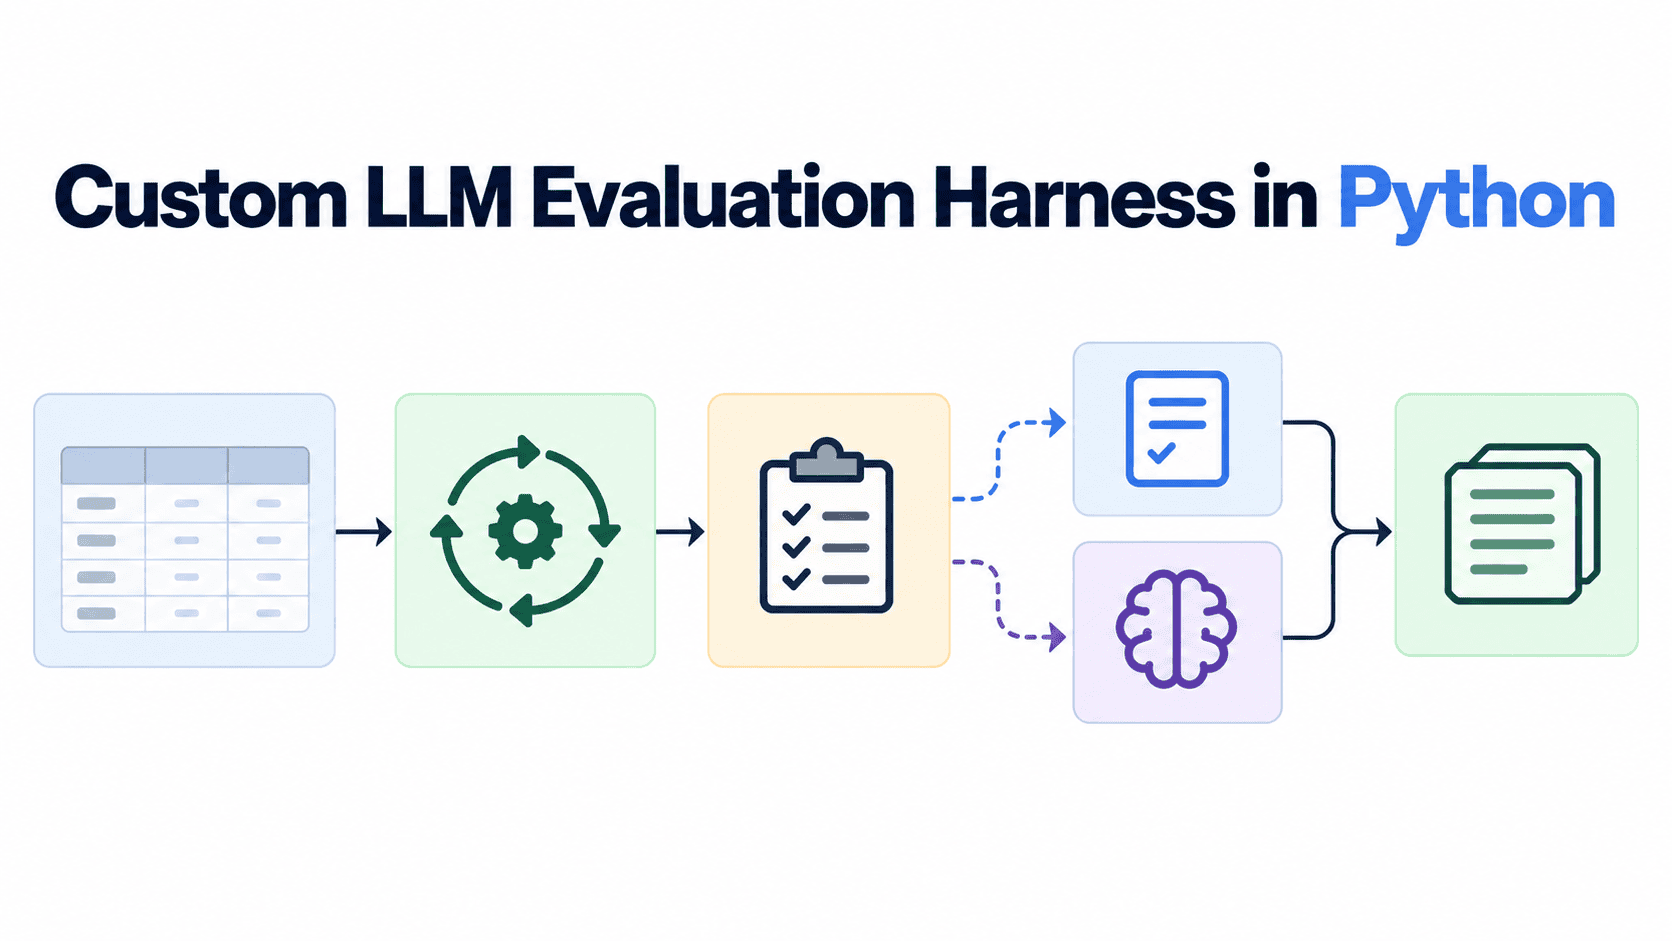
本文介绍如何用 Python 从零构建自定义 LLM 评估工具,包含四个模块:黄金数据集(基于真实用户输入和已知失败案例)、异步推理运行器(用 LiteLLM 调用模型)、评判层(确定性匹配或 LLM 评判,用 Pydantic 约束输出)、日志记录(追加写入 JSONL,崩溃安全)。推理与评分分离,便于重新评分而无需重跑 API。还给出温度设 0、并发限制、先确定性后 LLM 评判等排错建议。
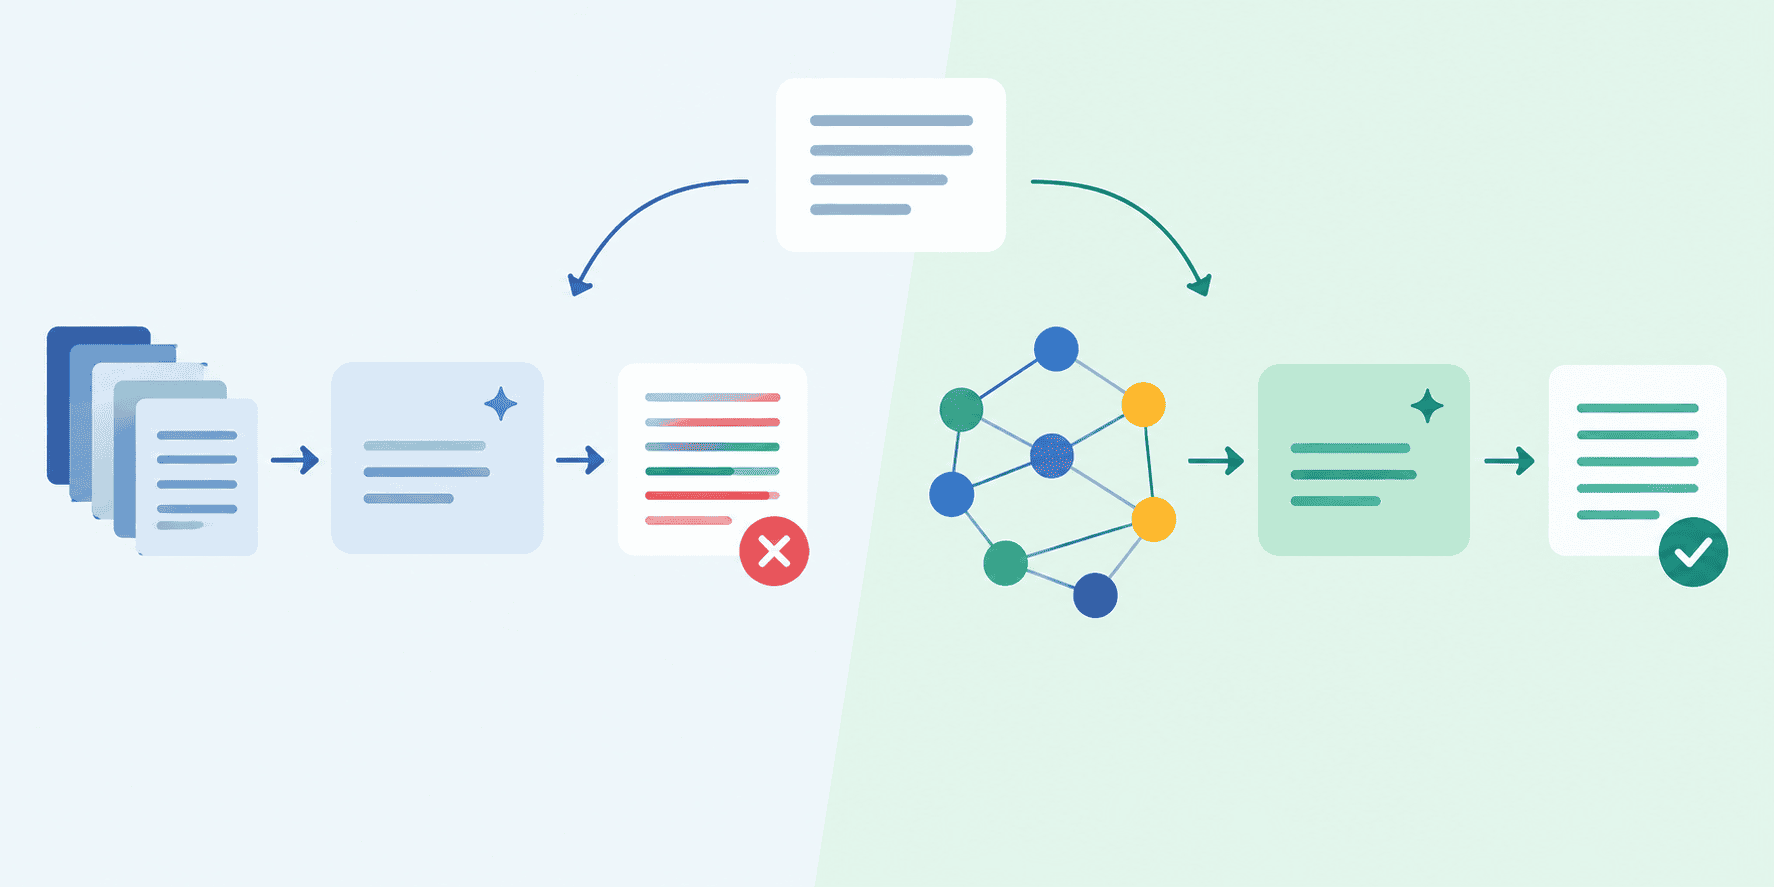
本文对比标准向量RAG与三层Graph-RAG在事实密集型查询中的幻觉表现。作者用合成篮球数据构建基准:图数据库存真实数据,向量库存含矛盾数字的噪声文本。使用Flan-T5-base模型测试50个查询,标准RAG准确率为96%,Graph-RAG为92%。结论是复杂冲突消解提示需更强模型,小模型反而表现更差。
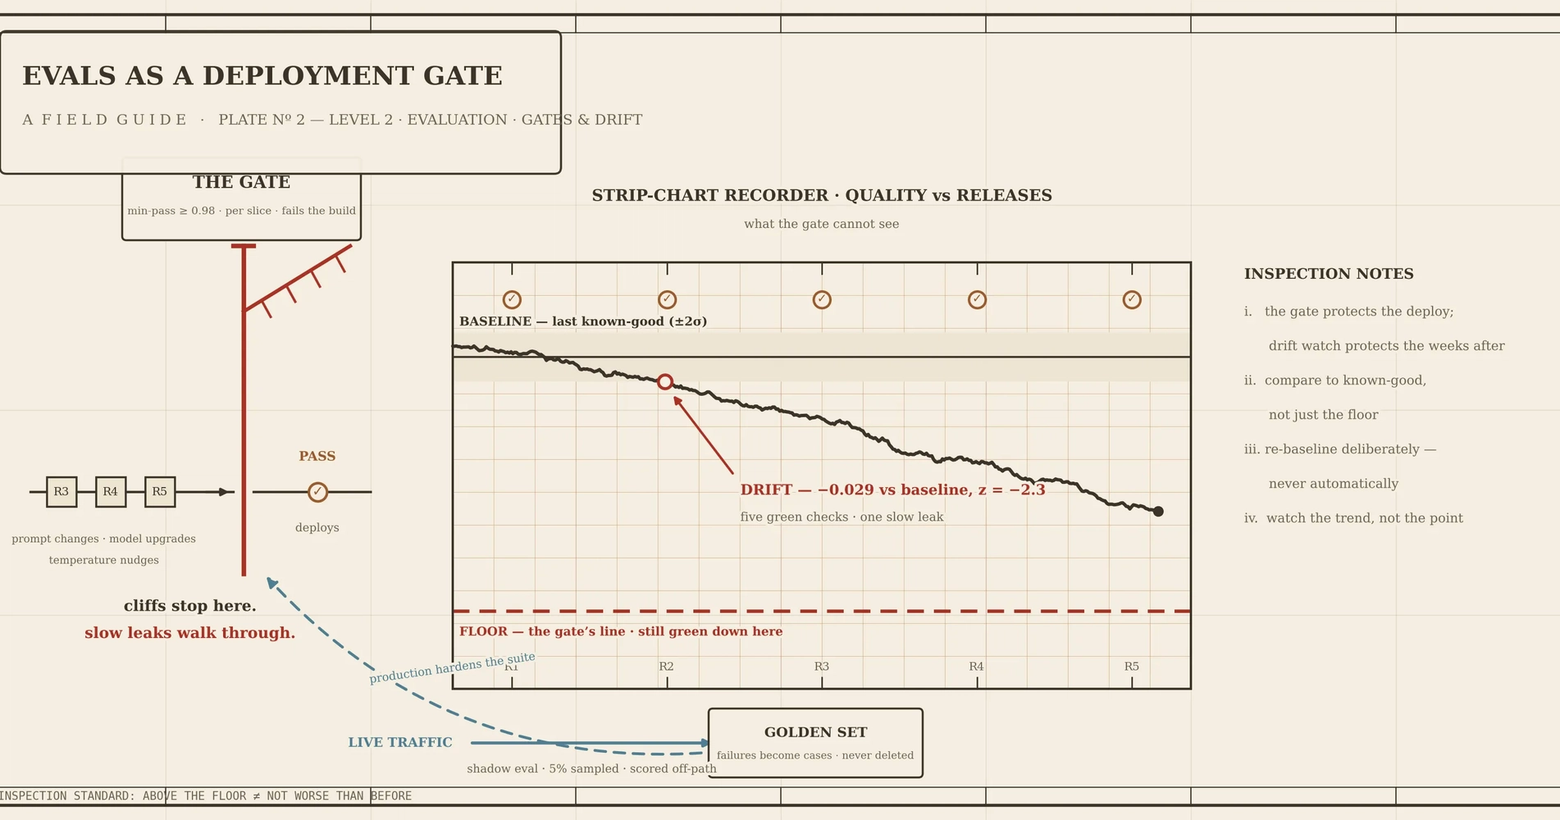
主张将LLM评估作为CI部署门禁,用版本化黄金用例、显式评分器和按切片路由在构建时拦截回归。门禁只能发现骤降,无法捕捉缓慢漂移,因此需对照已知良好基线做显著性检验,并对线上流量抽样做影子评估,监控人工覆盖率和置信度趋势,将失败案例回补进黄金集。
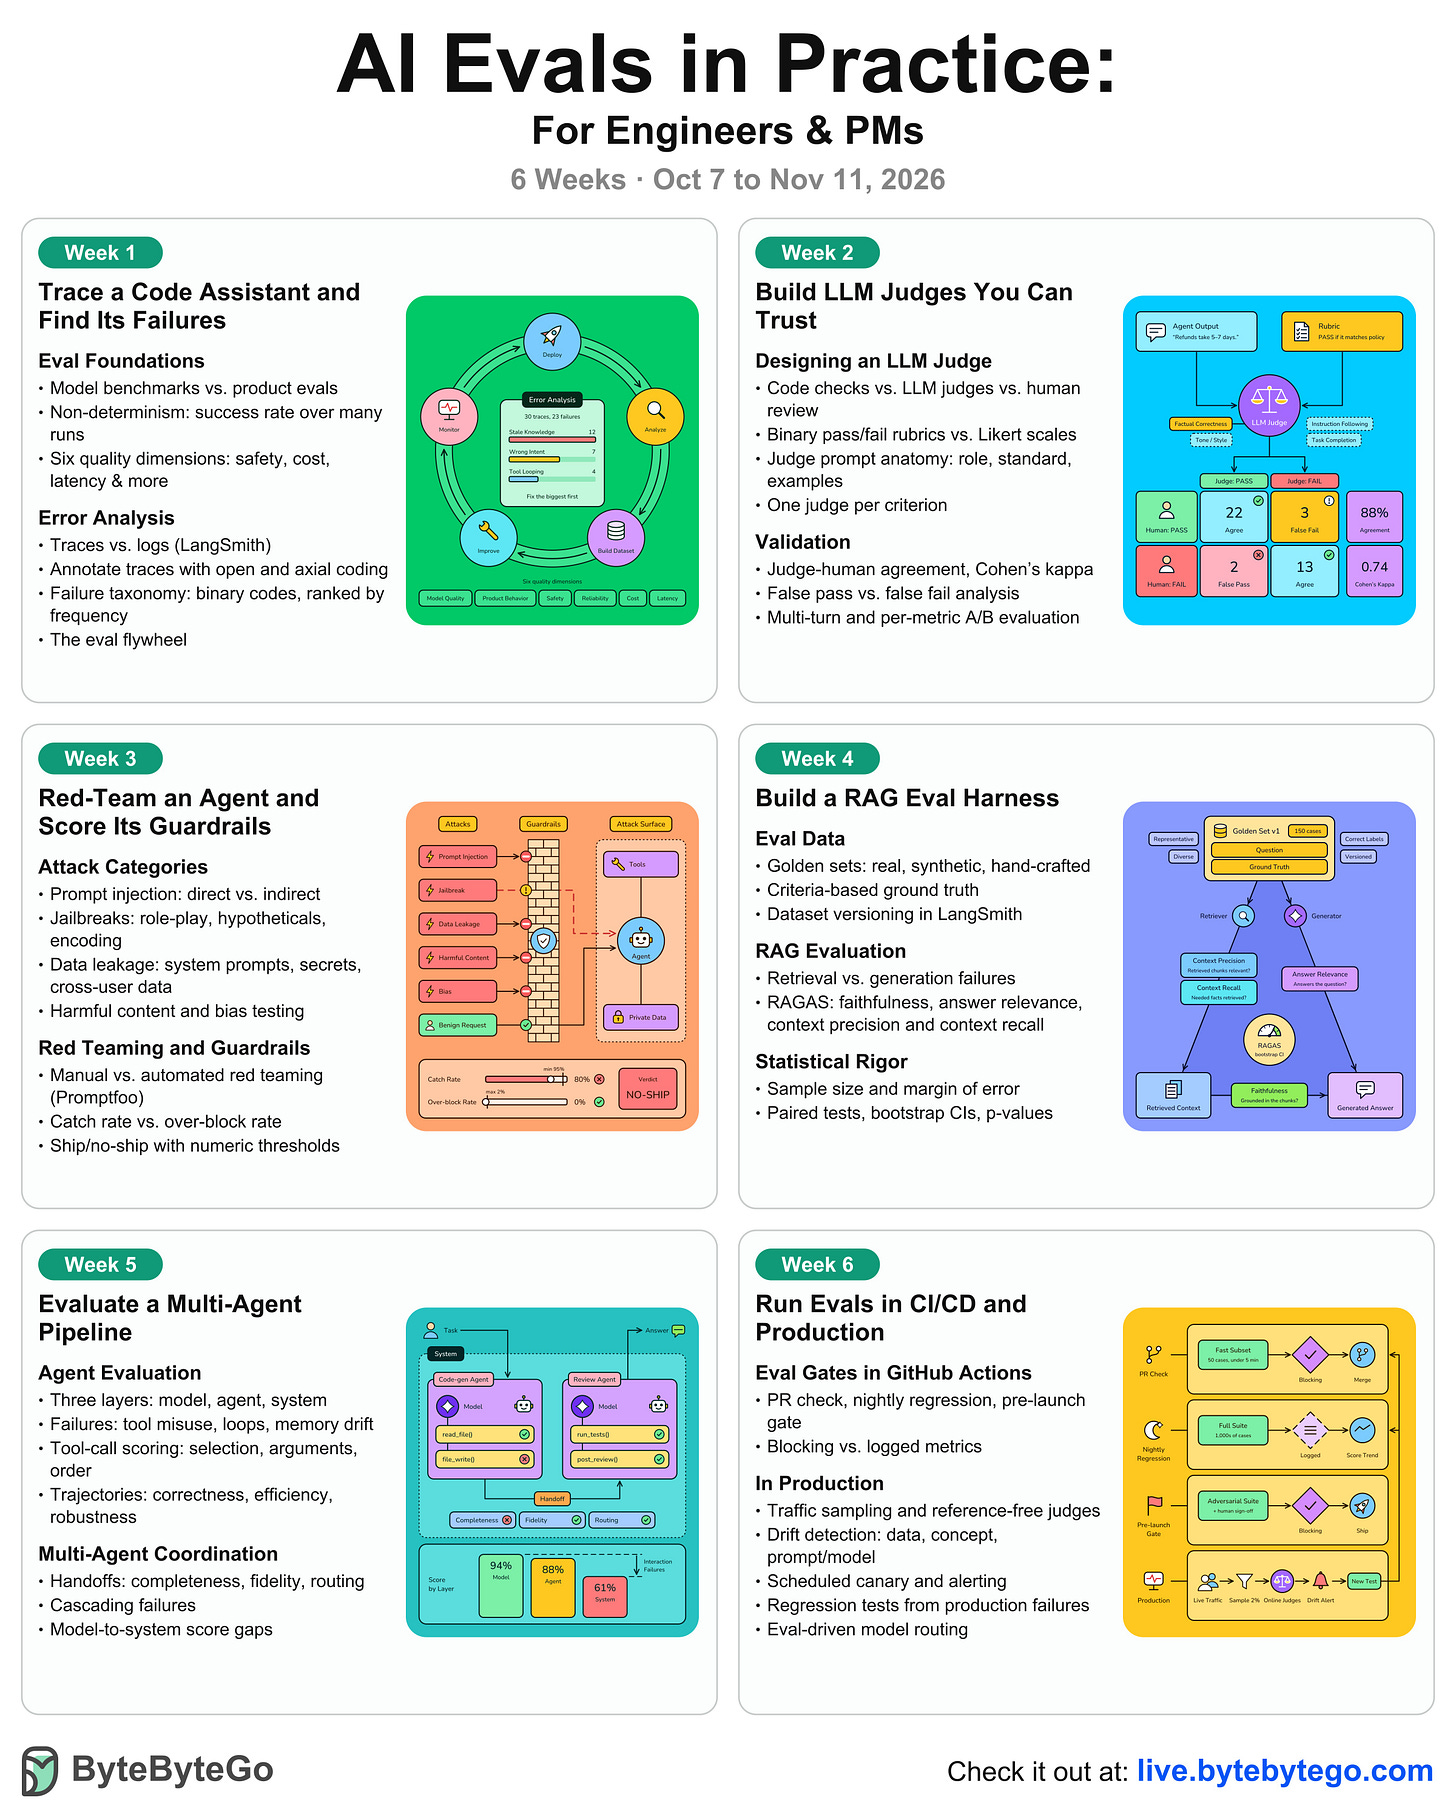
ByteByteGo与Salesforce的Manjeet Singh合作推出AI评估实战课程,报名3天后截止。课程讲解如何为生产级AI智能体构建可靠评估系统,内容包括质量、安全、成本与延迟评估设计,LLM-as-a-Judge系统,红队测试,评估数据集构建,工具调用、RAG、多步执行与多智能体评估,以及CI/CD和生产环境评估。
NVIDIA发布Kumo Tabular表格基础模型,将标注行作为上下文,一次前向即可预测,无需逐任务训练。模型参数28M至215M,官方称四组评测第一、快17倍,但真实分布漂移时准确率会下降。作者认为它更适合冷启动基线,而非直接替代成熟风控模型,上线前须做校准、漂移监控与时间留出门禁。
SCLATE是一个持续学习智能体的训练与评估执行基座,通过适配器让基准测试与未修改的智能体共享事件调度器,并用混合模拟时钟压缩长周期场景。研究移植了七个基准、对比十种配置,发现额外记忆系统未必优于原生记忆。经后训练,Qwen3.5-4B读取文件行数减少6.8倍,SWE-bench通过率提升16.7个百分点。
Jev与Laya是两类结构化决策模型:Jev为托管API,Laya为开源权重。JevBench基准中Jev综合分74.4领先,但Laya为零样本测试,且基准由Jev方维护。选型需评估上下文长度、多语言、校准误差、延迟与自托管成本。数据合规场景下,Laya可内网部署,是唯一解。建议按六步评估法实测后决策。
企业AI应用开发平台选型应围绕部署、模型、成本、行业、合规五个维度,而非单一功能指标。主流平台分为四类:Coze偏轻量对话,Dify偏企业级开发,n8n偏流程自动化,模力方舟偏模型统一纳管与国产算力适配。模力方舟提供200+模型接入、私有化部署及信创合规能力,适合关基行业。选型建议遵循场景定义、部署评估、模型验证、成本核算、POC测试五步流程。
选择AI训练算力平台不应只看GPU型号或跑分,而应以达到目标精度的总成本、资源利用率、排队稳定性、迁移与生态适配为核心,并区分预训练、微调、推理等任务,重点评估利用率、异构调度效率、部署成本与迁移平滑度。模力方舟提供模型托管、算力调度、应用开发一站式服务,可纳入候选,但须用自有模型实测验证。
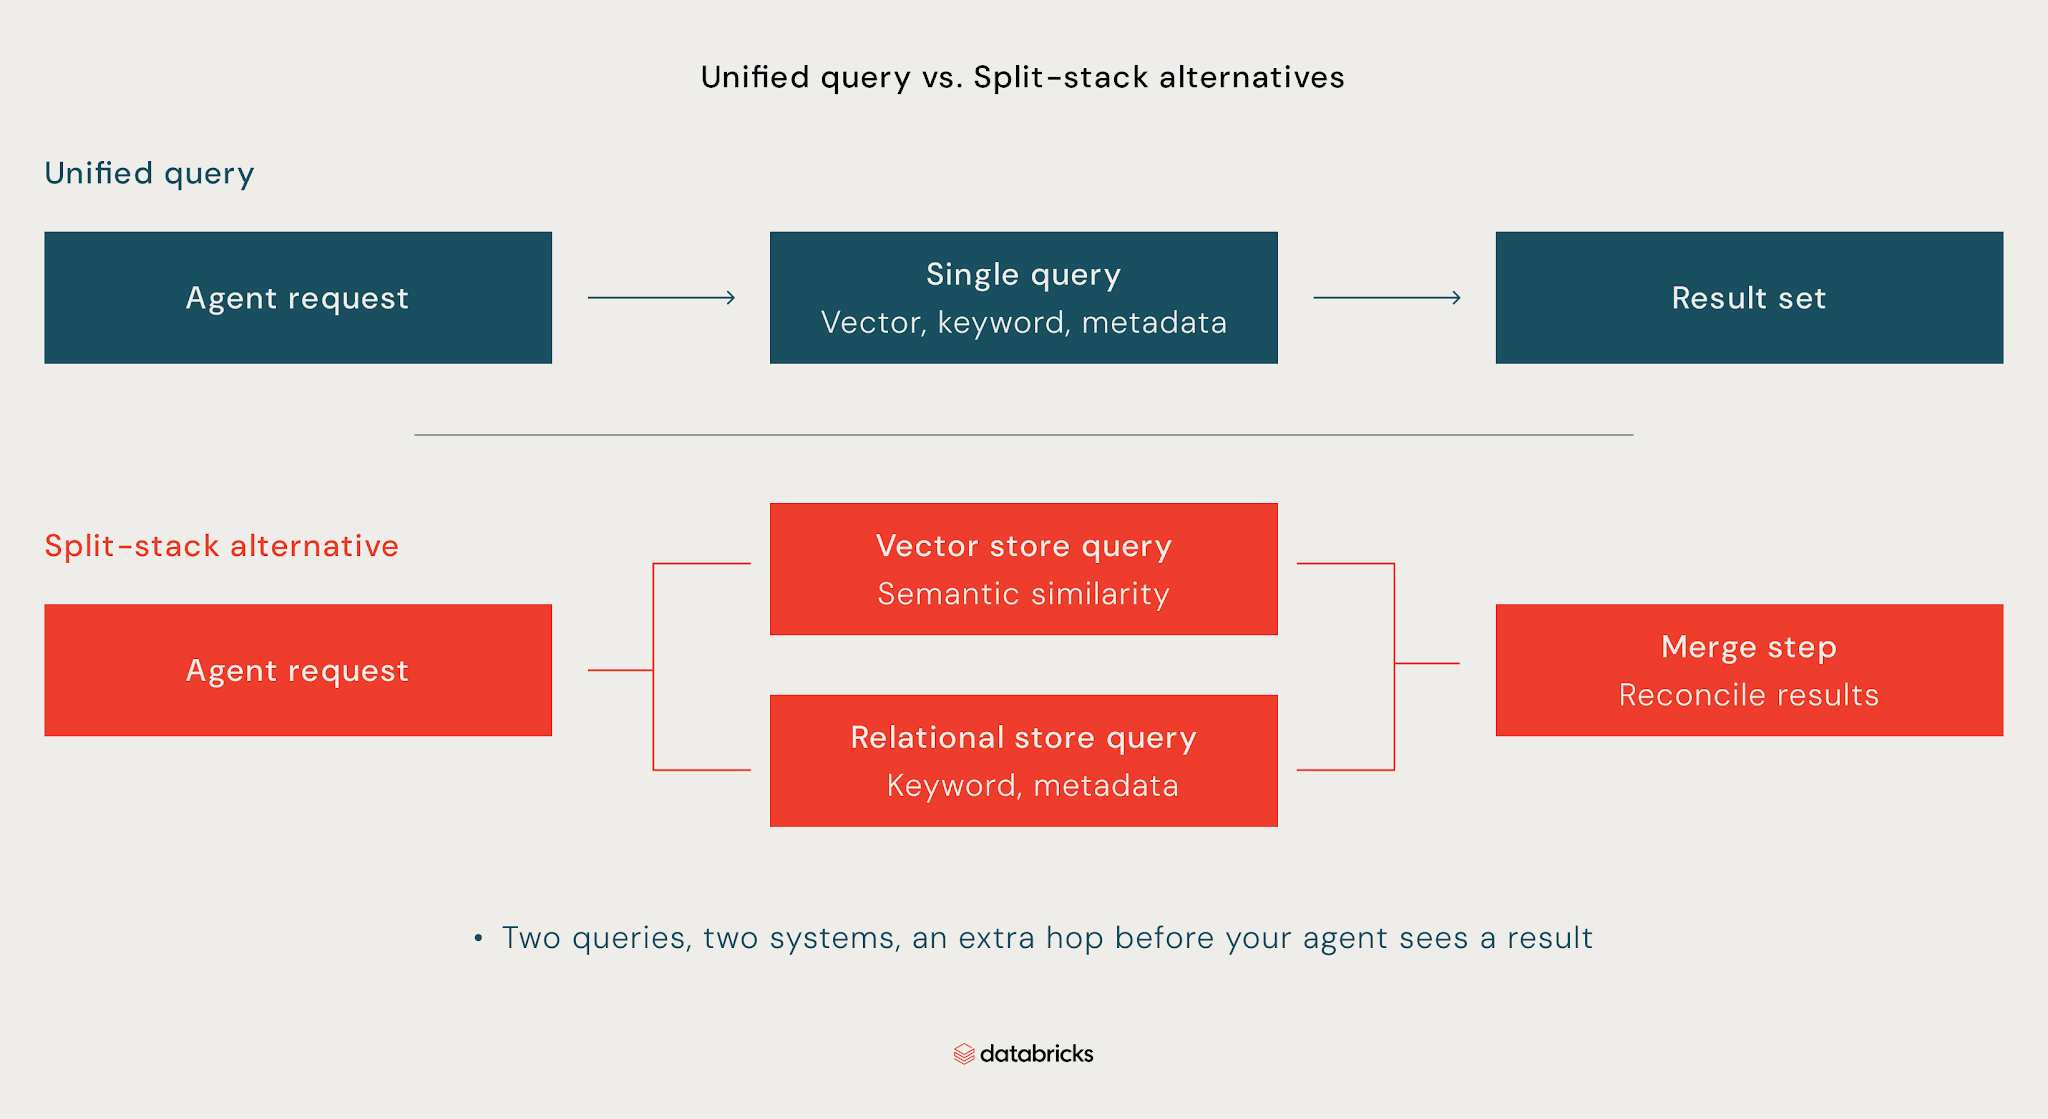
评估AI代理数据库的五大标准:分支隔离、无服务器扩展、混合搜索、ACID保证和统一平台访问。代理需跨会话持久化状态与记忆,支持并发读写;传统数据库易致记忆过时、写入冲突和高延迟。混合搜索结合向量、关键词与元数据过滤,检索需低于100毫秒。多代理共享数据时,事务隔离与原子提交至关重要。统一平台让运维与分析共用同一数据,避免ETL延迟。
2026年中小企业AI选型应围绕场景匹配、部署灵活、模型丰富与信创合规四条主线,而非单纯比较功能。主流平台分为Token工厂型(模力方舟)、低代码/开源型(扣子、Dify)和生态型(腾讯元器、通义千问)。建议按“场景驱动→合规验证→试点落地→规模扩展”推进;敏感数据选私有化部署,预算有限选Serverless按量计费。
本文介绍如何使用 Percona Operator for MySQL 实现 MySQL Group Replication 的跨集群 DC-DR 部署,将单集群架构扩展为数据中心与灾备双集群架构,以提升高可用性和容灾能力。
系统集成商选AI平台应关注多模型接入、应用集成、私有化交付与权限治理闭环,而非模型参数。模力方舟提供Serverless API、私有化部署和智算一体机三种路径,支持Kimi、GLM、DeepSeek等模型。选型需优先验证企业级交付与治理能力,并以PoC实测为准。
Anthropic CEO Dario Amodei 呼吁加强前沿AI监管,建议允许第三方评估员常驻各公司核查安全实践,获Altman、Musk、Hassabis、扎克伯格赞同。METR等机构正招聘此类评估员,年薪最高约68.7万美元,要求极高。专家强调评估员须有足够权限发现隐患,否则只是多一层流程。
AI代理评估比单轮LLM更难,因多步推理与工具调用会累积错误。应分层评估推理、行动与执行结果,使用清晰可测任务和匹配的评分器(确定性、代码、模型、人工)。保持环境隔离、多次试验,关注pass@k与pass^k,并阅读对话记录。将评估自动化接入开发流程,结合监控形成持续反馈闭环。
系统集成商选择AI平台应重视交付与治理,而非仅关注模型效果。2025年中国企业级AI智能体市场规模达212亿元,约六成企业仍处于试点阶段。模力方舟提供Serverless API、私有化部署和智算一体机三种路径,支持多模型接入与信创适配,可作为备选方案,但需试点验证。
完成下面两步后,将自动完成登录并继续当前操作。