本研究探讨大型语言模型(LLMs)在表格数据推理中的能力,指出现有评估策略无法真实反映其性能。改进评估后发现,LLMs在缺失值、重复实体和结构变化等情况下的推理能力显著下降,强调了提升鲁棒性的重要性。
本研究针对动作识别模型在指导视频中的序数偏差问题,提出了动作遮罩和序列洗牌方法,并强调改进评估策略和开发灵活模型的重要性。
本研究探讨了人工智能与信任在网络安全中的关系,提出了信任评估策略和治理框架,发现动态管理信任能够通过人工智能构建韧性安全生态系统。
本文综述了基于大型语言模型(LLM)的智能代理研究进展,探讨其在社会科学、自然科学和工程领域的应用及评估策略,分析LLM与传统代理的区别、核心组成部分及记忆机制,提出AgentQuest和AgentGym框架,并展望未来发展方向和挑战。
该文综述基于大语言模型(LLM)的智能体研究:用LLM教师指导训练小规模学生智能体以提升样本效率;将LLM应用于多智能体系统、ARC推理、符号推理及Minecraft任务,并借助环境反馈迭代改进;从博弈论与强化学习视角重构LLM训练过程,探讨对齐问题;综述其在社会科学、自然科学和工程领域的应用、评估策略及未来挑战。
该文综述基于大语言模型的智能代理研究,涵盖TrainerAgent、KwaiAgents、PAgents等系统,涉及任务规划、多代理协作、专业服务与推荐系统应用,并探讨评估策略、挑战及未来方向。
本文综述了可解释推荐的评估策略,提出了不同分类方法,并分析了现有评估方法的优点和缺点,并提供了选取它们的指南。通过分析100多篇论文,提供了关于可解释推荐的全面评估综述。
本研究通过大规模采样在解码阶段引入 PassUntil 评估策略,发现了突现能力的具体证据,并提出了一种新假设,推翻了有关突现能力产生的常见假设。
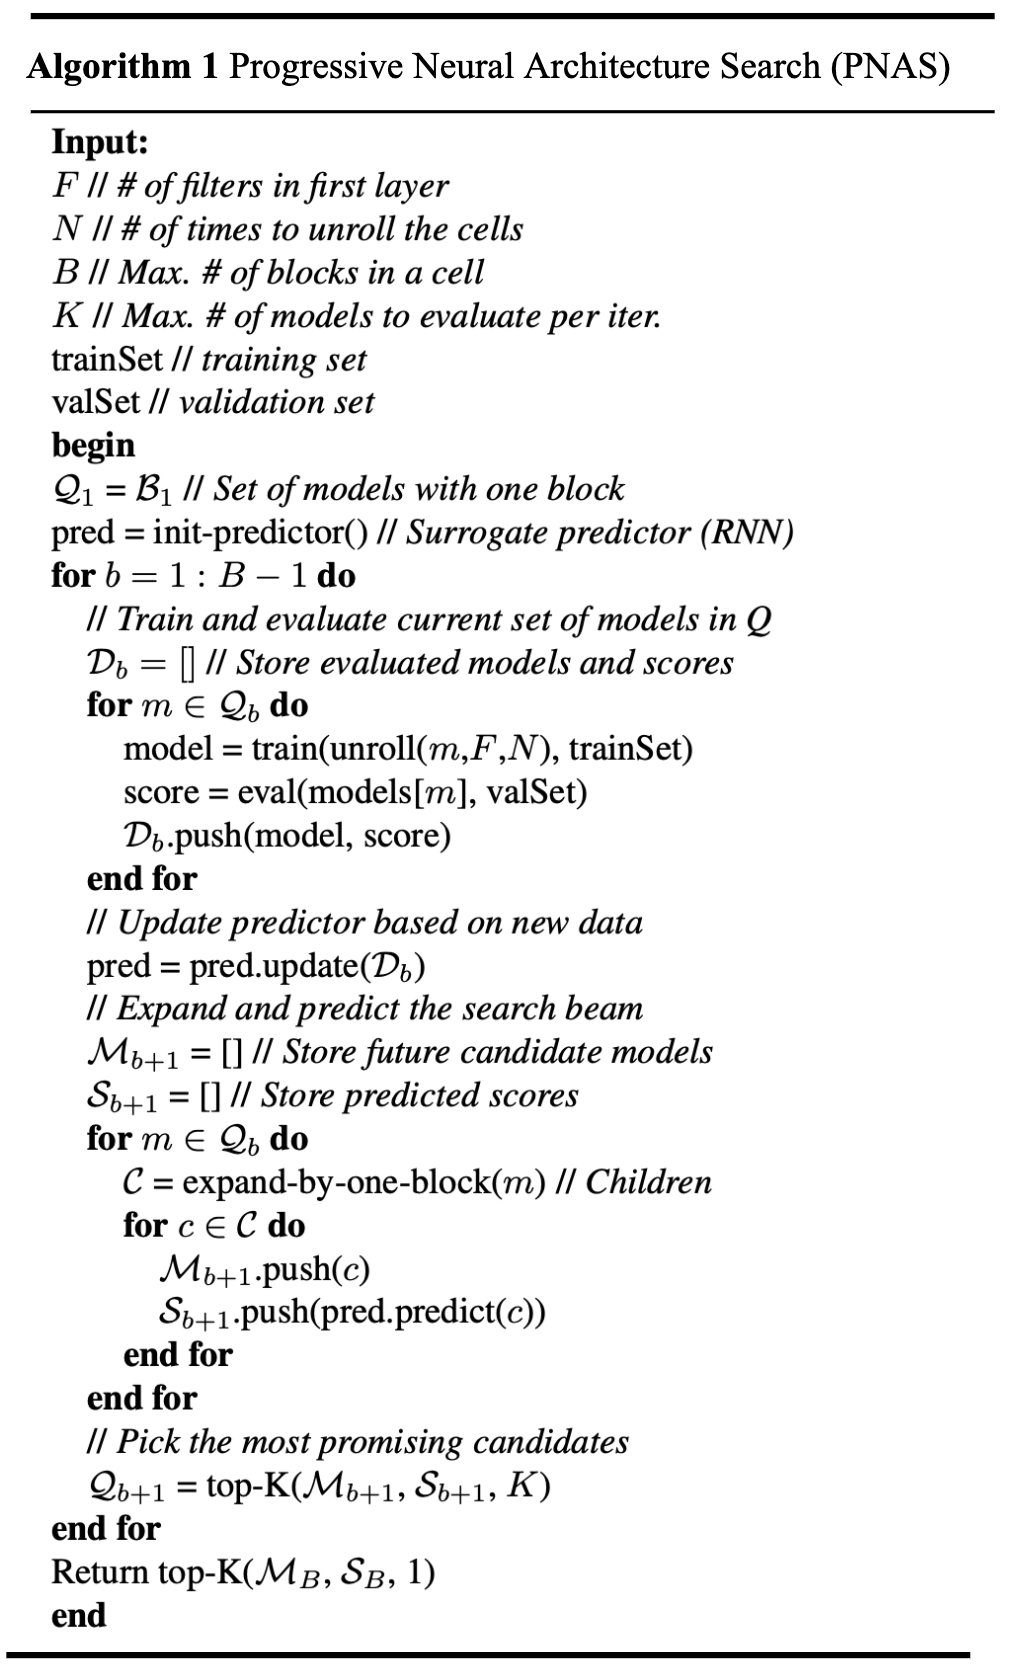
神经架构搜索(NAS)自动学习高性能网络结构,包括搜索空间、搜索算法和评估策略。搜索空间从逐层序列演进为基于单元、层次化和记忆库表示;搜索算法有随机搜索、强化学习、进化算法、渐进决策和梯度下降;评估策略通过代理任务、参数共享、预测权重及一步式搜索加评估来降低计算成本。
完成下面两步后,将自动完成登录并继续当前操作。