FunAsrNet 是纯 C# 实现的语音推理项目,基于 .NET 10,不依赖 Python、ONNX Runtime 等原生框架,自行实现模型加载、算子、解码、VAD 和中文 TTS。性能上,CPU 语音识别接近原版 C++,ARM64 上快 15%–27%,但 GPU 仍落后数倍。项目文档如实记录差距与失败,价值在于证明 .NET 可承载完整语音流水线,便于审计、维护和部署。
文章介绍如何用Scikit-LLM结合大语言模型实现命名实体识别(NER):以Groq免费API为例,配置自定义实体字典(如高管、公司、产品、城市),用GPTExplainableNER从科技商业文本中提取结构化实体,并用正则表达式清理输出。结果表明,无需从零训练模型,仅少量配置即可获得不错效果。
shadcn-admin 是基于 Shadcn 和 Vite 的管理仪表板,支持亮/暗模式和响应式设计。MinerU 是开源的数据提取工具,支持多种文件格式。opentelemetry-cpp 是 C++ 的 OpenTelemetry 客户端,支持日志和追踪功能。extensions 是 Zed 编辑器的扩展集合,BricksLLM 是企业级 API 网关。
由Sam Altman支持的World项目在Zoom应用市场上线“World ID for Zoom”,通过Orb虹膜扫描、实时自拍和视频画面验证参会者是否为真人,并显示“真人徽章”,以应对AI深伪冒充诈骗,保护敏感对话。
文章介绍用Java 17为视觉识别票据金额设置安全门禁:模型只负责提取字段,Java用BigDecimal、币种白名单和金额上限判断能否进入人工复核,避免浮点误差与误报销。代码无需外部依赖,并强调超时、幂等、原图留存与审计,适合低风险票据预分流,不适用于自动付款或税务认定。
iPhone 18 Pro系列被曝面容识别失败后重试时,会出现触控失灵、系统卡死、自动重启等问题。故障多发于用Face ID解锁密码应用、Safari隐私标签等受保护内容时,故意遮挡面部触发失败后再次尝试即可复现。用户猜测与传感器布局或iOS 27逻辑有关,苹果暂未回应,预计将通过系统更新修复。
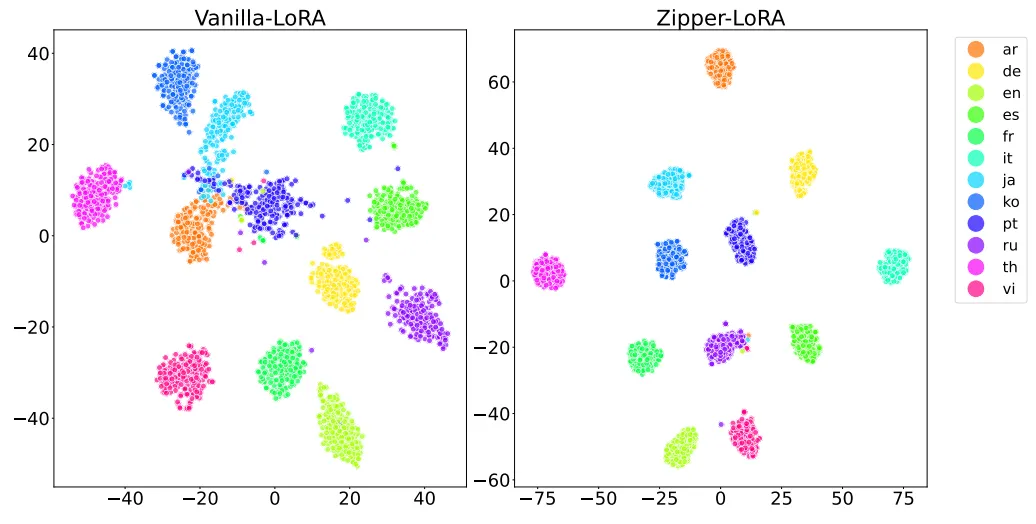
针对Speech-LLM多语种识别中共享LoRA参数引发的跨语言干扰,本文提出Zipper-LoRA框架,将低秩空间解耦为共享Rank与语言特有Rank,并结合动态路由与Initial-B热初始化。在12种语言上的实验表明,该方法显著降低低资源语言错误率,性能优于现有LoRA方案,已被TASLP 2026接收。
小米开源CocktailASR-1,聚焦目标说话人语音识别:指定要识别的说话人后,模型只输出该人内容,而非还原全部声音,更贴近会议、车载、客服等场景。文章提醒,demo效果好不代表可上生产,需关注提示音频采集、设备与音色变化下的稳定性、低置信度处理,以及监控、回滚和真实噪声样本评估。
文章讨论了AI生成文本的识别问题,指出人类难以区分AI与人类写作。介绍了NVIDIA的AVO系统,通过持久记忆和监督机制提升长期任务效率。探讨了AI对CI流程的影响,强调CI是实践而非仅服务器。最后指出AI设计生物系统的难度被夸大,并提到AI生成内容中虚构专家名字的重复现象。
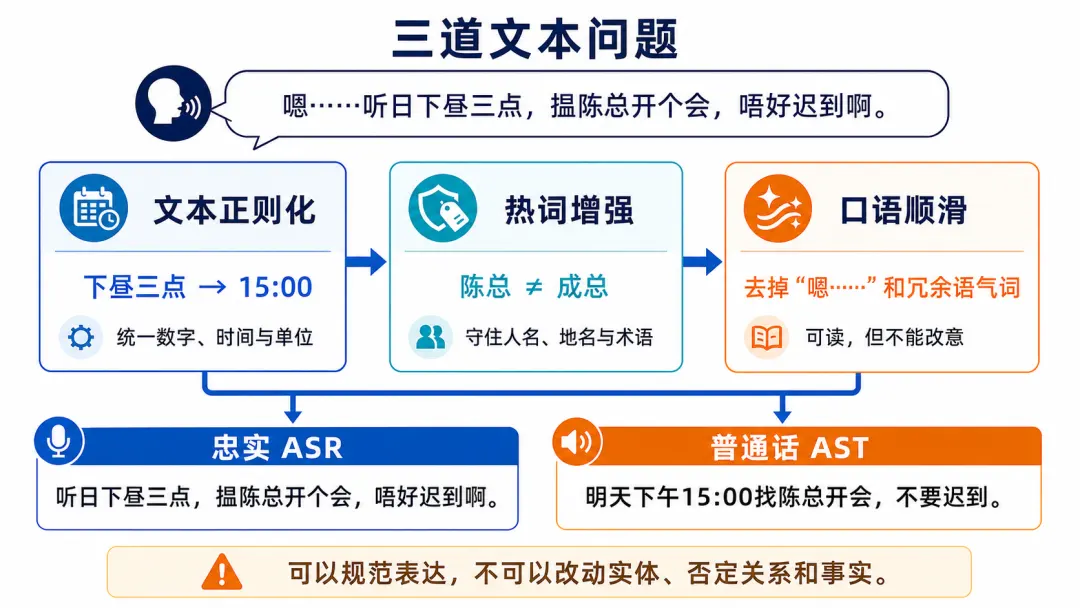
方言语音识别不仅需听清发音,还需决定如何书写。难点分三层:声音、词汇语法和书写。大模型能提升能力,但需区分忠实转写与方言转普通话两种任务,并处理文本正则化、热词增强和口语顺滑。系统应分层建模,分别评价,以尊重方言原貌并满足不同场景需求。
本文首次将迭代伪标签训练法应用于中英混合语音识别(CS-ASR),利用未标注数据提升性能。方法分三阶段:生成伪标签、两阶段双语模型训练及迭代优化。在SEAME数据集上,devman和devsge子集词错误率分别降低6.35%和8.29%,显著提升复杂混合场景识别精度。
苹果申请了一项默声语音检测专利,通过光学传感器捕捉面部肌肉微动,经神经网络解码为文字并合成语音,延迟低于100毫秒。系统支持耳机或眼镜集成,可离线或分布式运行,并强调低延迟音频反馈以确认识别结果。该技术路线已有先例,核心创新在于本地反馈和硬件架构。
本文探讨了代理型AI循环中隐藏的令牌成本问题,指出成本会非线性复合增长。文章列举了五种成本陷阱:O(N²)上下文累积、无界重试循环、未过滤工具负载、单一模型路由和静态系统提示重复。解决方案包括上下文压缩、断路器、负载过滤、动态模型路由和运行时提示注入。最后强调应将上下文视为受限资源,从第一天起就进行管理。
文章介绍了一种将扫描版PDF中的表格和示意图提取到EPUB的方法。通过AI模型PicoDet-S_layout_3cls,在CPU上运行,可快速识别并标注这些元素。实测500页图书仅需9.5秒,平均每页17毫秒,效果显著。该方案被推荐为扫描版PDF转换EPUB的最佳整体解决方案。
腾讯发布新一代语音识别模型Hy ASR 3.0 preview,基于大语言模型Hy3,融合高精度识别与语义理解,在通用识别、方言、上下文感知等维度提升。在开源和自建评测中WER领先,中文普通话3.34%、英语2.62%、粤语3.12%。已上线腾讯云API,元宝App免费体验。
腾讯混元发布新一代语音识别模型Hy ASR 3.0 preview,基于Hy3大模型提升通用识别、方言覆盖、上下文理解及复杂环境鲁棒性,在开源和自建评测中WER表现领先。支持热词注入,适配专业场景,已上线腾讯云API,并集成于元宝App,免费提供语音输入服务。
对话式语音识别(CSR)正取代传统自动语音识别,通过理解对话的实时展开、轮流发言和时机,实现低延迟响应。它支持多语言切换,已在客服、医疗、金融等领域应用,推动人机交互更自然、更人性化,成为下一代语音AI的基础。
Oracle的Java团队讨论了值类的预览特性,指出这些类在JDK库中的广泛采用存在挑战。为帮助用户应对迁移问题,JEP提供了一些值类的“入门工具包”,并识别了在启用预览特性时可视为值类的JDK类。
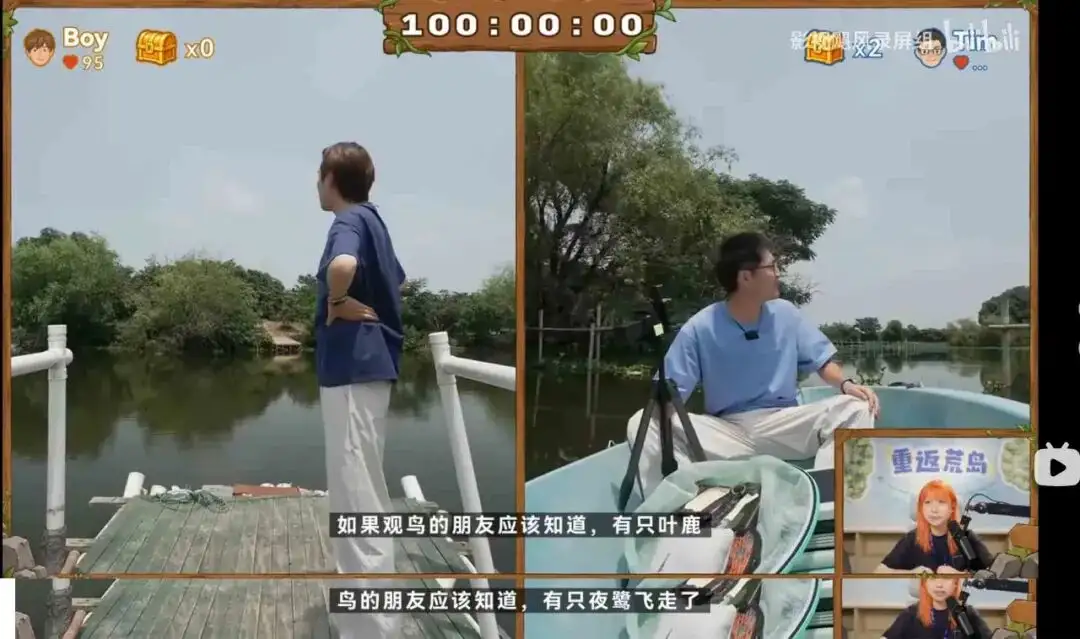
阿里通义推出了实时语音识别模型Fun-ASR-Realtime,具备百毫秒首字延迟和高准确率,支持16种方言和30种语言。在“重返荒岛”直播中,该模型提供实时字幕,识别准确率接近离线模型,适用于国际会议和客服等复杂场景。
智慧零售通过实时音视频技术提升门店运营管理。即构科技提供的解决方案包括自定义视频采集、低带宽监控模式和多房间管理,满足从单店到千店的实时管理需求。
完成下面两步后,将自动完成登录并继续当前操作。