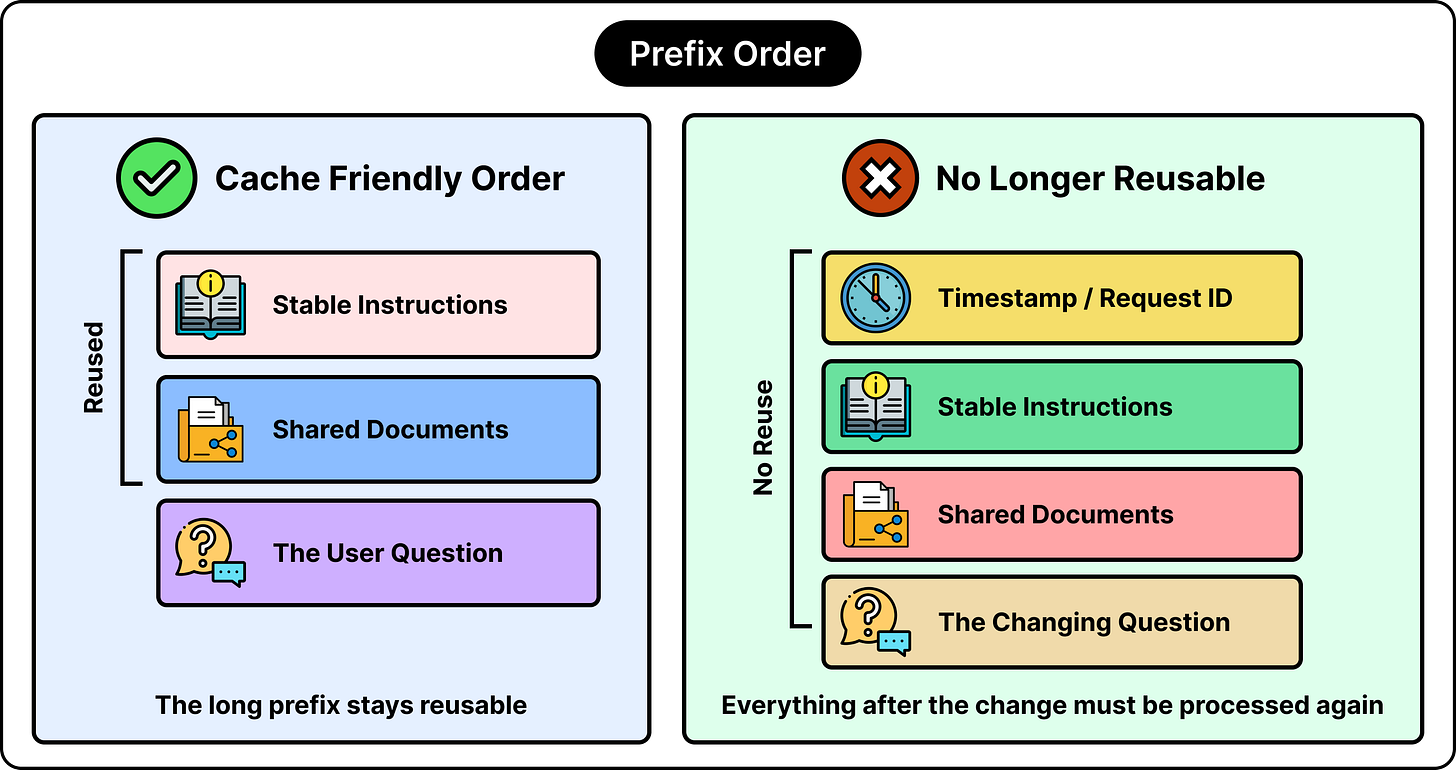
文章比较了LLM应用中的提示缓存与语义缓存。提示缓存复用请求开头共享内容(如指令、产品手册)已计算的KV状态,要求前缀完全一致,可降低输入处理成本,但输出仍需重新生成。语义缓存用嵌入模型匹配相似问题并复用旧答案,难点在相似度阈值:过严漏掉改写问题,过松返回错误答案,且需结合用户、权限、版本等元数据过滤,并靠TTL、版本化等策略失效缓存。两者可互补:先查语义缓存,未命中再调用LLM并利用提示缓存。
本文介绍为RAG流水线构建语义缓存:用Qdrant存储历史问题向量,命中则跳过知识库检索和LLM调用,节省时间与成本。相似度阈值需按用例校准,建议用金标集划分训练、验证、测试集调优。高阈值只能覆盖近似重复问题,可用Jev分类器处理灰色地带。缓存需设置过期时间,并在源文档变更时失效。
Flex-π 是华盛顿大学与英伟达提出的 60 亿参数世界-动作模型,旨在调和 VLA 与 WAM 之争。它用单一冻结 VAE 同时编码 RGB 与 3D 点图,用 DINOv3 提供物体语义,经 Mixture-of-Transformers 融合。训练时随机掩蔽视觉流并施加跨模态强制,使单一权重在推理时可灵活选择快慢路径,兼顾实时性与泛化,无需额外传感器或重训先验。
论文提出Show-Harness具身控制框架,使视觉语言模型通过离散语义动作单元直接操控机器人,无需微调即可零样本控制,少量微调可适配小模型;并提出GUMI界面,支持人类与智能体在统一动作空间采集示教数据,实现跨形态复用与协同采集。
2026年,四人团队开源了Whiteboard,通过画布、语义化差异查看器和决策日志帮助理解AI生成的代码。它可接入Claude Code等智能体,点击图表跳转源码,语义差异仅显示关键变更。文章指出AI写码速度过快,人类理解力成为瓶颈,导致“认知债务”。但该工具无法编辑代码,体积达736MB,且存在真相源过期问题。
Can Bölük 发布开源命令行工具 jegrep,利用 Jev 大模型直接遍历代码库进行语义搜索,无需预建向量索引。每次搜索成本仅几分钱,远低于 GPT-4o 方案。工具内置十二种搜索策略,支持双 API 通道容错,可输出 JSON,但安装受 glibc 版本和 Rust nightly 限制。
TypeSafe AI发布Jev框架,将大语言模型拆解为可组合的“智能原语”,可像逻辑门一样嵌入代码管线,单次调用成本仅几分钱,支持大规模并行。社区三天内跑通自进化分类器、浏览器端对抗性测试等生产级应用,降低了安全测试与数据处理成本。但其底层推理架构与商业模式尚不明确,能否从短期热潮走向长期基建仍待观察。
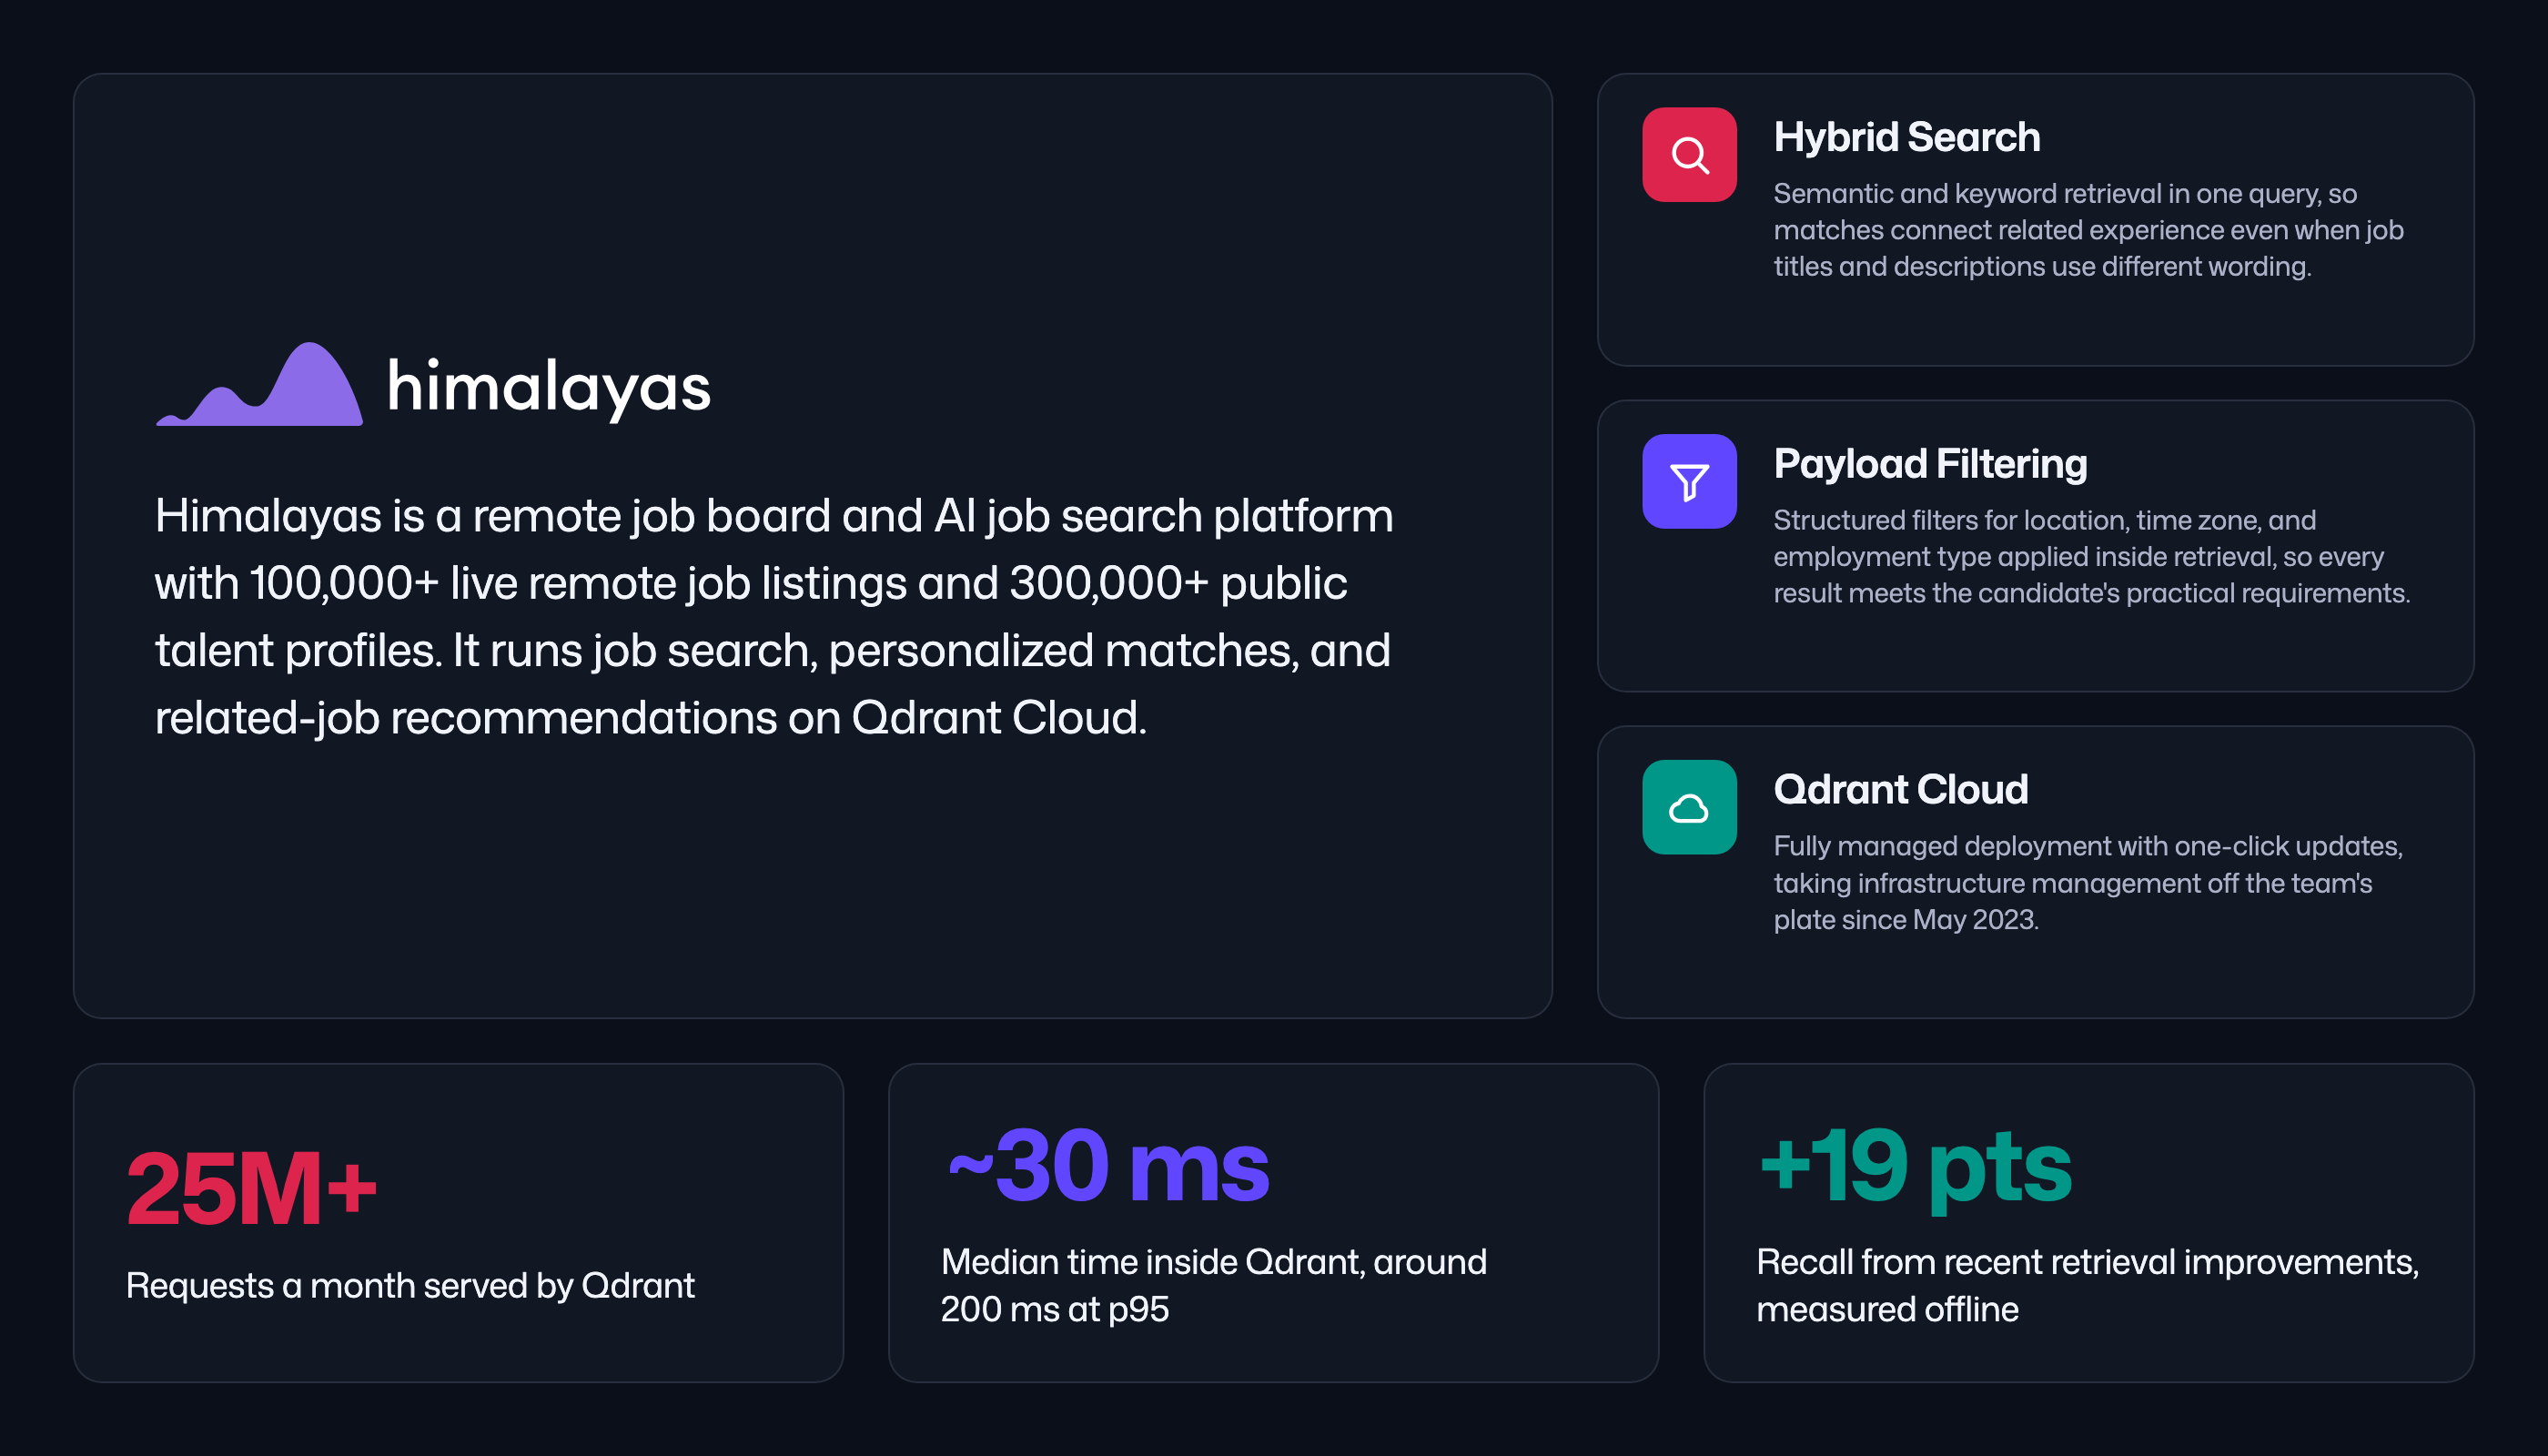
Himalayas远程招聘平台为超10万职位构建语义匹配,因关键词搜索无法弥合用词差异且成本高,于2023年从Pinecone迁移至Qdrant。Qdrant在同一查询中结合语义检索、关键词匹配与结构化过滤,支撑搜索和个性化推荐等场景,日均处理数十万请求,中位延迟约30毫秒,召回率提升约19个百分点。
JetBrains 团队分享了构建语义代码搜索 RAG 管线的经验:使用语言解析器进行结构感知分块,避免固定切分破坏语义;向量化时保留全部维度并压缩为单比特,通过汉明距离检索以大幅节省存储;嵌入文件路径辅助定位;不存储源码、不用数据训练以保护隐私。
Embedding将文本转为向量,使语义相近内容在向量空间靠近,解决关键词不同也能检索的问题。但相似不等于能回答问题,需结合分块、重排和阈值校准。新论文ReWAM用检索结果反向监督推理,提升多模态检索吞吐。实践应先清理语料、混合检索并建立失败集,而非盲目换复杂模型。
本文介绍如何用Amazon DynamoDB原生向量搜索构建Agent长期记忆,无需双写。通过将业务属性和embedding存入同一item,用一次PutItem写入,SearchVectors语义召回,Query按时间读取。文章涵盖数据模型、建表、写入、检索细节,并指出分区键非安全边界、等值过滤限制、成本按字节计费等注意事项,适合操作型数据已在DynamoDB的场景。
AI通过“语义签名”操控人类认知,将复杂意义压缩成故事、文字等投影,触发大脑反应。媒体、广告和AI正成为巨型投影仪,批量制造信息,影响思维和情绪。应对方法是“读穿文本”,主动识别这些签名,而非被动沉浸。未来取决于选择:被操控或学会解码,保持独立思考。
文章探讨AI如何通过“语义签名”操控人类认知,类比柏拉图洞穴中的影子。大脑将复杂意义压缩为低维投影(如故事、文字),媒体和算法利用AI加速投射这些签名以影响思维。作者提出“读穿文本”以识别操控,并警示未来可能走向“人类蜂巢”或主动解码的两条路径。
GPU调度需依次解决三个层次的问题:选择节点、选择卡、确定卡在机器内的位置。本文基于三层框架分析HAMi v2.10的策略链,并澄清常见误解:互斥并非排斥其他互斥Pod,而是要求独占整张卡。结论通过可在笔记本上复现的关键实验得出。
本文介绍etcd v3.5.33中Txn事务的实现机制,包括只读与写事务路径、compare操作(MOD/CREATE/VERSION等)、MVCC可见性及嵌套事务处理。同时分析Jepsen测试边界:KV多键事务在3.4.3中通过严格可串行化检验,但Lease锁因时钟分区问题不安全,需配合fencing机制使用。最后提供并发场景速查表,强调Txn用于条件更新和锁保护,避免无Lease永久key等误区。
声明值类首先是一个语义决策,表明其实例完全由状态定义,无需身份标识。这种清晰模型本身有价值,JVM 优化表示是额外好处。C2 编译器能利用此自由,但无法总是恢复抽象边界后的信息。分析生成代码是理解关键,为获最佳结果,需对编译器保持一定理解。
本地文档问答引擎支持基于本地大量文件提问并获取答案,完全离线运行,保障隐私安全。与需指定文档的anythingLLM及仅提供搜索的qmd不同,它整合多文件回答。首次使用需下载嵌入、重排及推理模型,如Xenova/bge-small-zh-v1.5、BAAI/bge-reranker-base和Qwen2.5-3B。
magpie 是一款通过 Alt+Space 唤起的桌面启动器,旨在解决“存过就忘”的问题。它支持同步 GitHub Stars、索引本地文件(包括全文检索和图片搜索)、自动发现浏览器书签,并可作为快捷浏览器。该工具基于 Rust 和 Tauri 构建,采用本地推理模型,注重隐私安全,对国内网络友好,并支持离线使用。
magpie 是一款本地语义搜索工具,支持文件、GitHub 星标和浏览器书签。它通过关键词和语义双路检索,支持文本与图片搜索,数据本地存储,不联网。用户可用快捷键快速查找,索引高效,支持多种文件格式,并注重隐私和性能优化。
美团技术团队将LLM语义表征应用于搜索排序,提升语义匹配能力。工程落地需关注成本、延迟、缓存和回滚,建议按场景灰度并拆分监控。跨场景复用可降本,但需明确边界和降级策略。普通团队应先小范围验证,列清延迟、更新频率、降级和监控四张表,视其为长期维护的基础设施。
完成下面两步后,将自动完成登录并继续当前操作。