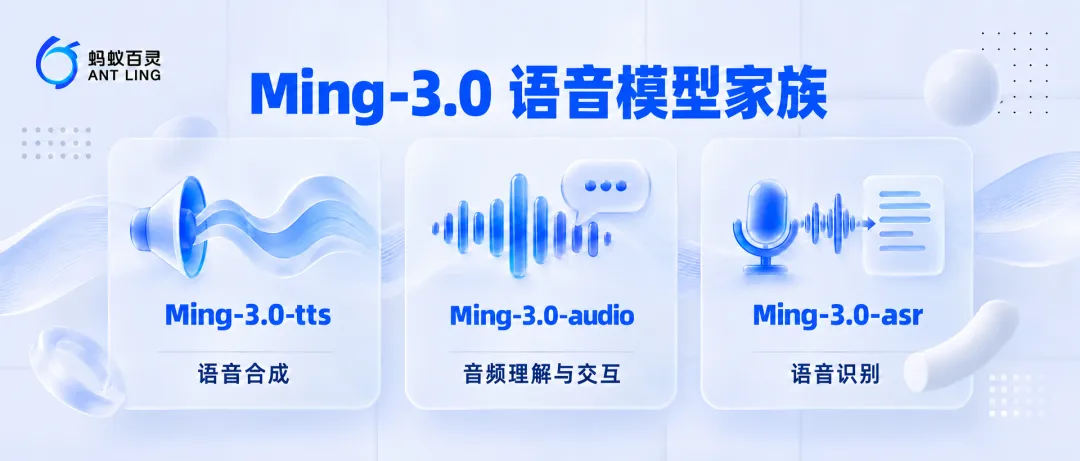
蚂蚁百灵开源Ming-3.0语音系列,共五款模型,覆盖语音合成、音频理解与对话、语音识别。TTS支持文字设定音色、导演模式调控情绪节奏及行内副语言标签,0.5B小模型表现突出;audio-flash/tiny可直接理解长音频并结构化输出,保留情绪与说话人信息;asr-tiny支持热词与上下文注入,提升口音、术语识别准确率。未来将探索Voice Agent长程复杂任务。
日本语音AI公司Kotoba的语音技术已在生成式媒体平台fal上线,开发者可直接调用三项能力:针对日语及东亚语言调优的语音识别、支持流式输出的日语语音合成,以及流式输出音频与文本的实时语音翻译。开发者无需自建模型与推理链路即可产品化落地,流式能力可缩短首字响应时间,改善实时交互体验。
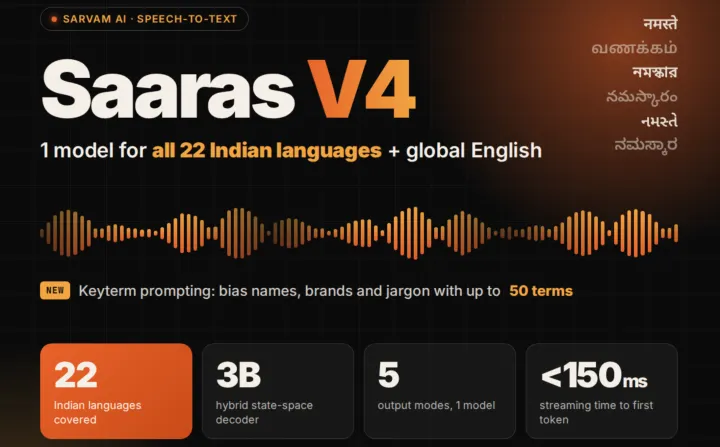
Sarvam AI 发布语音识别模型 Saaras V4,覆盖 22 种印度法定语言及全球英语口音,宣称均达最先进准确率。模型采用编码器-解码器架构,解码器为自研 30 亿参数混合状态空间模型。支持 5 种输出模式、最多 50 个关键词提示,流式首 token 时延低于 150 毫秒,定价 ₹30/小时。目前仅 API 可用,权重未公开,自托管仅支持 v3。所有数据均为厂商自报,尚无独立复现。
苹果设备端听写依赖神经音频编码器作为分词器,其参数量影响内存、功耗与延迟。研究提出潜空间蒸馏压缩法:以量化前的潜表示为目标,仅训练学生编码器回归教师逐帧潜表示,并用仿射层对齐宽度。2.8倍压缩下,六组师生中五组相对WER仅差1.9%,优于同容量独立训练编码器3.9%。
2026年9月17日,ZEGO云端实时语音识别发布v2.4.0,新增支持Qwen-Audio-3.0-ASR-Flash-Streaming模型,可配置热词,支持中文、英语、日语等语种,通过ASR参数设置厂商、语种和模型;同时下架qwen3-asr-flash-realtime模型,原用户后续将被替换为新模型。
LG回应电视监控用户指控,称电视不会持续录制或上传对话,唤醒词检测在本地处理,ACR、语音识别和广告功能均为可选且默认关闭。但报道显示电视仍长期记录环境对话,LG未回应数据收集范围、共享对象及隐私选项误导等质疑。
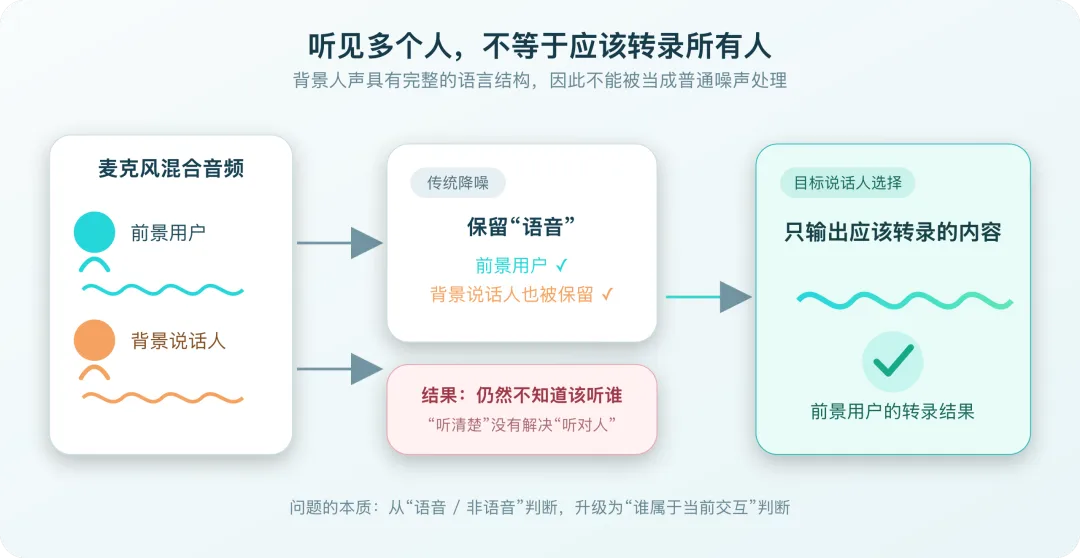
本文探讨语音识别在多人环境中“听对人”的挑战,即区分用户与背景人声。对比两种技术路线:基于身份注册的Target-Speaker ASR和基于场景线索的前景说话人转录,强调数据构造需明确时间、能量、空间关系,模型应学会选择交互主体而非单纯降噪,推动ASR从内容识别走向场景理解。
Meta推出实时语音识别模型Muse Voice Transcribe,支持70多种语言、区分20多位说话者及长对话,在基准测试中词错误率3.1%,优于竞品。模型采用自适应延迟机制,通过强化学习平衡准确性与速度。API定价每小时0.18美元,但不开放权重。Meta因眼镜和Mac应用等产品需求,持续推动该技术发展。
Speechmatics 的 Linden 模型现可通过 LiveKit Inference 平台使用,开发者无需额外申请密钥即可快速切换。Linden 支持 55 种以上语言,擅长处理浓重口音、嘈杂环境和字母数字识别,提升语音智能体在真实场景中的转写准确性。boost.ai 已将其投入生产,LiveKit 提供统一 API 和计费,简化开发流程。
谷歌更新Gemini音频模型,推出3.5 Transcribe等新功能,可自动识别专业术语和85种以上语言,去除填充词,支持语音编辑和最多三人说话人识别。3.5 Live增强中断处理和实时视觉处理,实验版可逐步叙述推理过程。更新今日起面向macOS应用和部分Android用户推出。
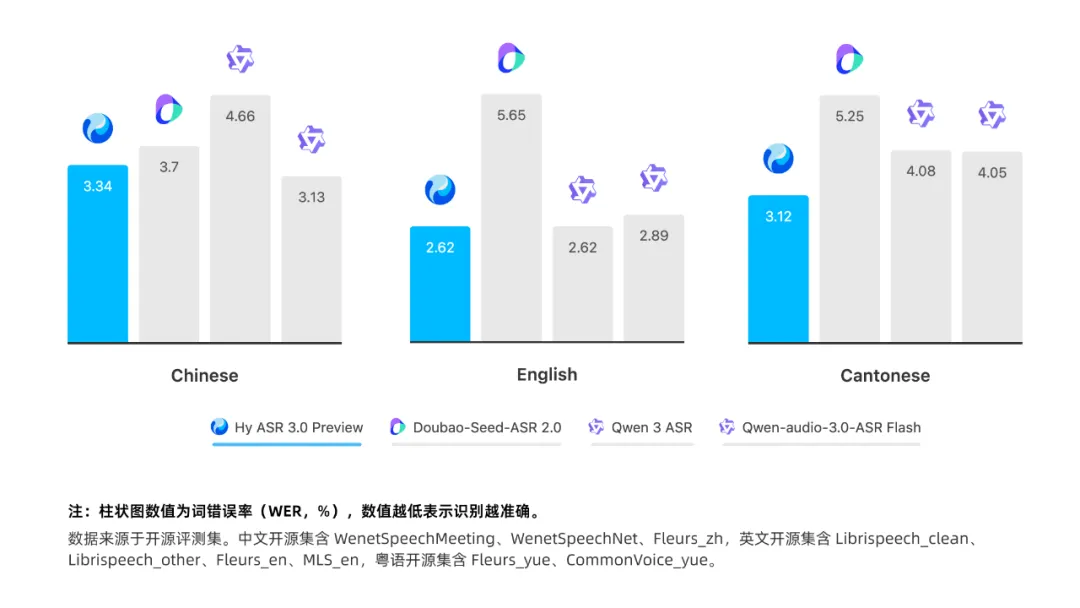
腾讯发布新一代语音识别模型Hy ASR 3.0 preview,基于大语言模型Hy3,融合高精度识别与语义理解,在通用识别、方言、上下文感知等维度提升。在开源和自建评测中WER领先,中文普通话3.34%、英语2.62%、粤语3.12%。已上线腾讯云API,元宝App免费体验。
腾讯混元发布新一代语音识别模型Hy ASR 3.0 preview,基于Hy3大模型提升通用识别、方言覆盖、上下文理解及复杂环境鲁棒性,在开源和自建评测中WER表现领先。支持热词注入,适配专业场景,已上线腾讯云API,并集成于元宝App,免费提供语音输入服务。
AI语音代理利用语音识别、自然语言处理和机器学习技术,实现自然对话,自动处理客户咨询、预约等任务,提供全天候服务,降低运营成本并提升效率。广泛应用于医疗、房地产、电商和金融等行业,同时生成数据洞察,支持可扩展性和安全性,是现代客户互动的重要工具。
Deepgram与高通合作,将Nova-3语音识别模型优化至骁龙X系列NPU,实现设备端实时语音转文本,无需云端,降低延迟和隐私风险。该技术适用于汽车、AI PC、XR等场景,提升准确率(词错误率6.89%),支持多语言和定制,为离线语音交互奠定基础。
神州泰岳在上海WAIC展示了ava 2.0数字员工矩阵,包括企业协作平台ava me+、语音数字员工avavox和个人助手ava app。ava me+帮助企业组建数字员工团队,avavox整合语音识别与大模型能力,ava app具备长期记忆,记录用户偏好与目标。这三款产品覆盖企业、客户服务与个人助理场景。
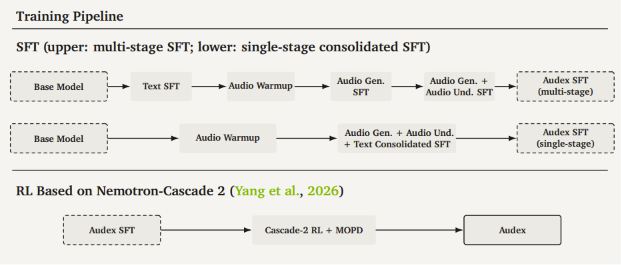
NVIDIA 发布了 Audex,这是一个统一的音频-文本大型语言模型,具备理解和生成音频及语音的能力,同时保持文本智能。Audex 采用 30 亿参数的 MoE 结构,设计简洁,避免了多模态模型的性能退化,在文本和音频任务中表现优异,尤其在语音识别领域领先。尽管存在商业许可限制和音频理解能力不足等缺点,Audex 仍在多项任务中表现出色。
在物理 AI 的发展中,语音识别成为关键能力,机器需要理解语音指令、区分说话者并过滤噪音。远场语音识别在复杂环境中面临挑战,基于物理的声学建模可以提升语音识别性能。FFASR 排行榜为评估语音模型在真实条件下的表现提供了新方法,帮助开发者确保产品的可靠性和易用性。
Voicebox是一款开源的本地AI语音工具,具备语音克隆、文本转语音和语音识别功能。用户只需录制几秒钟的声音,即可生成多种语言的语音,且无需云端支持和费用。它支持多种语音引擎,适合制作有声书和播客,保护用户隐私,是传统付费服务的替代品。
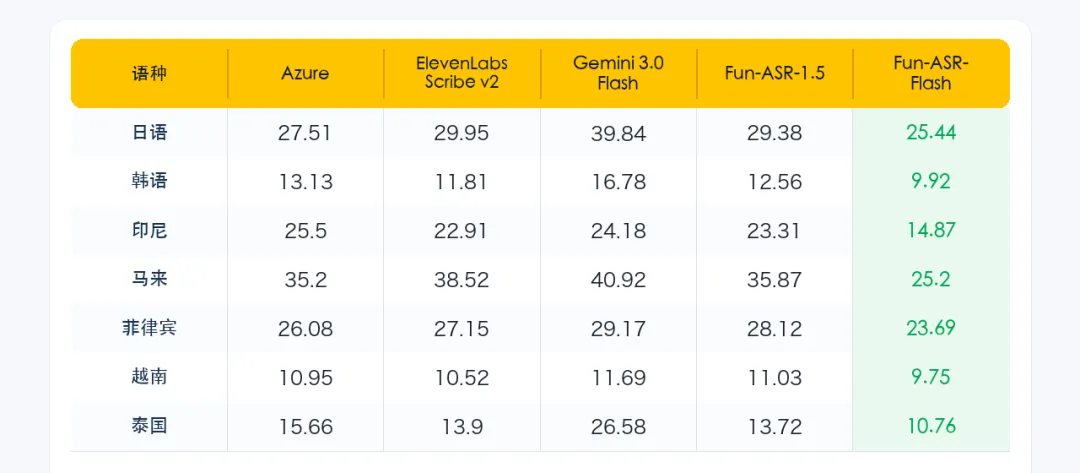
阿里推出的Fun-ASR-Flash语音识别模型支持三十种语言和十六种方言,准确率达到87.8%。该模型通过上下文和热词减少语义歧义,提升了对方言和小语种的识别能力,适用于复杂业务场景。
会话式AI利用大语言模型和语音识别技术实现自然对话。预计到2028年,60%的消费者应用将内置此技术。即构科技的ZEGO AI Agent深度整合实时音视频网络,提供低延迟的语音互动,核心技术包括语音识别、语言模型和检索增强生成,确保对话流畅准确。
完成下面两步后,将自动完成登录并继续当前操作。