Holo4发布27B与35B-A3B模型,主打通用电脑操作。文章解析GUI Agent坐标离散化:将像素位置压缩到0—999符号,执行器再映射回真实像素,精度受截图裁剪、缩放、滚动与延迟影响。作者提供坐标往返误差检测代码,并提醒常见误区:动作后需再观察、多分辨率测试、注意CC BY-NC许可、榜单成功率不等于业务成功率。建议记录截图与视口参数,建立坐标回归集,高风险任务需二次确认与回滚。
Figure、Dyna与亮源新创探索用人类视频预训练机器人。Figure的Index预训练将陌生家庭任务成功率从9%提升至56%,但未公开规模与闭环成功率的关系;Dyna验证人类视频规模扩大可持续提升真机表现;亮源新创用互联网视频验证迁移缩放定律。核心问题是人类经验能否成为可扩展的机器人预训练数据。
AWS公开了π0机器人的微调流程,称动作误差降低约89%。但早期评测因训练回合混入评测导致误差虚高至96%,修正数据切分后才可信。文章强调,关键在于训练与评测回合严格隔离,且89%仅为离线误差,不等于闭环任务成功率。
该页面介绍百分比误差计算工具,用于比较测量值与真实值并计算两者之间的误差。
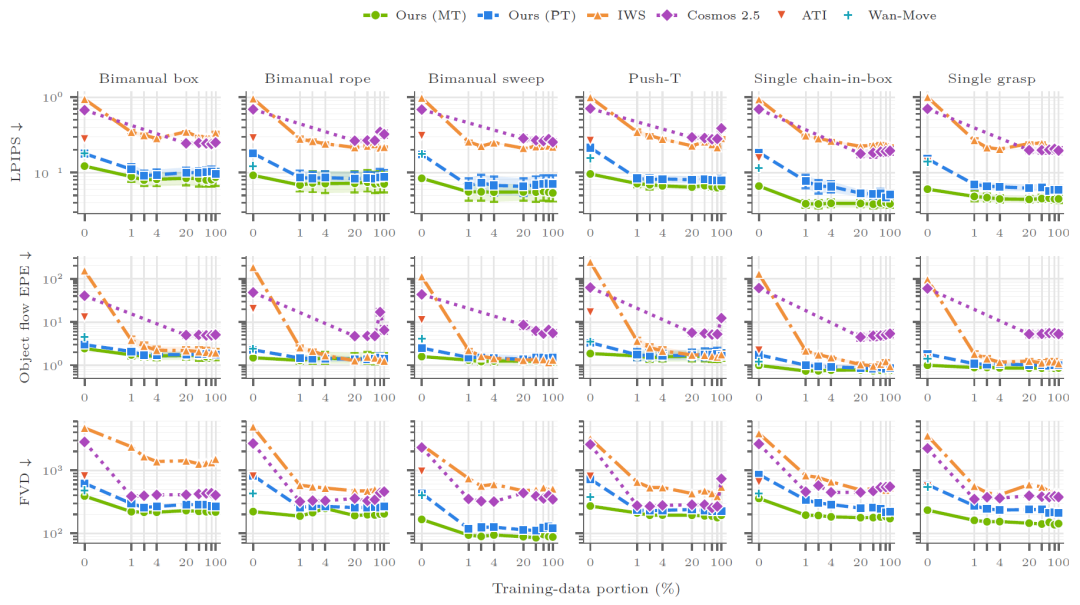
英伟达与哈佛等团队提出Hydra-0,一种以动作流为条件的通用世界模型,将机器人动作表示为像素运动,统一跨本体、任务和环境的预测。该模型降低机器人运动误差90.4%,物体运动误差60.2%,支持零样本组合,并在RoboLab中预测成功率与真实结果高度相关(r=0.96),同时实现高效推理和真实世界验证。
加州大学圣地亚哥分校与OpenAI的研究提出了OPINE-World,通过程序化世界模型使LLM Agent在未知环境中主动学习。在ARC-AGI-3基准测试中,该模型解决了20个游戏,达到了78.4的动作效率。OPINE-World结合两个Agent进行假设与测试,利用本体论误差度量优化探索过程,提高学习效率。
研究人员开发了EnergAIzer框架,能够在1.8秒内快速准确地估计AI工作负载的GPU功耗,避免了传统方法的高成本和长时间。该框架支持多种硬件配置,帮助数据中心优化资源分配,提高能效,功耗预测误差仅为8%。
文章探讨了大语言模型(如GPT)的设计缺陷,指出其输出错误源于数学结构和概率机制。模型的近似方法叠加导致误差放大,生成看似合理但不可靠的结果。缺乏数学证明和稳定性保证使得模型在复杂问题上表现不佳。作者强调使用GPT时应谨慎,将其视为辅助工具,而非最终决策者。
本文梳理关系查询优化器的发展主线:System R 以左深动态规划和 interesting orders 奠定代价优化范式;Volcano/Cascades 通过 memo、规则与物理性质组织搜索;DPccp/DPhyp 改进连接枚举。实验表明,查询图稠密度比表数量更影响枚举规模,基数估计误差是产生坏计划的主因。PostgreSQL 16 默认在超过 12 个表时转为 GEQO,学习型优化器宜作为补充。
本文介绍了神经网络的结构,包括输入层、输出层和多个隐藏层,并使用激活函数(如ReLU)引入非线性。反向传播通过计算梯度和链式法则,将误差从输出层向后传播以学习参数。
本文介绍了四种减少PostgreSQL行数估计误差的方法:1. 调整autovacuum自动分析频率;2. 增加每列的统计采样目标;3. 使用扩展统计处理列间相关性;4. 最后手段使用pg_hint_plan控制查询计划。通过这些方法可有效提升查询性能。
本文探讨改进的 Gram-Schmidt 正交化方法,旨在解决经典方法中的数值不稳定性和误差。改进方法在每次计算后立即更新向量,保持正交性,从而提高数值稳定性。
次季节至季节(S2S)天气预报填补了中远期气象预测的空白,但面临挑战。加州大学洛杉矶分校的OmniCast模型结合变分自编码器和Transformer,显著提高了预报的准确性和计算速度,解决了误差累积问题。该研究在AI顶级会议NeurIPS 2025上发表,展示了S2S预报的未来潜力。
本文分析了论文《Why Low-Precision Transformer Training Fails: An Analysis on Flash Attention》中低精度Attention计算的偏差问题,指出低精度运算导致的舍入误差可能引发MaxLogit爆炸等训练异常。作者提出通过调整计算公式消除偏差,并探讨注意力集中对训练崩溃的影响。
CMU研究者提出RaC方法,通过人类干预改善机器人模仿学习,解决长时序任务中的失败问题。RaC结合恢复与纠正行为,提升机器人在复杂任务中的效率与鲁棒性,克服传统模仿学习的局限性。
中国科学院大气物理研究所的林鹏飞团队在2025 CCF全球高性能计算大会上发布了CoTCN深度学习模型,该模型结合了Transformer与CNN,显著提升了全球海表面温度的短期预报精度,尤其在涡旋活跃区误差降低了15-60%。该模型在国产DCU平台上训练,展现出优越的训练效率和预报性能。
林鹏飞研究员在2025 CCF全球高性能计算大会上介绍了其团队研发的CoTCN深度学习模型,该模型结合了Transformer与CNN,显著提高了全球海表面温度短期预报的精度。研究表明,CoTCN在复杂海域的预报误差降低了15-60%,并能在国产算力平台上高效训练,展示了其先进性和重要性。
本文介绍了回归模型准确性和质量的关键术语,强调R²分数和均方误差(MSE)的重要性。回归模型用于识别数据中的模式和关系,广泛应用于金融、工程和医疗等领域。提高R²分数和降低MSE有助于提升模型的预测准确性。
本文介绍了Count-Min Sketch(CMS)算法,旨在高效估计数据流中元素的出现频率。CMS利用二维计数器数组和哈希函数,具有亚线性空间复杂度,适合无限数据流和内存有限的场景。其更新和查询操作的时间复杂度为O(d),且结果只会高估频率。文章还探讨了CMS的变体、误差分析及其在网络流量监控和推荐系统等实际应用中的重要性。
t-digest是一种高效的概率数据结构,专门用于在分布式环境中估计分位数,尤其是P99和P999。它通过质心压缩数据,支持亚线性空间和可合并性,适合处理大规模数据。t-digest的缩放函数确保尾部精度高,广泛应用于延迟监控等场景,并在实际应用中表现优越,常见于Elasticsearch和ClickHouse。
完成下面两步后,将自动完成登录并继续当前操作。