作者因微信读书上万条划线被搁置,独立开发了读书笔记App Booko。它支持微信读书、Kindle、Apple图书等多平台笔记导入,提供随手记录、合集整理、随机回顾及全端小组件,并重做了Mac版。产品完全由AI Coding开发,数据本地保存、iCloud同步,Pro版88元买断。
AI Agent是基于大语言模型的系统,能推理、规划、记忆、调用工具,自主完成任务。自主性分L0至L4五级,当前处于L3阶段,应追求“可控自治”而非全自动。Agent由LLM(脑)、工具调用(手)、循环(心)、记忆(本)组成,可分角色、工具、推理、记忆、评估五层。MCP协议统一了Agent与工具的连接标准,Google提出A2A用于Agent间协作。
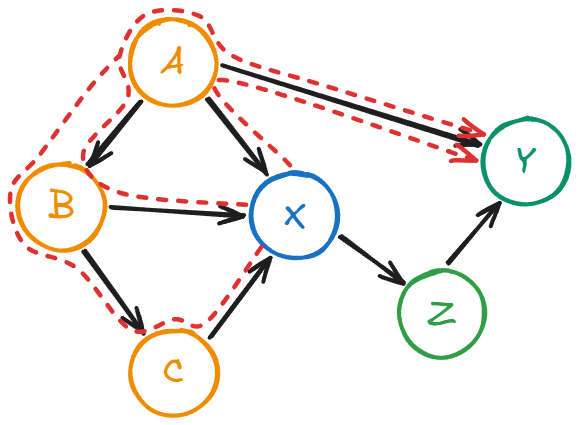
《为什么》读书笔记指出,作者借助因果图、do算子、后门/前门调整等工具,主张因果推断超越统计相关,可处理干预与反事实。笔记肯定该框架的价值,同时批评作者未严格定义因果、依赖常识偷渡概念,且仅解决“给定模型如何推断”,未回答“模型为何可信”。
《估值原理》从社会学视角解释价格形成,认为估值是市场参与者间的游戏,隐含社会责任分配。财务自由依赖他人劳动,社会分层由冲突与交换形成。风险控制需根据财富阶段选择保险、分散或对冲。价格反映人、制度与社会秩序。
本文介绍如何用AI整理读书笔记:手动复制10条笔记,加“原文”或“我的想法”标签,用提示词让AI去重、分类、补行动建议,最后检查数量、身份和出处。强调先小范围测试,避免复杂同步,确保笔记可靠可回查。
作者分享了一套快速阅读与知识内化方法:用无广告阅读软件(微信读书、静读天下)区分休闲与专业阅读,电脑端用Calibre三栏沉浸式扫读,并固定流程——摘录启发段落、转化为深度问题、独立思考、多AI交叉对比、沉淀感悟卡片。强调读书要变成思考、问题和行动,才能真正成长。
《半小时讲透第一性原理》探讨了通过识别假设、追问底层事实和重新构建思维来理解复杂问题。书中强调怀疑默认观念的重要性,提出每月读一本新书和保持“Day1心态”的习惯,以打破思维僵化,鼓励读者反思自己的假设,从而更清晰地理解和解决问题。
《茶杯里的风暴》读书笔记:作者从日常现象切入,讲解物理学原理。书中以爆米花、抹香鲸等为例,阐述气体定律、重力、表面张力等知识,强调科学是逻辑推理过程,基本原理是理解世界的宝贵工具。
本文总结了《Google SRE Book》的主要内容,介绍了SRE(站点可靠性工程)的方法与原则,包括监控、应急响应、变更管理和服务水平目标。强调自动化的重要性、风险管理以及在分布式系统中处理故障的策略。SRE团队的目标是提高系统可靠性,同时保持开发速度,确保服务的可用性和性能。
《大象的时间,老鼠的时间》探讨了动物体型与时间感知、进化及能量消耗之间的关系。大型动物如大象寿命长、稳定性强,但适应环境变化能力较弱;小型动物如老鼠变异快、适应力强,面临更大的生存压力。书中分析了不同动物的生理特征及其对生存的影响。
我使用微信读书近10年,积累了8000多条笔记。计划在桌面上随机回顾这些笔记,DIY一个小组件,利用Obsidian和n8n服务器构建API,手动同步笔记,并每半小时自动刷新,方便回顾。
《公正》探讨了功利主义、义务论和契约论等正义理论。桑德尔强调道德判断应结合具体情境,认为个体生活在社群中,正义需关注个体权利与社会责任。书中通过经典案例分析不同理论的应用,值得深入阅读。
本书讲述了大学教授杨素秋在西安文化旅游局挂职一年,筹办图书馆的经历。她克服困难,拒绝回扣,依靠人脉选书,最终实现理想的阅读空间,展现了人情冷暖与社会百态。
本文讨论了代数学的基本概念,包括集合论、逻辑推理、函数、群、环和域等,涵盖相等关系、有限集、线性映射、矩阵运算及多项式等基础知识,适合数学学习者参考。
真核生物的RNA聚合酶、启动子、通用转录因子、转录激活因子及染色质结构对转录过程的影响是研究的关键内容。
本文介绍了《AI原生软件交付》一书,探讨了人工智能在软件交付流程中的应用。书中分为四部分,强调数据驱动与人机协同的重要性,分享了AI翻译的经验,指出AI在设计阶段的核心作用及数据质量的影响。
《良好生活的哲学》探讨了苏格拉底的核心问题,强调个人应思考人生的目标与价值观。作者推崇斯多葛学派与伊壁鸠鲁主义,认为值得追求的生活需经过深思熟虑,强调自主意识与价值感的重要性。真正的幸福源于内心的满足,而非外在的地位与财富。
《思辨力35讲:像辩手一样思考》探讨了提升思辨能力的方法,介绍了逻辑框架、常见谬误和辩论技巧,强调明确定义、比较标准和利弊分析的重要性,以帮助读者更清晰地思考和论证观点。
《埃隆·马斯克传》强调质疑与实践的重要性,指出马斯克的成功源于环境与经历,犯错是进步的关键。以目标为导向、快速迭代和责任到人是管理的核心。学习他的优点并应用于自身。
本文记录了作者学习Hive SQL的过程,探讨了Hive的底层机制及优化查询效率的方法。Hive通过将SQL查询转换为MapReduce任务,简化了大数据分析。文章分析了Hive执行时间的主要阶段,并提出了多种优化策略,如本地模式、map-side JOIN、并发执行、动态分区和数据倾斜优化,以提高查询性能。
完成下面两步后,将自动完成登录并继续当前操作。