MiniMax发布M3.1 Flash,宣称代理成本降低70%,输入/输出每百万token定价0.15/0.60美元,推理速度接近M3的三倍。但第三方测得成本降幅为57%,且代理任务token消耗波动较大,70%的说法尚待验证。编码得分73.7%,与竞品接近,计算机使用能力较弱。事实问答正确率56%,错误回答率约93%,幻觉风险高,需增加验证。支持百万token上下文,权重与许可证未公布。
作者复盘近三年Cloudflare账单:2024年3月至2025年8月连续18个月零费用;2025年末迁入核心业务并开通Workers Paid后开始计费,2026年9月单月达71.95美元。主要开销来自域名续费、Images图片转换、请求超量、Observability日志及缓存穿透。通过启用Worker Cache、优化图片尺寸、关闭非必要遥测、改用KV做ISR缓存等措施,可将费用压回5美元基线。结论是5美元只是入场券,架构治理才是控费关键。
在Kubernetes中,GPU成本最高但最难按工作负载分摊。DCGM默认按物理设备上报,共享GPU时各Pod数据重复,无法准确归因。GPU按整数分配、不支持超卖,利用率指标也易误导。目前最可靠的是按显存计费,计算量仅作参考。共享方式包括时间切片、MPS、MIG和DRA,各有局限。
DigitalOcean 推出 Agent Droplets,将托管代理所需的微虚拟机、存储、推理及 16000 多种工具整合为单一月度订阅,自动享受折扣,避免多家供应商多张账单。支持 Claude Code 等现有框架,闲置代理几乎不收费,并提供 5 美元免费试用。
2025年底起,AI抢占高带宽内存产能,导致服务器内存价格2026年初翻倍,2027年前难以缓解。内存数据库成本骤增,但多数RAM存储的是冷数据。Redis Flex可将热数据保留在RAM、冷键值移至SSD,按10%–50%比例调节,SSD为主时每GB成本最多降低80%,无需修改代码,并支持Redis Search,适用于特征存储、缓存与AI代理。
开源项目Jev Use为Codex等AI代理提供技能与运行时,通过Jev模型优化浏览器和桌面自动化任务编排,减少往返调用,将执行效率提升约2.6倍。
企业AI成本治理不能只看Token单价。微软AI FinOps更新支持按租户、群组、用户设置预算与提醒,并关联Azure订阅。核心指标应为“单位有效任务成本”,即模型、工具、复核与重试费用除以通过质量门禁的任务数。实践需统一任务标识、建立三层预算、开展模型路由对照实验并定期淘汰低效场景,让预算与结果数据共同指导投入。
Hermes Jev Skills 是开源工具集,将决策模型 Jev 嵌入智能体,负责模型路由、记忆过滤、上下文压缩、技能挑选等七类小决策,让前沿模型专注重活。Jev 每次决策仅需 0.4 秒、约 0.00006 美元,并附带置信度。它不上传截图和网页正文,密钥对智能体不可见,还设有六层兜底与 shadow 模式。0.10.0 版修复了模型池维度被丢弃的静默 bug。
4 bit量化通常只压缩权重,激活仍为16 bit,因此显存不会缩小四倍。以70亿参数模型为例,4 bit权重约3.26 GiB,加分组比例因子约0.10 GiB,共约3.36 GiB;运行时还需KV缓存、激活和工作区。低比特不必然更快,格式支持、分组大小和校准都会影响精度与速度。部署前应估算权重下限、预留约20%余量并实测。
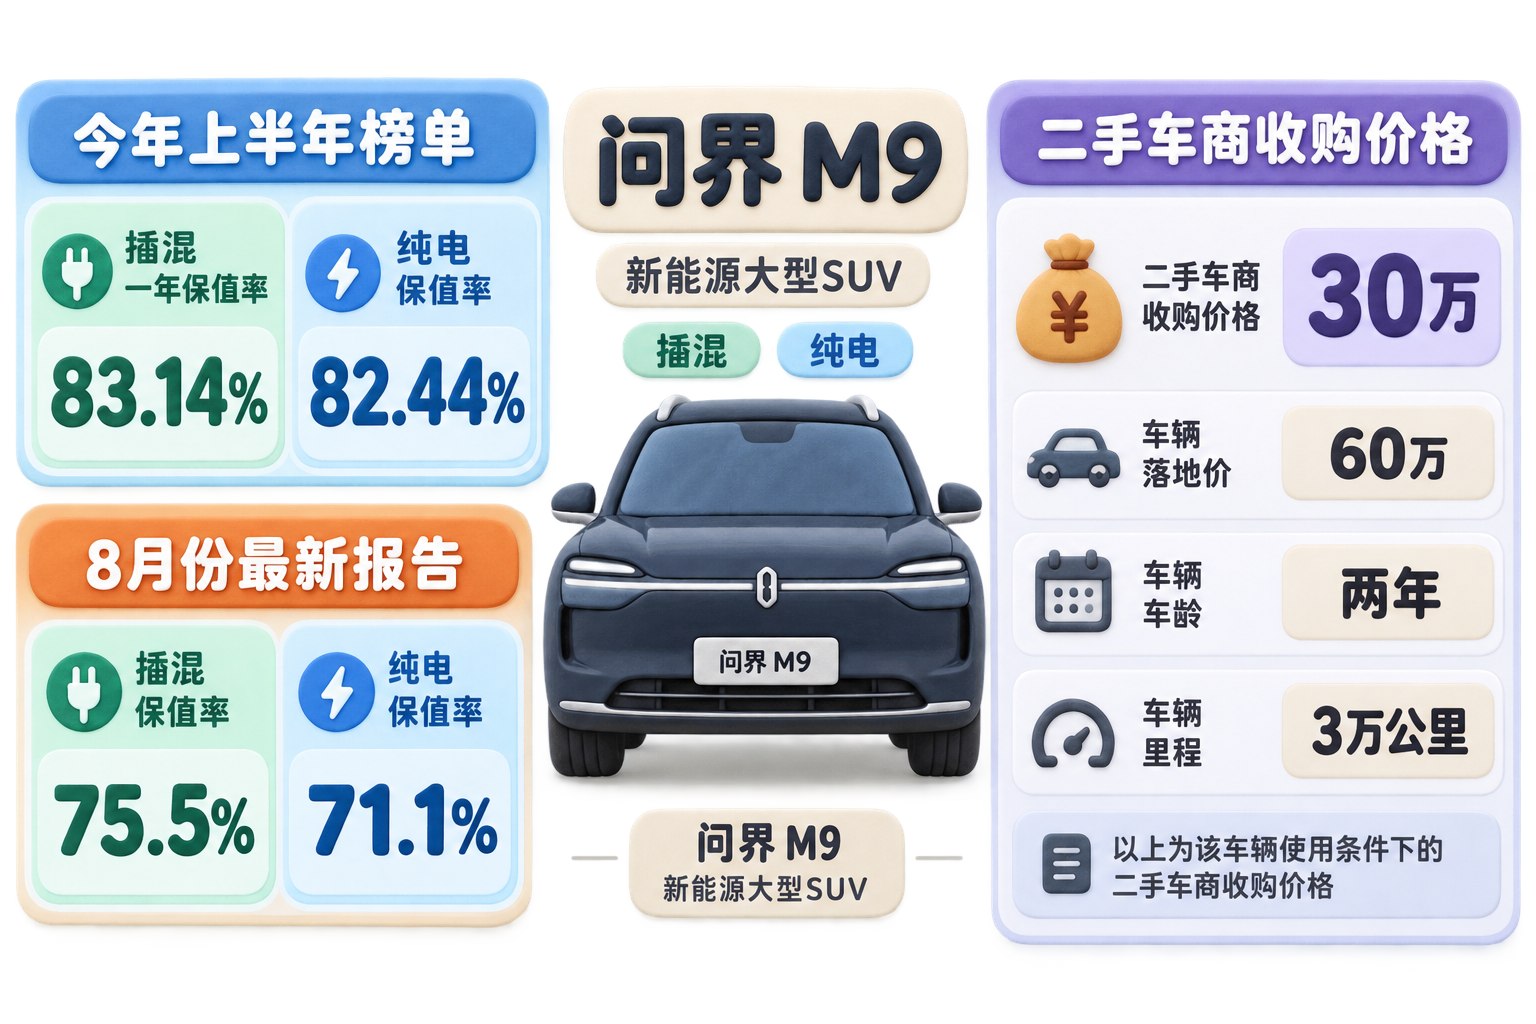
2025年9月15日,华为将问界主导权交还赛力斯,不再收取费用,仅提供技术赋能。四年间赛力斯向华为支付约1113亿元,自身扣非净利润仅14.82亿元,2025年上半年亏损17.17亿元。门店、售后及二手车价格动荡,问界二手车大幅贬值。鸿蒙智行“五界”模式难以为继,其余四界销量与渠道承压,业内认为该合作模式走向散伙。
2026年多项专利申请显示,在LLM输入前进行“瘦身”成为趋势,包括日志折叠、子句剪枝、动态截断、工具清单最小化等。Token管控从事后记账前移至喂模型前,但缺少通用审计与裁剪的中间层。独立开发者可开发Token浪费审计CLI与压缩代理,帮助AI外包开发者降低成本,约1500-3000元、2-3周可出MVP。
AI账单飙升并非因token单价上涨,而是代理式AI工作负载消耗的token量远超聊天场景,且缺乏成本可见性。文章建议通过记录每次运行的token数、模型、重试次数等字段,计算每项任务的真实成本,并采用成本/任务等指标来衡量价值,而非仅关注token价格。
Uber公开AI成本优化实践:通过将总花费拆解为六个可独立优化的变量,并采用四层架构管理智能体,实现了周活跃用户增长7倍、请求量增长9.4倍的同时,AI总支出自4月起保持稳定,单次请求成本下降34%,会话成本下降52%。核心方法包括模型选型基准测试、MCP工具CLI化、Code-Mode压缩Token、优化Prompt Cache TTL及构建上下文图谱,强调成本可见性与文化引导,为AI编程降本提供了系统化工程方案。
该文聚焦2026年大模型API中间层专利趋势,涉及NVIDIA、IBM等公司的路由、缓存与成本预测技术。核心机会在于为开发者构建中间件,通过语义缓存、智能路由和成本护栏降低API费用。建议提供成本审计服务和垂直优化代理,月费99-299元,但需警惕大厂内置风险,应垂直化积累经验。
多智能体系统虽提升效率,但推理强度过高会致token消耗暴涨5至10倍。应匹配任务难度选择推理档位,如Scout用low、Worker用medium、Smart worker用high。协调者应专注分派任务,避免过度思考。设置fork_turns为none可减少上下文继承成本,并明确边界指令防止递归。合理配置可大幅节省成本,但需持续优化。
Grok Bot是马斯克旗下xAI推出的AI队友,配备云端电脑,可7×24小时持续工作。其设计反常规:无界面交互、瘦客户端厚服务器、永不下线的云电脑及浏览器自动化。优点在于低学习成本和持久运行,但存在调试困难、断网失效、账单持续产生、安全边界模糊及模型选择黑箱等争议。
企业AI编程成本飙升,核心对策是优先选择性价比高的开源模型,通过动态路由和AI网关统一管理,按任务难度分配模型,压缩上下文并利用缓存,同时温和提醒而非断网限制。Databricks等公司的实践表明,这些方法可降低成本三成以上,同时保持效率。
AI 任务越模糊,费用越高。作者总结五大烧钱场景:开放式提问、全量测试、裸看日志、多 agent 并行、长会话。省钱关键在于将问题具体化,明确范围和完成标准,避免让 AI 做无用功。会提问即会省钱,问题越清晰,账单越薄。
实时音视频收费由核心时长费、增值服务费和基础设施费构成。视频按分辨率分档、多人通话时长叠加、增值服务默认开启是账单偏差主因。选型时需用真实业务模型估算,加20%缓冲,并确认免费额度、计费口径等细节,避免用量黑洞。
Kubernetes在AI智能体工作负载下启动速度慢,基准测试显示专用沙盒工具Daytona中位启动速度快4倍,累计时间省30%-60%。K8s适合稳定在线服务,但AI环境多样、短暂、高频,导致算力浪费和云账单高企。选型应基于场景,避免路径依赖,K8s仍是微服务治理首选,但AI任务需专用工具。
完成下面两步后,将自动完成登录并继续当前操作。