文章借YOLO Data Agent的发布,讨论自然语言查数的工程风险:SQL可执行不等于答案可信,退款、时间归属、地区定义等指标口径须预先审核,遇歧义应追问而非猜测。多轮追问需保存结构化查询状态,仅修改用户明确变更的部分,并保留可追踪标识以便排障。数据库应采用只读隔离库,限制数据范围,设置超时与资源预算,权限在服务端校验;缓存标识不能只含提问文本,以免越权复用。建议先选口径稳定、可与现有报表核对的小场景试用。
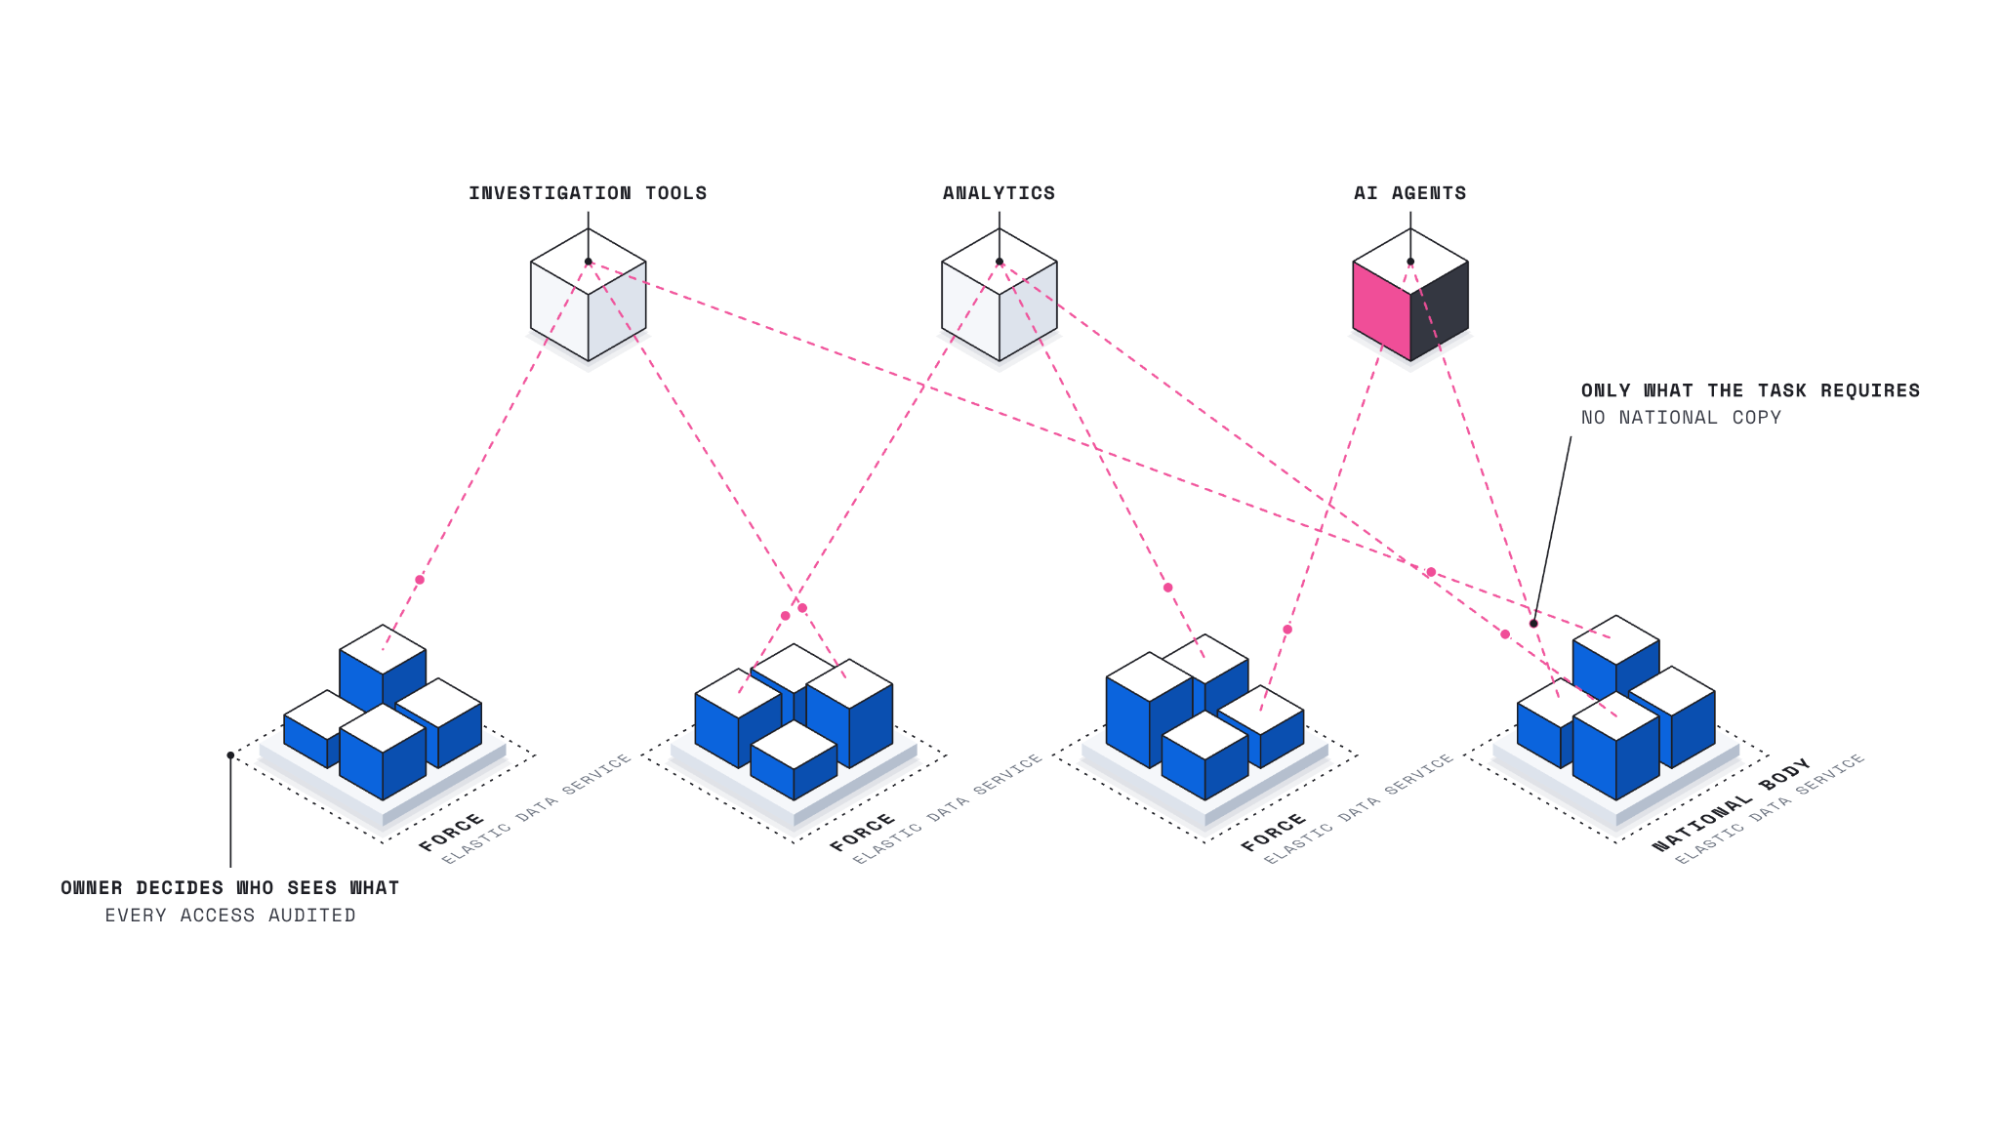
英国警务改革面临跨机构数据整合难题。内政部白皮书提出建立国家数据整合服务,但集中式平台易导致依赖与创新迟缓。文章主张采用数据网格模式,让数据保留在原属机构,通过开放接口共享,兼顾国家访问与地方问责,并为AI应用奠定基础。
Robert Seacord在RustConf 2026指出,Rust虽以内存安全著称,但Unsafe Rust的语言语义仍多未定,缺少完整形式化内存模型,UB、指针provenance与别名规则尚无定论,编译器行为与Miri等来源也不完全一致。Rust需定义、验证并审计unsafe,才能进入汽车、内核等安全关键领域。
多租户AI agent直接读写企业文件时,可能被提示注入操纵而越权或破坏数据。本文介绍用Amazon FSx for NetApp ONTAP在agent之外建立数据边界:以export policy按网络身份划分租户与读写权限,用qtree和FlexClone限制会话影响范围,借助Kerberos建立可信身份,并通过FPolicy、自主勒索软件防护、NAS审计、快照与取证副本实现检测、告警、取证和恢复。
Google Cloud发布Gemini agent,可理解业务上下文、规划并调用工具,在文档、邮件、开发环境中执行任务。企业软件交互将从“人找菜单”转向“人给目标、系统给可审计结果”。开发者需重视权限、审计、回滚与成本控制。当前证据多为官方公告,可靠性、价格与权限粒度数据不足,建议先用于只读、可核验、可回滚的低风险流程。
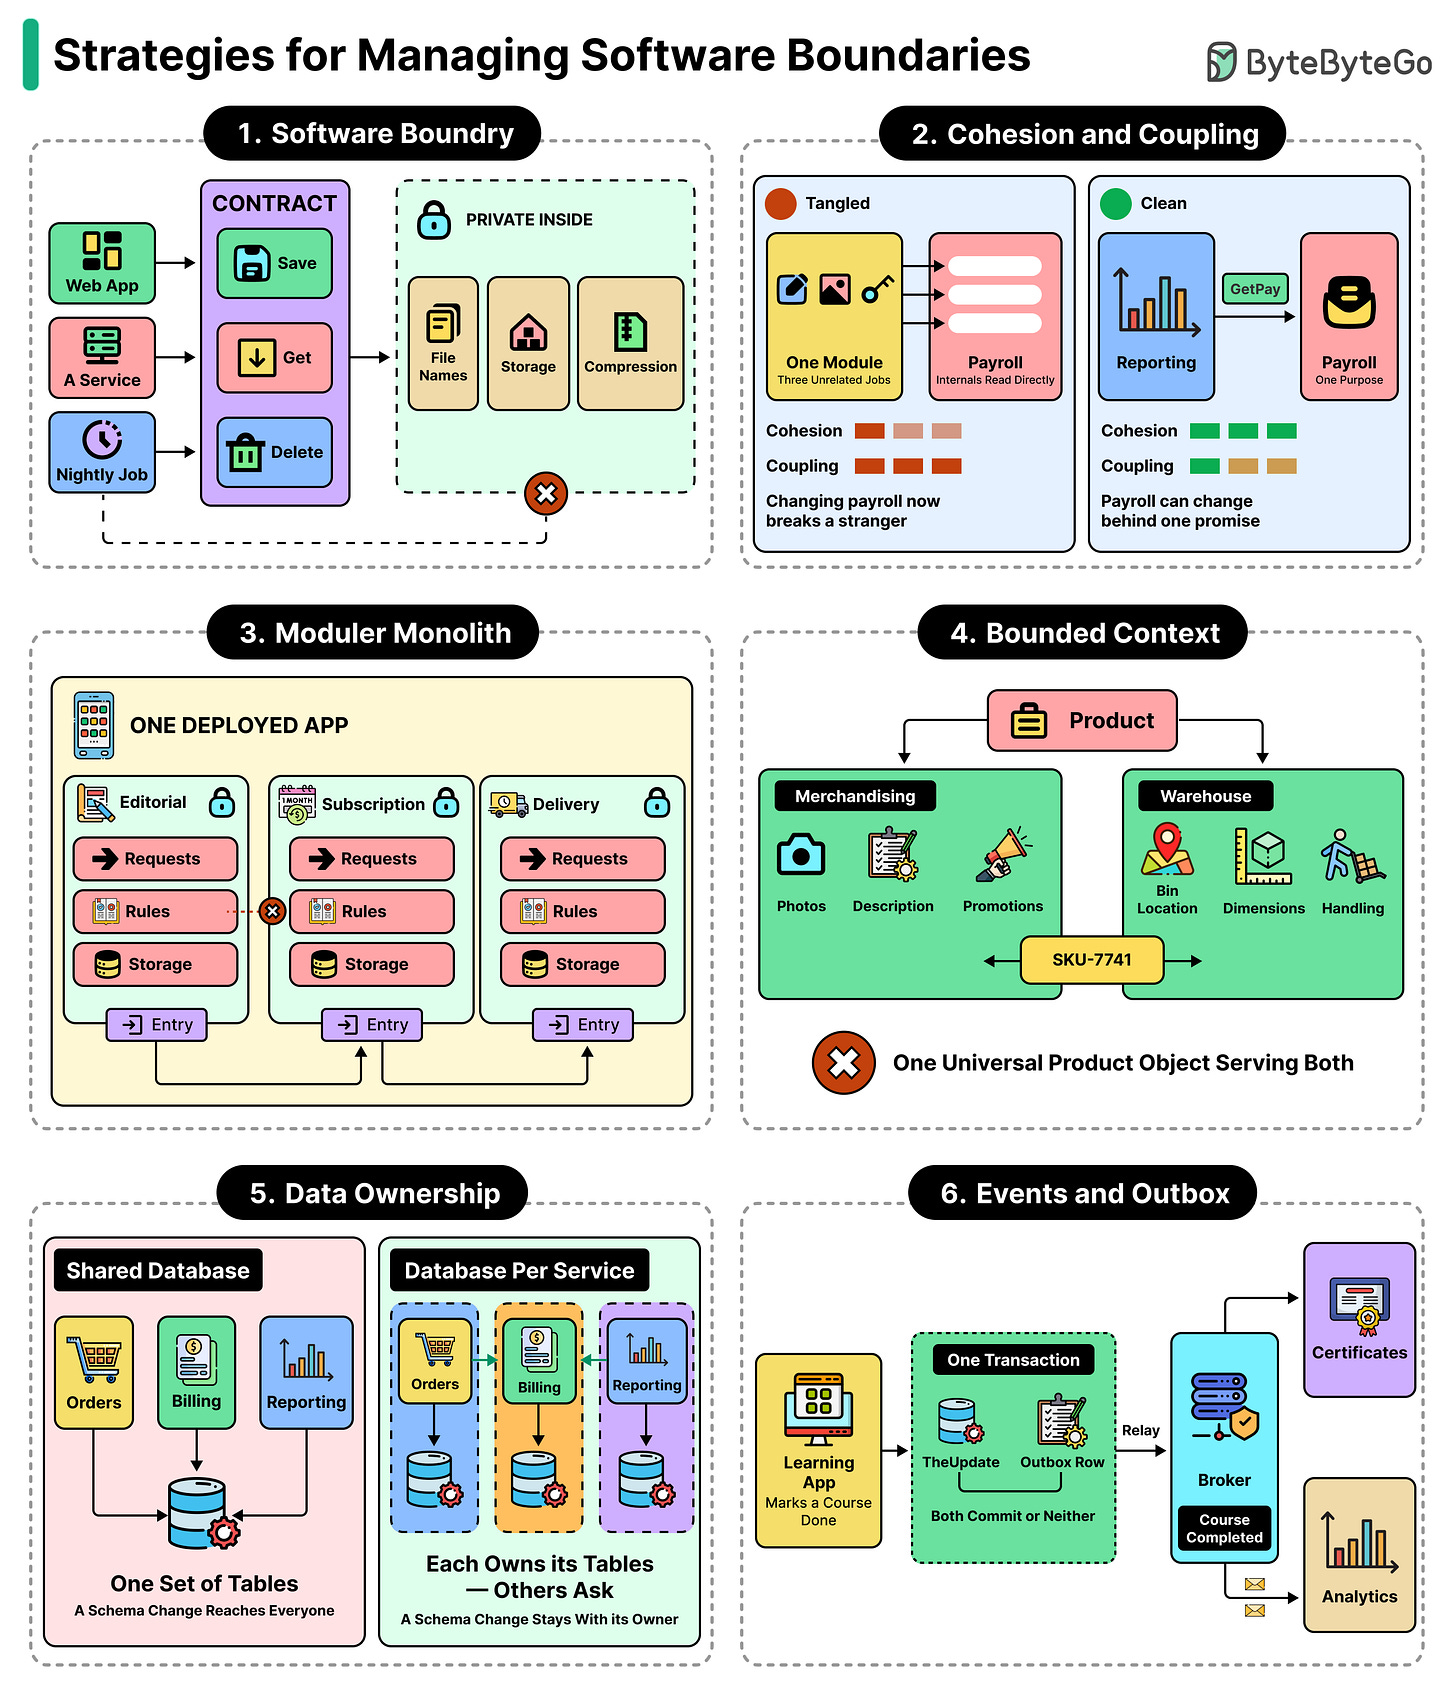
软件边界划分是开发者的核心技能。合理划分大型系统能聚合职责、规则与执行细节,并让外部通过清晰路径访问内部。开发者需判断职责分组与依赖关系,文章介绍了辅助边界决策的关键策略。
联想YOGA Pro 15 RTX Spark于10月8日开启盲约,是全球首批搭载NVIDIA RTX Spark N1X超级芯片的本地智能体AIPC。它集成Blackwell RTX GPU与Grace CPU,端侧AI算力达1 Petaflop FP4,配128GB统一内存和2TB存储,支持本地运行超千亿参数大模型。搭载天禧AI超能模式,实现断网可用、零Token成本与隐私安全,面向AI创作、开发和科研人群。
SonnetDB 4.0.0 发布,支持多模型与嵌入式部署。作者认为多模型数据库的关键在于明确数据边界与恢复机制,而非功能堆砌,建议先用于内部工具或边缘模块,验证备份、恢复、升级和性能,成熟系统勿急于迁移主链路。
本文介绍用 Java 17 调用图像模型实现商品视觉问答:将图片 URL 与问题放入同一请求,要求模型区分可见事实、推断与未知。代码用 HttpClient 调用 Responses API 并解析 output_text。文章强调模型可能误读容量等信息,关键结论需人工核验,适合低风险咨询,不适用于医疗、安检等判定。
研究探讨用户自主设计个人感知系统时的本体边界协商问题。采用“绿野仙踪”法设计两种开放式探针,让参与者训练个性化机器学习系统并进行为期一周的日常使用研究,识别出四类协商场域:现象边界、主体与关系、信号与噪声之分、数据客观性,并提出相应设计支持思路。
Google发布Gemini 4 Argon,单次输出上限提至100万Token,面向软件工程与企业Agent。模型可在单条轨迹内规划、调用工具、改代码并验证,减少多回合交接损耗,但放大成本失控、错误累积与审计难度。厂商内部案例显示代码迁移等收益,但缺独立复现。企业需设预算、检查点与人工审批,不能把百万Token当作取消任务拆分的理由。
GitHub 动态工作流采用“确定性骨架+概率性节点”模式:用代码固定步骤、依赖、数据格式与审批点,仅将需判断的局部交给 Agent。该模式可重复执行、可观测、可控成本,并支持版本对比与测试。设计时需区分确定性工具、概率性判断和副作用节点,分别处理重试、超时与审批,适用于发布检查、事故研判等重复且失败代价高的任务。
papero-pdf-text-extractor 是一个由 Beatriz Almeida 开发的开源 PDF 文本与结构提取工具,采用 MIT 许可证。 它的核心目标是从 PDF 中恢复文档结构(如阅读顺序、表格、公式、图片位置等),而不仅仅是提取纯文本,旨在为 R
Anthropic红队指出GLM-5.3在高级网络攻防任务上能力接近Claude Mythos,但拒绝与安全护栏薄弱。作者认为,将AI Agent接入工单、CI、代码审查等系统时应收紧权限边界,避免宽权限账号;护栏不能只靠模型拒绝,需工具调用分级、敏感操作人工确认、环境隔离和日志审计。小团队应把AI当作会误判的自动化账号管理,不让其直接持有生产凭证或未经审批修改CI/CD配置。
Java强封装正在堵住JDK内部的大门,可一个名叫trusted Lookup的钥匙,竟然还能从序列化机制里悄悄造出来! Java从JDK 9开始不断收紧JDK内部接口,JDK 16以后又把强封装推得更远,目标很清楚:让普通库代码少碰JDK内部实现,让Java默认拥有更强的完整性保护,但一组针对JDK 11到27的实验却发现,反射、Unsafe、
AI代码审计利用大模型语义推理,弥补传统SAST在复杂逻辑分析上的不足,已进入工程化落地阶段。在Gitee等平台可通过Webhook集成到PR流程,拦截硬编码密钥等低级漏洞,但存在幻觉与合规风险,需采用“AI初筛+人工复核”模式,而非完全替代人工。
AI产品出海不仅取决于模型与价格,云Region才是能力、合规与成本的真正边界。阿里云计划在土耳其、芬兰、荷兰新建Region并扩展多地数据中心,新Region可缩短延迟、便于数据驻留,但模型可用性、合规与灾备仍需逐项核实。建议上线前确认服务清单、实测延迟、绘制数据流并演练降级,架构预案优先于上线承诺。
阿里千问发布Qwen Intelligence,定位为手机厂商提供AI全栈方案,不造硬件。核心是系统级Agent Harness,将模型规划转为可控系统动作,关键在于权限、日志、回滚与审计。厂商系统差异大,适配成本高。开发者应关注接口边界、权限校验与失败恢复,而非追逐概念。
AI编码代理为获取上下文会读取本地文件,可能将.env、密钥、日志等敏感信息发送给外部模型,导致密钥在提交或CI检查前泄露,传统安全关卡无法拦截。应实施零信任控制,在提示或文件读取前用确定性密钥检测进行阻断或脱敏,并明确代理权限与上下文规则。
文章讨论 Jev 这类 System One 决策模型:它接收状态与有限候选,直接返回概率,省去生成 JSON 的中间步骤。作者在 Free4Chat 的 Arena 实验中用它做游戏实时决策,结果不如确定性脚本稳定,延迟约 300ms。结论是 Jev 适合候选空间已明确的分类、路由、评分等场景,而非开放控制;前提是 Harness 先把世界整理好。
完成下面两步后,将自动完成登录并继续当前操作。