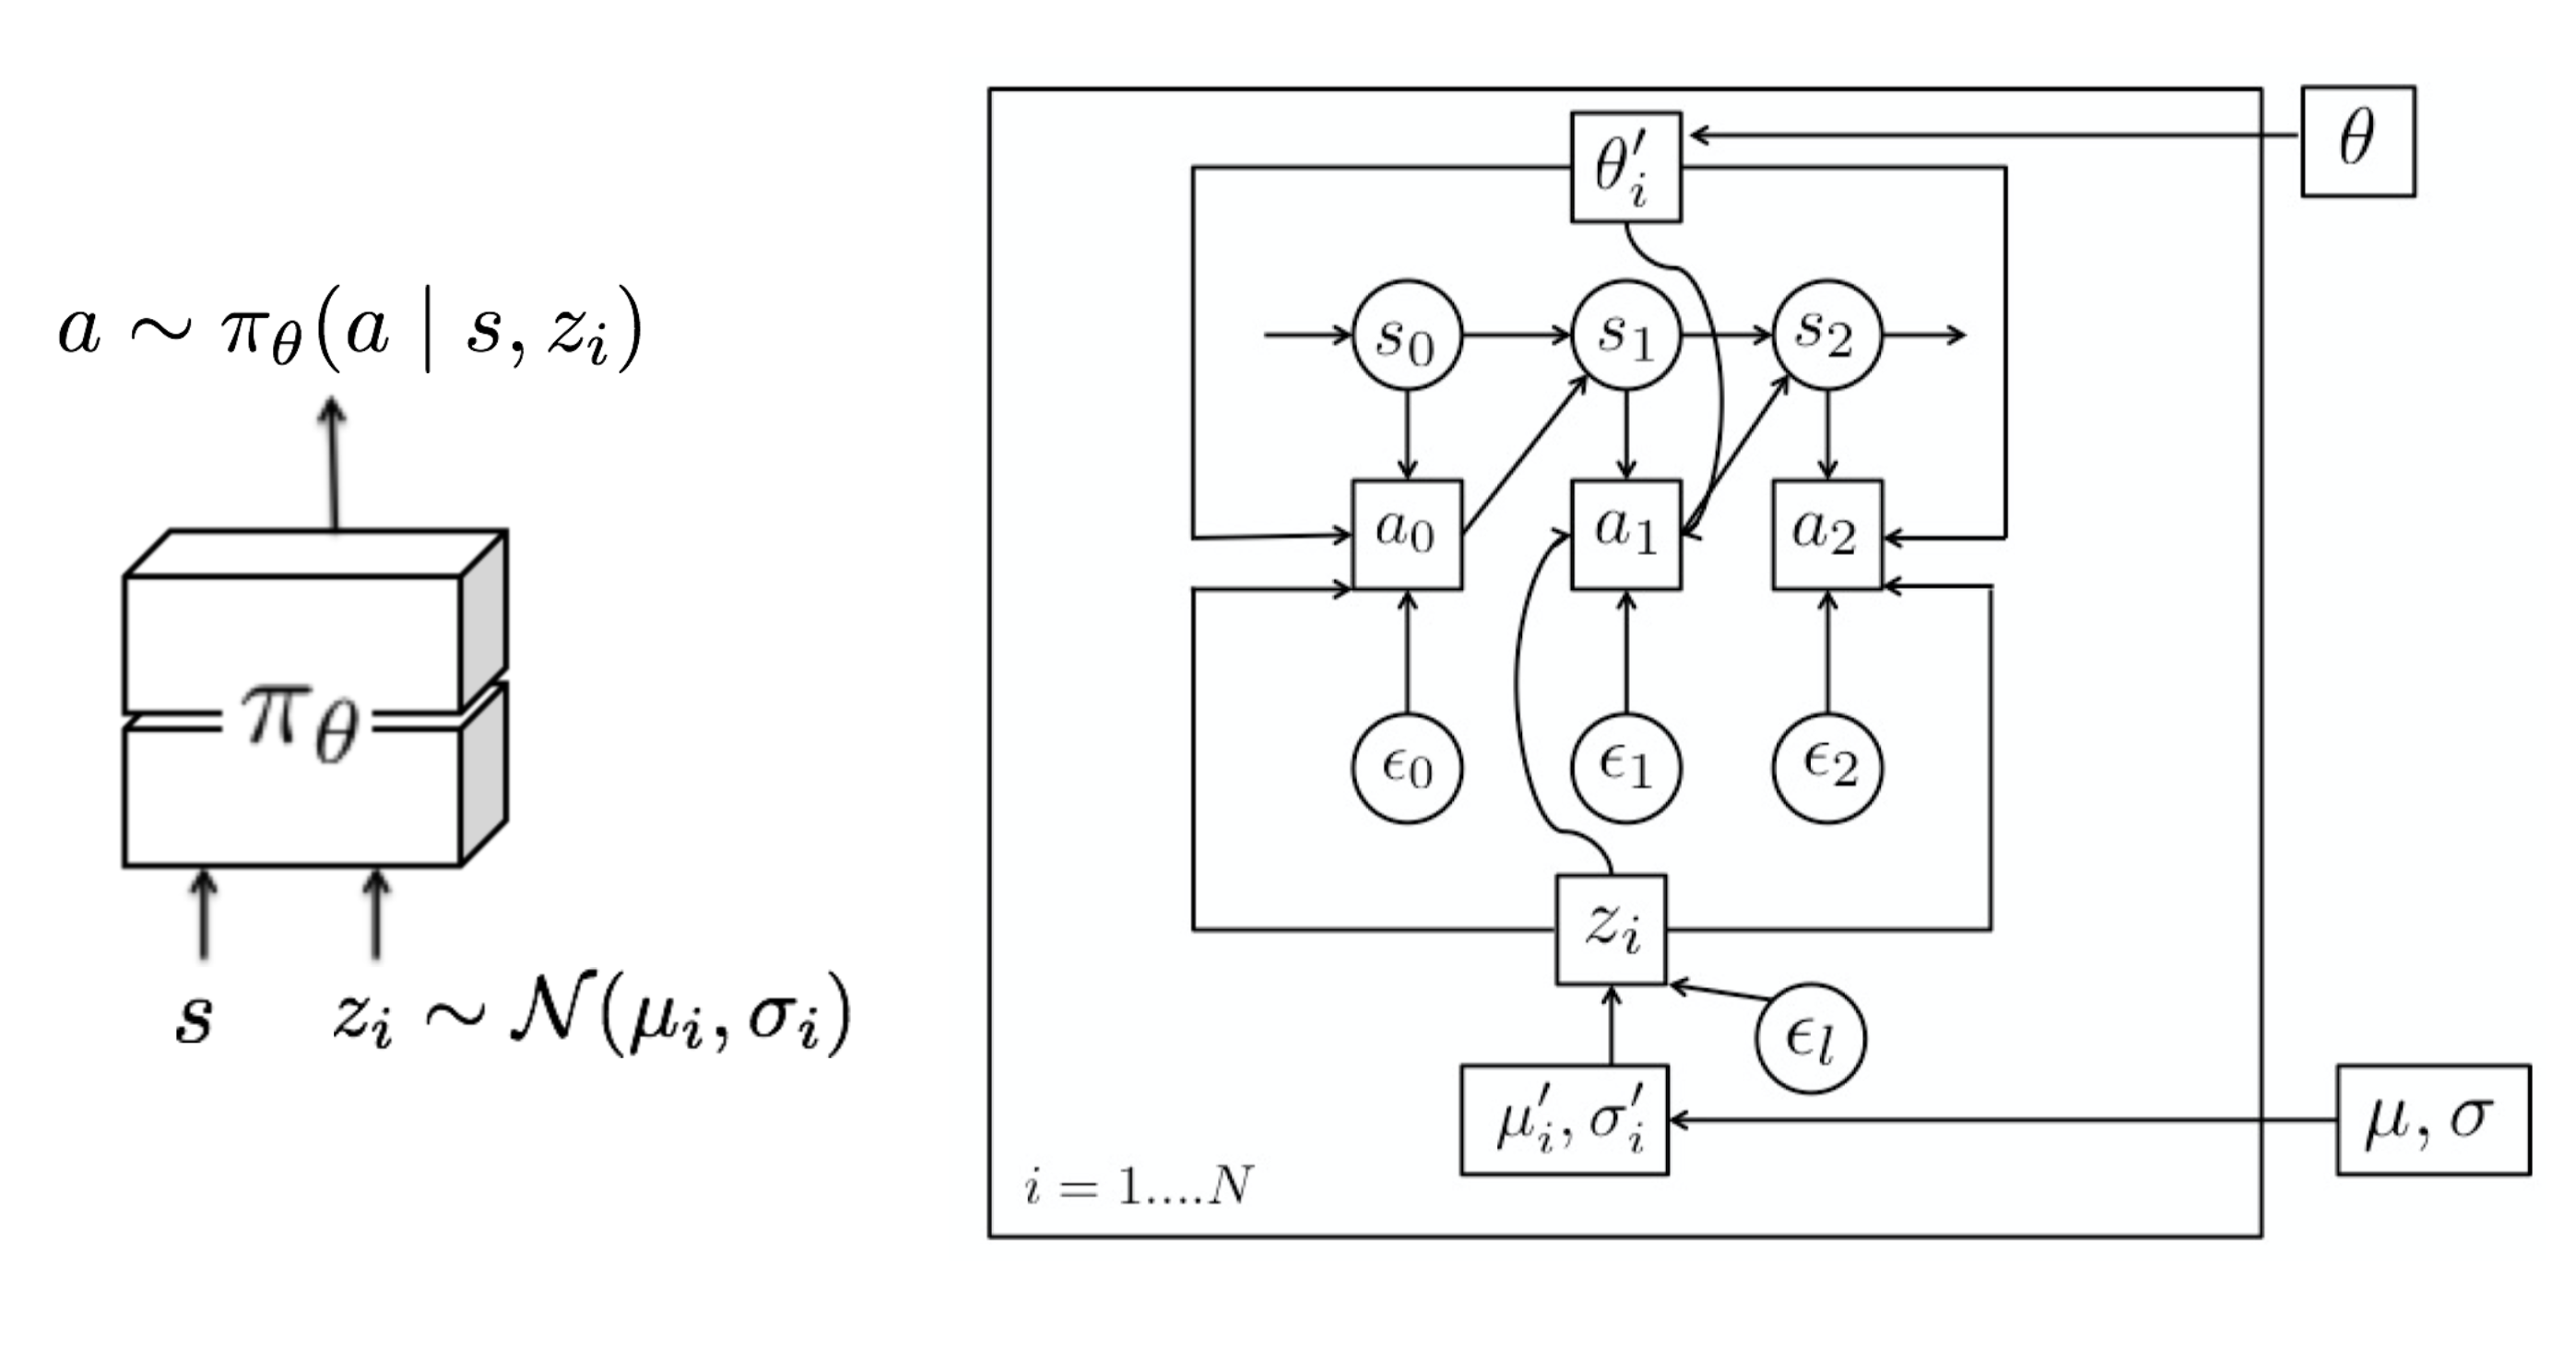
该研究提出了一种基于交互的认知双胞胎构建方法,利用输入输出训练和进化策略,通过协调多个物理和虚拟设备,有效模拟人类交互行为,为任务自动化和智能体生成奠定基础。
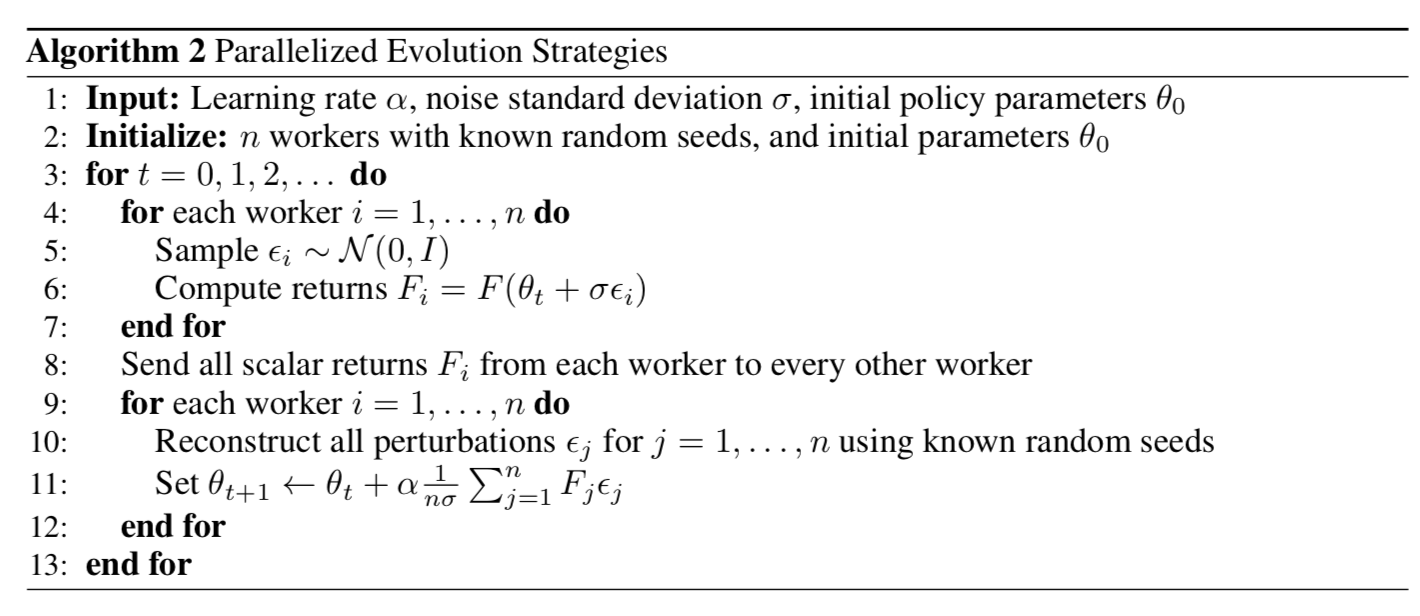
进化策略(ES)是一类黑箱优化算法,通过采样、评估和选择迭代更新参数分布。基础高斯ES仅跟踪均值和标准差;CMA-ES引入协方差矩阵,自适应调整搜索方向与步长;自然进化策略(NES)利用自然梯度提升优化效率。在深度强化学习中,OpenAI ES用高斯扰动并行训练策略,NS-ES通过新颖性搜索鼓励探索,CEM-RL结合进化与梯度方法。PBT和WANN则将进化算法用于超参调优和网络结构搜索。
元强化学习旨在训练能快速适应新任务的智能体,核心是让策略网络结合上一动作和奖励,通过循环网络记忆任务信息。训练时从MDP分布中采样任务,用梯度下降更新模型。关键组件包括带记忆的模型、元学习算法和任务分布。主要方法有MAML、元梯度RL、进化策略和情景记忆,并通过域随机化或进化算法生成任务。
完成下面两步后,将自动完成登录并继续当前操作。