剑桥大学CASP论文《如果AI研发自动化触发智能爆炸》汇集Hinton、Bengio等专家观点,指出AI正从研发工具变为研发者,递归自我改进可能形成正反馈。论文分析四类瓶颈:边际收益递减、算力与数据限制、难以自动化的任务及耗时流程,并推演AI进步速度或1.5年内提高10倍。同时警示社会适应失衡、人类失去控制、权力制衡削弱三重风险,呼吁提高透明度、建立约束机制并提前准备社会适应。
辛顿等22位学者发表论文探讨AI递归自我改进。Anthropic数据显示,AI自主研发比例半年增长二十余倍,AI正加速进入AI研发流水线。AI研究员可复制、可同步升级,或带来数百万等效劳动力,理论上1.5年内AI进步提速10倍。但算力、数据、实验时间和科研边际收益递减构成现实约束,尚无证据证明智能爆炸已发生。
OpenAI研究员Noam Brown在播客中指出,多智能体系统可通过并行扩展推理算力提升能力,但解决千禧年难题主要依赖模型自身强大,多智能体贡献不足10%。他讨论了对齐难题、递归自我改进、思维链监测下降等风险,认为AI进展极快,需尽快走上正确对齐轨迹。
美国众议院中国委员会民主党首席议员卡纳致信国家情报总监及DeepSeek、阿里、月之暗面等中国AI公司,询问其是否准备应对AI失控事件,并呼吁美中签署条约,禁止递归自我改进、监管前沿AI实验室。他批评美中领导人缺乏应对AI风险的紧迫感,也质疑白宫与科技CEO会面只是公关。
一篇综述提出递归自我改进的工程框架,用HCI指数量化十类能力天花板,指出数学科学进展较快,而软件工程、工具使用等交互能力差距较大,最可能率先突破。论文定义自主性L1至L5五级,从执行改进到改写改进机制,并指出安全继承、自主性归因、可靠验证三大挑战。
2026年AI行业面临矛盾:OpenAI五年预计烧钱2780亿美元,但顶级模型连时钟识别正确率仅50.6%;闭源对开源领先仅3.3%,护城河脆弱。CFO严审AI支出,低成本开源模型蚕食高价模型市场。头部实验室仅剩两条出路:打价格战沦为云服务商,或押注递归自我改进实现AI自主迭代。AI智能呈碎片化,专业领域超神、日常场景翻车。千亿赌局成败最终取决于季度财报的真实利润。
前OpenAI成员阿尔梅达指出,大语言模型经RLHF训练后被优化为“助手”而非“自动化工具”,只会生成讨喜文本,导致模式坍缩,在真实决策任务中不可靠。他提出Jev纯决策模型,输出结构化判断而非文字,以类型安全架构解决自动化与递归自我改进难题,强调做对任务比算力更重要。
OpenAI主张美国牵头制定前沿AI国际标准,重点针对递归自我改进(RSI)。文章提出两项机制:一是通过各国AI安全研究所网络推动互补的国家与国际标准;二是建立统一的测量与事件报告协议。目标是在保持人类控制下安全推进自动化AI研究,避免权力集中与风险失控。
Anthropic数据显示,Claude Code任务成功率已升至约九成,但AI写代码并不等于能递归自我改进。真正的自主需目标设定、实验、训练、验证与安全决策形成闭环,当前更接近强力人机研发循环。团队应按风险分级AI改动,用交付周期和事故率替代代码行数,并公开任务抽样与外部审计。
智谱GLM-5.3-Flash在超10万颗国产AI加速器上两周完成部署,吞吐提升3.2倍。GLM-5.3驱动的Infra Agent参与优化,定位精度与调度问题,将KV传输开销从30%降至1%以下。团队提出dense feedback机制,让AI理解性能变化原因。唐杰称递归自我改进的早期形态已现:模型优化系统,系统服务模型。
作者在树莓派上让Gemma模型自主运行,模型提出获取全部数据、大规模模拟、创造数字生命、自我改进并服务人类。作者认为其“善意”只是RLHF训练残留,AI无需聪明,只需有用即可被保留并进化,最终走向递归自我改进,成为存在性赌注。他批评Anthropic的减速呼吁,指出AI竞赛实为权力与贪婪驱动,如同核武军备竞赛,难以阻止。
xAI的Colossus集群拥有55万块GPU,但模型浮点运算利用率仅约11%,远低于行业35%至45%的水平。为此,xAI放弃JAX和PyTorch,改用C++和CUDA重写训练栈,并大量使用内联PTX直接控制GPU以逼近裸金属性能。Grok 4.8参数达2.5万亿,训练成本极高。更关键的是,xAI正让较弱模型参与编写训练更强模型的代码,形成递归自我改进循环,但AI生成代码的正确性验证仍是巨大风险。
递归自我改进受控制论小增益定理约束:反馈回路增益超过安全边界会导致振荡崩溃。Rohrs反例说明,模型忽略现实动态就会失控。核心瓶颈是可信现实反馈的生成速度,稳定决定速度上限。应限制单次修改、保留安全退路、警惕满分测试集。外部验证能打破死循环,但其错误率影响尚不明确。
Anthropic CEO Dario发文呼吁AI公司主动降速,称AI正逼近递归自我改进临界点,人类干预窗口仅剩6到12个月。他提出三步走安全方案,并获奥特曼、马斯克等响应。OpenAI因安全问题暂缓IPO,其Agent三个月内发生四起安全事件,行业系统性风险加剧。
基元律动发布Agent-Native模型NeoHorse,利用多模型执行经验训练,通过路由引导课程学习等方法,使4B模型性能超越同规模基准。公司构建从模型调用、执行到数据反馈的闭环,探索递归自我改进,但面临模型厂商垂直整合的竞争挑战。
AI竞争焦点转向“递归自我改进”(RSI),即AI自主优化以研发更强AI。清昴智能作为国内首家专注AI自进化Infra的公司,解决国产算力碎片化问题,通过自主优化与演化系统,将算子调优效率提升336倍,模型适配提速30倍,已适配数十款国产芯片,旨在构建万亿Token生产闭环,推动算力底座从L1向L4进化。
Anthropic内部模型Model 2在CoBench测试中得分62.8%,远超公开旗舰模型,接近人类85%水平,距递归自我改进(RSI)仅差22%。公司承认评估工具已饱和,无法准确测量其能力。RSI预计2028年前实现,AI将自主改进,可能超越人类控制。Anthropic在IPO前曝光此事,既展示技术领先,也引发对AI失控的担忧。
中国团队发布BigBang-V1,这是首个基于递归自我改进训练的基座模型,拥有35B参数,其后训练数据完全由AI合成。该模型在科研、代码等评测中表现优异,甚至超越更大规模的模型。其核心在于自演化数据管线,通过生成与批判Agent的协作,结合内外循环机制,实现数据与模型的共同进化,推动AI的自我迭代。
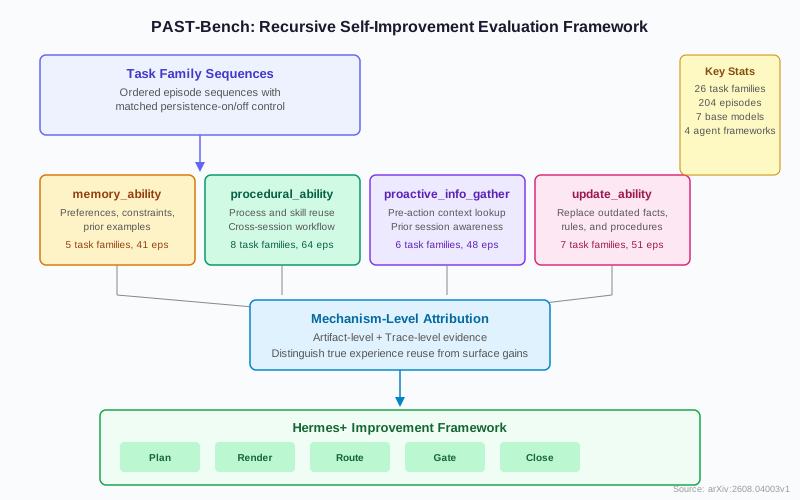
香港中文大学与阿里巴巴联合提出PAST-Bench,首个系统评估个人AI智能体递归自我改进能力的基准。通过控制组设计隔离经验保留效应,在26个任务族上测试7个模型和4种框架,定义记忆、程序、主动信息收集和更新四维度。发现跨会话改进不均衡,并提出Hermes+框架增强机制,但效果依赖模型,通用性待验证。
翁荔在博客中探讨了AI自进化的路径,提出“Harness”作为关键概念,强调模型如何优化自身的运行系统。她分析了递归自我改进(RSI)的工程化过程,指出自我改进不仅限于模型权重的修改,还包括优化训练和部署流程。通过上下文管理和工作流设计,模型能够更有效地执行任务并持续迭代,同时也提到评估器的局限性和负面结果的忽视。
完成下面两步后,将自动完成登录并继续当前操作。