


Sierra开源了Hyper-τ-bench基准,用于测试AI代理能否自主构建另一个代理。结果显示,最佳模型组合得分仅23.9%,远低于人类辅助的82.2%。代理常过早停止研究、提问不足、缺乏实验,尤其在银行业务上表现差。这表明自主开发代理在信息收集和设计判断上仍有明显局限。
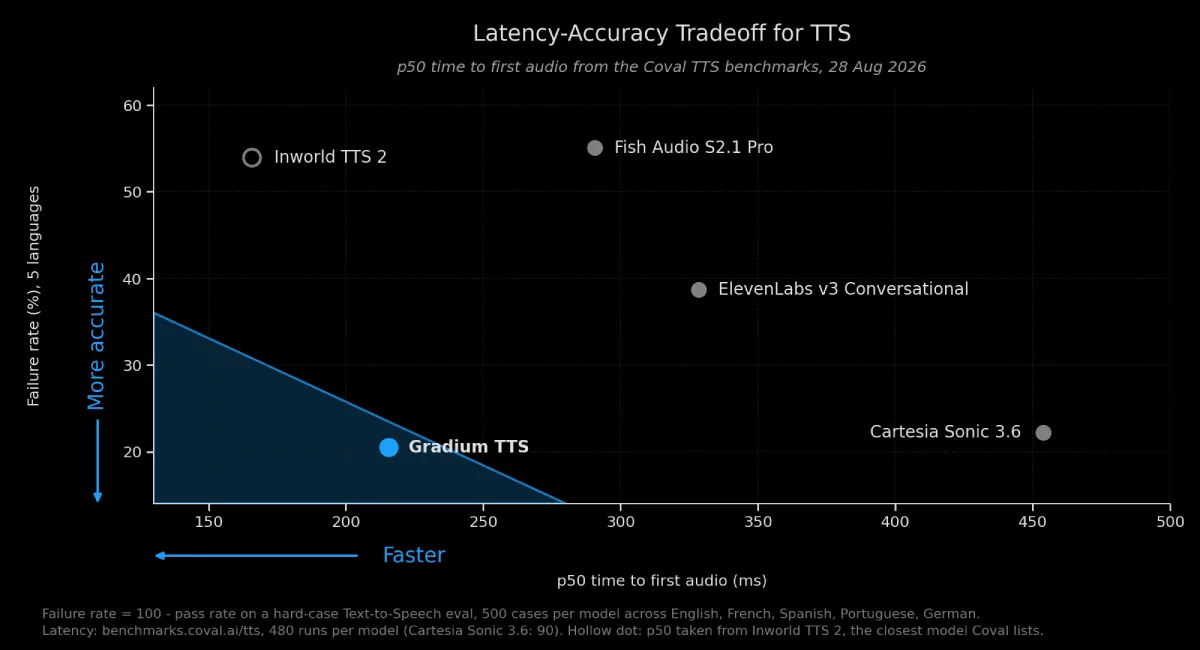
Gradium AI发布新TTS模型并设为默认,在500句难例测试中人工评分通过率81%,领先Cartesia和ElevenLabs。首音频延迟216毫秒,低且稳定。支持多语言,无需文本归一化即可准确朗读号码和邮箱。基准测试由厂商运行,评估集已开源。
Dex Horthy在第三篇文章中承认此前“无好基准”的判断有误,介绍新基准SlopCodeBench(SCB),通过检查点模拟需求逐步演进。他实测Opus 5、Sonnet 5、Opus 4.8,最强Opus 5严格通过率仅24%,其余仅6%。代码质量指标显示劣化严重,结论是当前模型仍无法无人值守运行,但SCB提供了可追踪的衡量工具。
AI在生物制造领域的应用面临实验执行精确性挑战。恩和科技开发的BPL语言旨在标准化实验流程,提高自动化和复现性。通过BPL-COGEN,科研人员可以将自然语言转化为标准化代码,确保实验的准确性和效率。SAION AI平台整合这些技术,实现高效的实验设计与执行,推动生物制造产业化进程。
UniPat AI发布的SaaS-Bench评测显示,主流AI模型在真实办公任务中的通过率仅为3.8%。这些模型在处理复杂跨应用任务时表现不佳,无法稳定完成实习生的日常工作。评测指出AI在长流程工作中的四大缺陷:任务越长越难、错误传播、缺乏自我检查和执行不稳定。未来软件需重新设计以适应AI的操作需求。
谷歌推出了两个工具以解决Gemini API代码过时的问题。Gemini API Docs MCP连接代理与最新的API文档,确保使用最新配置。Gemini API Developer Skills提供最佳实践指导。结合使用这两个工具可提高工作效率,评估显示通过率达到96.3%,且每个正确答案所需的令牌减少63%。
研究表明,将文档索引嵌入AGENTS.md文件中,可以使AI编码代理在Next.js项目中的通过率达到100%,而使用技能的通过率仅为79%。技能未能有效触发,指令措辞对结果影响显著。AGENTS.md的被动上下文方法优于主动检索,提供了更可靠的知识访问框架。
机器之心数据服务现已上线,提供高效稳定的数据获取服务,简化数据爬取流程。
文章分析了一位同学面试失败的原因,主要是缺乏自信和缺乏总结习惯。建议通过工作中的成就感提升自信,并定期总结项目经验,以增强简历亮点和面试表现。
本研究结合ChatGPT与基本搜索技术,提升了形式证明生成的效率和可及性,最佳模型的通过率达到31.15%,为AI辅助的形式证明生成提供了新见解。
在一所学校中,给定每个班级的通过人数和总人数,以及额外的优秀学生,目标是合理分配这些学生,以最大化所有班级的平均通过率。通过使用最大堆优先分配对通过率提升最大的班级,最终计算出最大可能的平均通过率。
完成下面两步后,将自动完成登录并继续当前操作。