本文讨论如何系统提升 ai_extract 文档抽取准确率。核心观点:单字段修补可能引发其他字段回归,需建立可重复评估流程。建议用 schema 描述约束字段规则、全局提示处理文档级逻辑,复杂表格用 precision mode,引用定位错误来源。用 MLflow Prompt Registry 版本化提示与 schema,固定测试集评估准确率、覆盖率与波动,人工把关上线。Genie Code 可自动化评估与迭代循环。
文章介绍如何用Cohere Embed 5 Pro与Qdrant实现可扩展的PDF检索。Embed 5 Pro以单个稠密向量表示整页图像,无需OCR,在5个ViDoRe V3英文语料上优于多个晚交互模型。结合Matryoshka降维、非对称量化(页面1比特、查询8比特)与全向量重打分,512维方案每页仅占64字节内存,并保留99.2%的检索质量,适合大规模生产部署。
该文为加密货币机构招聘广告,共发布八个岗位:机构BDM、C++低延迟交易系统工程师、量化策略研究员、PMO项目经理/总监、财务经理、斯巴达业务负责人、资深量化风险专家、资深量化交易专家。岗位多为全职,部分岗位位于香港现场并提供EP,部分支持远程。要求涵盖机构销售、高频交易开发、做市策略、项目管理、交易所财务、跟单产品、量化风控与对冲交易等经验,强调实盘经验与负责人级别能力。
大语言模型推理工程旨在降低延迟、提升吞吐、减少内存。本文推荐5个实践项目:从零构建迷你vLLM、用Triton编写FlashAttention内核、搭建量化实验、实现投机解码、构建生产级推理服务,帮助深入理解KV缓存、连续批处理、量化等优化技术。
Jump Trading的Lucas Baker表示,GPT-6 Astra显著提升了AI智能体的自主性,可承担从日常编码到复杂量化研究的长期任务,并能递归改进成果。但他强调人类判断仍是核心:需明确目标、环境与评估标准,并保留人工审核,尤其在受监管的金融领域。未来“自动研究”或成为量化研究员的常规工作流,由人类设定框架、智能体团队自主探索。
谷歌发布 EmbeddingGemma 2 嵌入模型,可将文本、代码、图像等映射到 768 维空间。Qdrant 测试其内存优化:全尺寸 1 比特量化向量仅需 30 倍更少内存,保留 99% 检索质量;256 维加重新评分可省 77 倍内存,保留 94.5%。建议优先压缩比特而非维度,从全尺寸 1 比特量化起步。
作者在RTX 4090 24GB上以Strata替代Ollama推理Qwen3.8-Flash-Next(512专家MoE),专家权重驻留内存、GPU仅缓存热专家,配256K上下文与int8 KV。解码中位约100–110 tok/s,冷预填充约2500–2800 tok/s。官方GSQ-RCO IQ3_S量化优于Unsloth,整体探索时间从12分钟降至8分钟。服务单请求串行,两三人使用尚可。
文章介绍vLLM推理优化课程:先讲解KVCache原理,32K上下文约占16GB显存;再介绍LLM Compressor通过量化与稀疏化降低显存搬运,如W4A16将权重压至4bit。作者用Qwen3-0.6B实测,模型从1.41GB减至528.7MB,缩减64%,但困惑度上升21.6%,说明量化需权衡效果。
文章以 OpenVINO 2026.4 等版本发布为引,说明模型权重需经导出、优化、量化、运行时加载与输入输出适配才能在本地运行,并介绍 IR、NNCF、GenAI 等组件的作用,给出 CPU 文本生成的最小实践。文章还指出四大误区:导出成功不等于可用、低精度未必更快、内存不足并非仅由权重导致、依赖需锁定版本,强调应固定版本并建立质量基线。
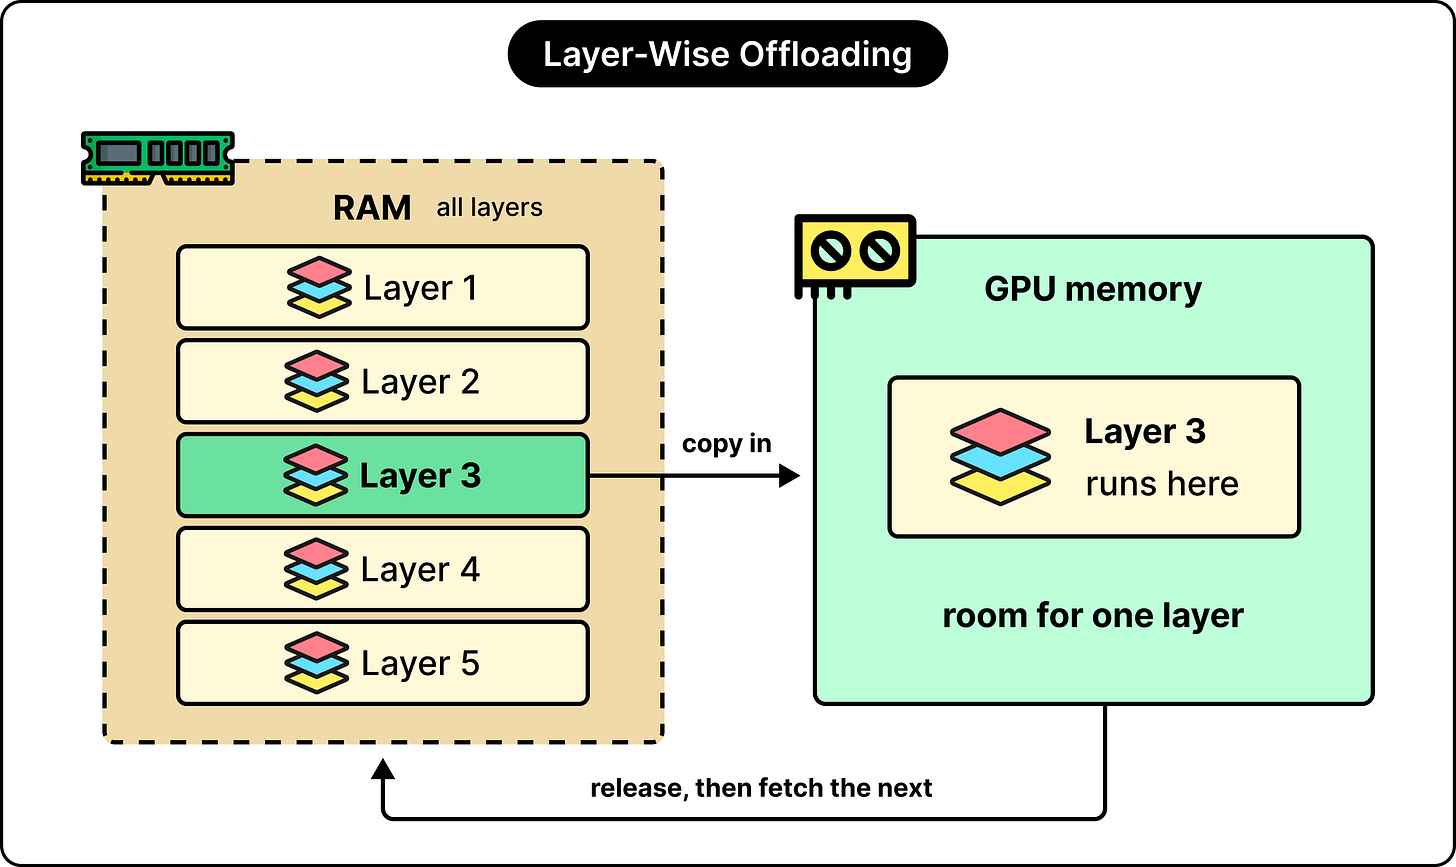
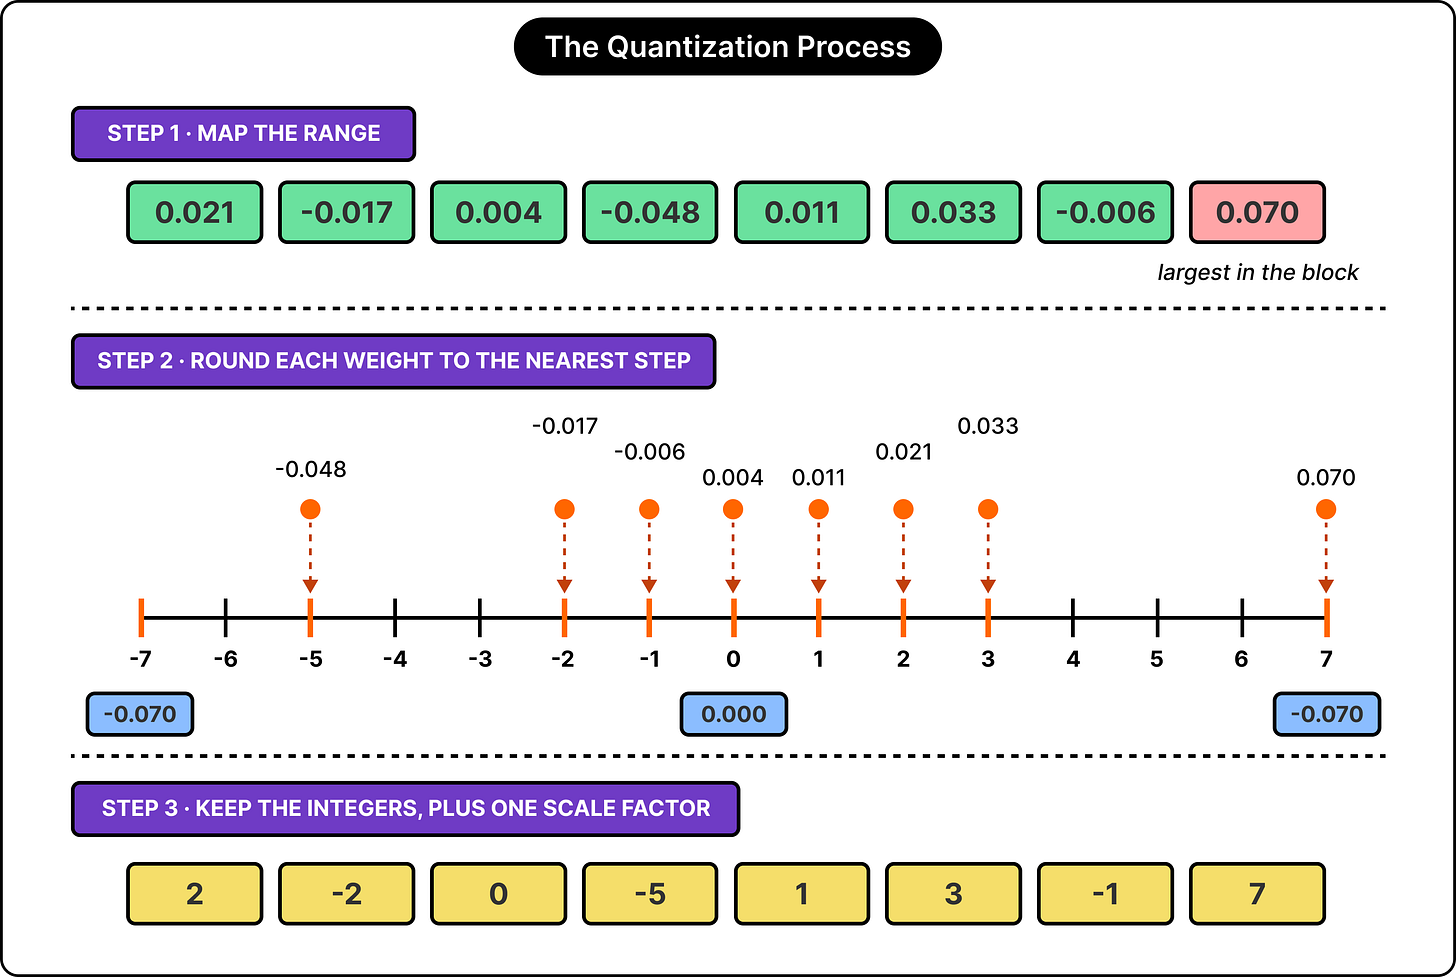
大模型在普通硬件上运行需降低内存占用与计算量。主要技术包括:量化压缩权重精度(如8B模型从16GB降至4GB)、分层卸载按需将权重移入GPU、混合专家仅激活部分参数、蒸馏用小模型学习大模型、剪枝去除低贡献权重、推测解码用小模型预生成再验证。KV缓存和FlashAttention等软件优化也能提升效率。目标是在硬件预算内平衡质量与响应速度。
RQ-VAE通过多级残差量化解决VQ-VAE码本受限和量化误差大的问题:每级量化前级残差,表征容量达K^D,模型规模仅线性增长,并能学习由粗到细的层次语义,广泛用于推荐系统。
本文介绍DeepSeek-V4模型结构中MoE层的四处改动:路由打分从sigmoid改为sqrt(softplus)以消除饱和;前三层用固定hash routing替代稠密层;增加极小序列级平衡损失;SwiGLU加硬截断防离群值。模型采用FP4量化,61层全MoE,每token激活6个expert,稀疏度64,总参数约49B。
本文批判静态用户画像的局限,主张用动态行为特征提升预测模型。核心方法包括:测量行为速度与加速度、评估功能使用深度、计算决策摩擦,并借鉴线下购物心理学映射线上信号。针对稀疏数据,采用零膨胀嵌入和频繁子轨迹挖掘。最后以零售需求预测为例,展示从数据采集到特征工程的实践路线,强调动态特征优于静态快照。
本文介绍了三种压缩大型语言模型的技术:量化、剪枝和知识蒸馏,它们能在不显著降低智能水平的前提下减小模型规模。这些技术可叠加使用,但各有取舍,如量化可能损失细微理解力,剪枝影响复杂逻辑,蒸馏可能缺乏原创性。选择哪种技术取决于模型的具体应用目标。
AQuA系统由普林斯顿、蚂蚁和斯坦福团队开发,用于自主量化交易研究。它通过分离数据路径与评价规则,防止数据泄漏和过拟合,使Agent能可靠积累证据。实验显示,因子研究IC达0.190,模型预测IC为0.0843,样本外Sharpe达2.50。该系统强调研究过程的可靠性,而非仅依赖模型智能。
推理软件栈的微小差异(如注意力后端、KV缓存量化、权重量化、张量并行度)会导致本地部署的大模型在长上下文中输出不同token,甚至工具调用失败。实验显示,INT4 KV缓存和NVFP4量化翻转率最高,而BF16和特定INT8方案更稳定。这些数值漂移累积后,模型可能做出致命错误决策,且难以排查。
本文介绍量化和剪枝两种模型压缩技术,用于减小大语言模型体积、降低成本并提升推理速度。量化降低权重精度(如4位),剪枝删除冗余权重。文中详述五种方法:bitsandbytes、GPTQ、AWQ、SparseGPT和Wanda,并建议先剪枝后量化,根据需求选择合适方法,以在保持性能的同时实现高效部署。
该研究将大语言模型视为信息处理规则,通过贝叶斯更新偏差衡量其内部一致性。实验发现,非贝叶斯启发式更新常优于精确贝叶斯更新,表明模型世界模型存在错误设定。该度量可用于诊断LLM推理系统问题。
Qdrant向量数据库通过量化与重打分机制应对向量集合超出内存的情况:量化在内存保留压缩副本,原始向量移至磁盘;TurboQuant通过旋转向量均匀分布误差,bits4为常用默认值;重打分读取原始向量修正压缩误差,但增加磁盘读取开销。测试表明,1比特量化配合重打分和过采样可将召回率从0.605恢复至0.951,接近float32基线。建议固定量化副本、原始向量冷存储,并启用io_uring异步读取。
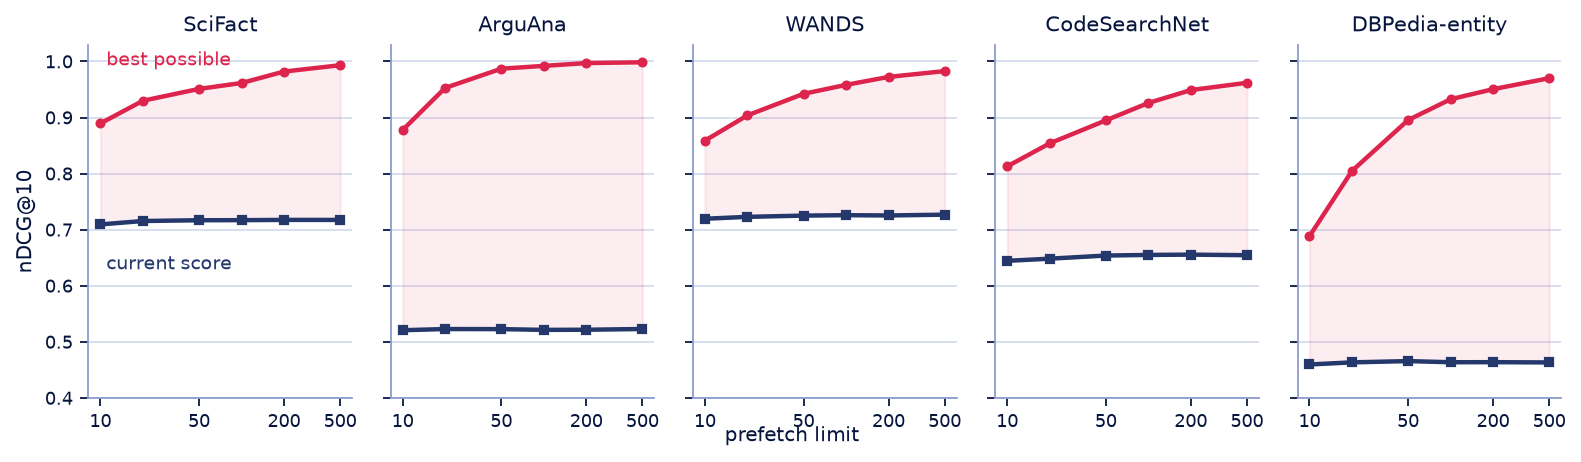
本文讨论检索系统中候选深度(candidate depth)的调优方法。建议先设置基线,测试100-200的limit值,并对比近似搜索与精确搜索的召回率。增加候选可提升最佳可能分数,但需权衡延迟。当RAM受限时,优先考虑量化而非降低深度。hnsw_ef仅在召回率未饱和时调整。最后根据最佳可能分数与当前分数的差距,决定优化排序或检索。
完成下面两步后,将自动完成登录并继续当前操作。