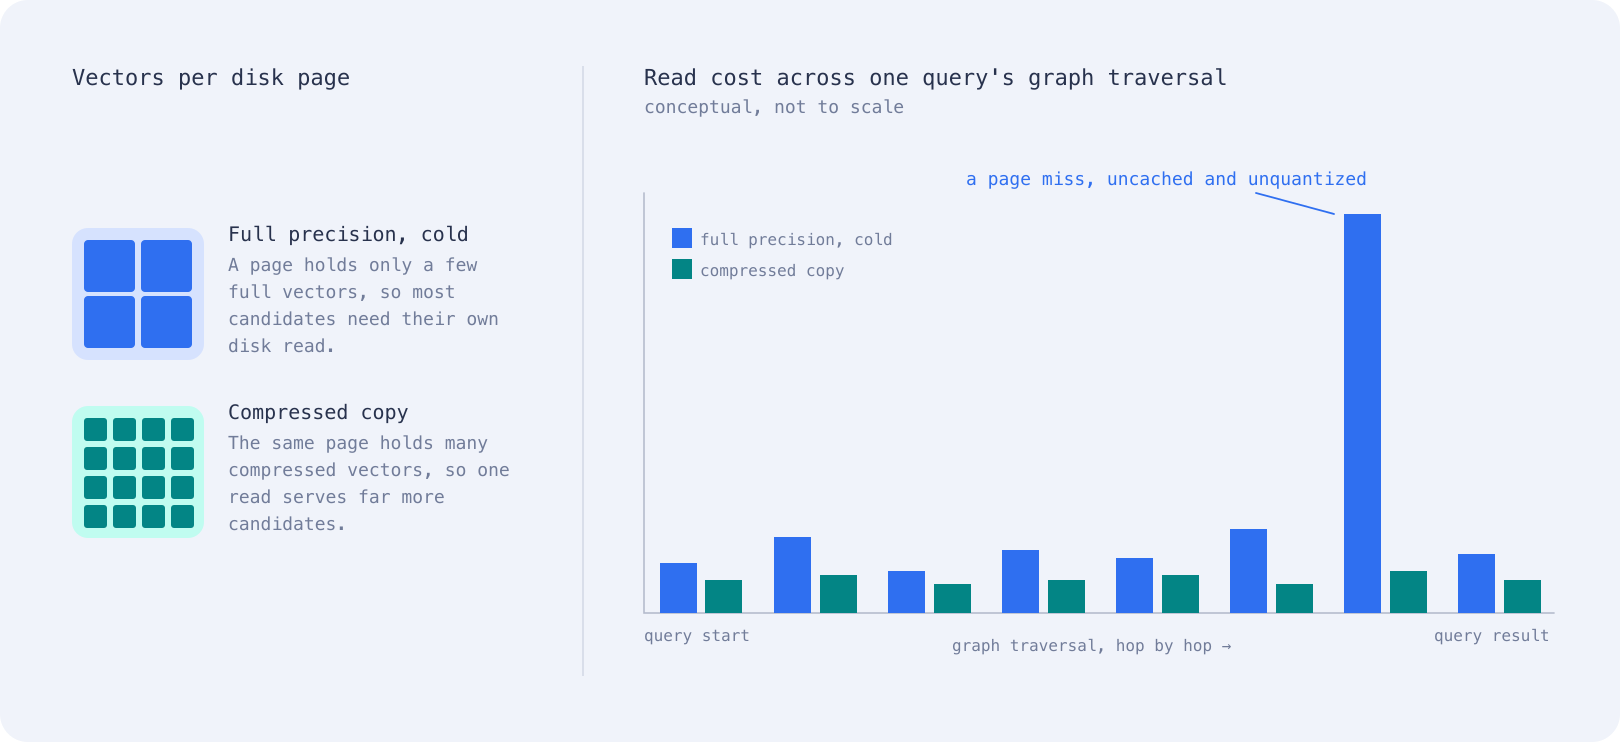
Qdrant 通过固定、缓存、冷存储三层管理内存,并结合量化压缩向量。小集合可全部缓存;内存瓶颈时固定量化向量副本以兼顾速度与低占用;磁盘受限时先量化再转冷存储。避免同时缓存全精度与压缩副本,谨慎使用 HNSW 内联存储。
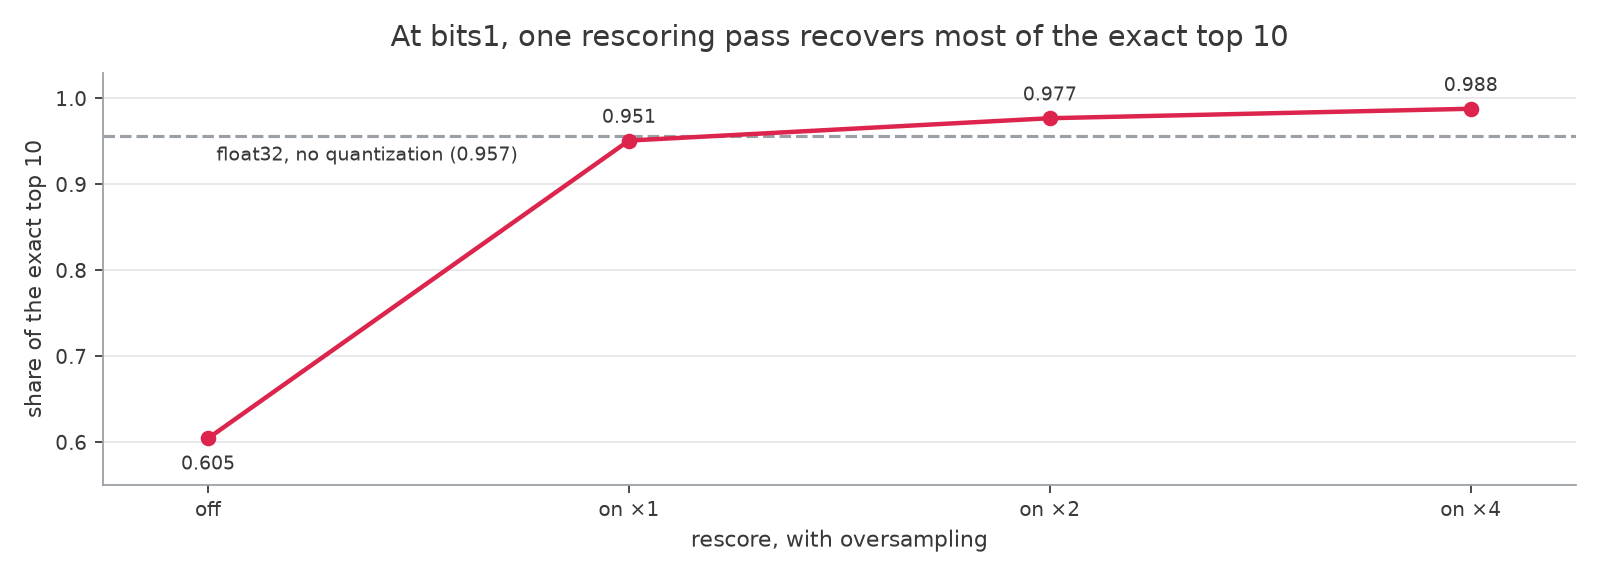
本文介绍Qdrant向量数据库在集合超出内存时的优化方法。通过量化压缩向量(如TurboQuant bits4)并固定压缩副本在RAM中,原始向量移至磁盘,可减少内存占用。重打分(rescore)虽增加磁盘读取,但能恢复精度,尤其对低比特量化(如bits1)效果显著。建议从bits4开始,根据测试调整参数,并验证召回率与延迟。
turbovec是一个基于Rust的向量索引库,采用谷歌TurboQuant算法,提供Python绑定。它通过量化压缩将内存占用减少8-10倍,速度比FAISS快3.4倍,支持无训练、增量持久化和过滤搜索。适用于本地RAG应用,但需注意输入向量需L2归一化,且不同配置下召回率表现不一。
通义千问发布2.4万亿参数开源模型Qwen3.8-2.4T,权重达4.9TB,普通硬件无法运行。量化压缩至FP8仍超消费级显卡极限,且无QAT优化,性能受损。开源版剥离视觉功能、缩短上下文,实为商业引流。1bit压缩虽减至397GB,但精度损失严重。模型性能跑分高但实际存疑,价格战加剧硬件负担。大模型竞赛受物理限制,普通用户难以参与。
OpenAI宣布通过新技术将推理成本降低一半,可能影响AI服务价格。这项技术包括量化压缩和投机采样,显著减少计算资源需求。尽管节省成本,用户体验仍是关键,可能影响模型精度。未来节省的成本可用于更大规模模型训练或复杂AI应用开发。
该文综述扩散模型与语言模型的量化压缩研究,涵盖基于信噪比的全局与局部量化策略及EfficientDM、Diffusion-LM、QuantEase、DPQ、PQLM、量子扩散模型、token对比蒸馏、SDQ等方法,可在低位量化与高压缩率下保持模型性能。
完成下面两步后,将自动完成登录并继续当前操作。