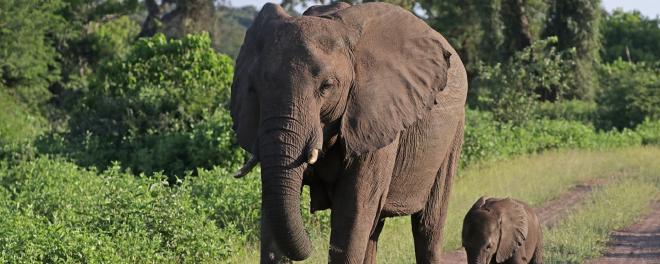
昆腾动力具身机器人已进入菜鸟等物流仓,在称重量方、供包、拣选等场景完成PMF验证,获近5000台订单。其双臂机器人供包效率超1200件/小时、成功率99%,并通过真机数据闭环快速迭代。公司还与科捷、顺丰合作推进出海,计划12月底发布全新构型机器人。
CloudNativePG于2025年11月2日正式成为CNCF孵化项目。该项目2019年在2ndQuadrant启动,2022年开源,2025年进入沙箱阶段。孵化意味着项目通过了安全、成熟度、治理和多组织采用等方面的严格审查,成为厂商中立的社区项目。项目将改革治理结构,限制单一公司席位,并计划于2027年申请毕业。
开源UEFI固件项目TianoCore EDK II披露严重漏洞CVE-2026-97631,影响PXE网络启动阶段。攻击者可在设备PXE启动窗口发送超过504字节的特制ICMP错误消息,导致缓冲区溢出、内存损坏,甚至系统加载前执行代码。AMI、Insyde、Phoenix等厂商固件均受影响。上游修复已于10月15日合并,但需厂商适配发布固件。建议暂时禁用PXE启动,或隔离网段并限制未经授权的ICMPv4/v6流量。
本文是湖仓引擎系列最后一篇,介绍存储抽象与访问层:定义Backend接口(Put/Get/Delete/Exists),实现本地文件系统与S3两种后端,并通过构造函数注入使引擎不依赖具体存储;元数据位置与数据位置相互独立,可分别存放于Postgres和S3,便于DuckDB、Spark、pandas等多引擎共享同一目录;提供CLI REPL,支持建表、插入、扫描、删除、时间旅行等命令;开放表格式由标准Parquet、SQL元数据和约定三部分组成。
本文介绍湖仓表的删除与更新机制。由于Parquet文件不可变,系统采用位置删除文件记录被逻辑删除的行位置,扫描时跳过这些行。删除策略分为写时复制与读时合并,DuckLake采用后者。DELETE操作先扫描匹配行位置,再写入删除文件并登记元数据;UPDATE在同一事务中拆分为DELETE加INSERT以保证原子性。扫描时加载删除位置并过滤。该方案避免重写大文件,代价是读取开销增加,可通过压缩定期合并缓解。
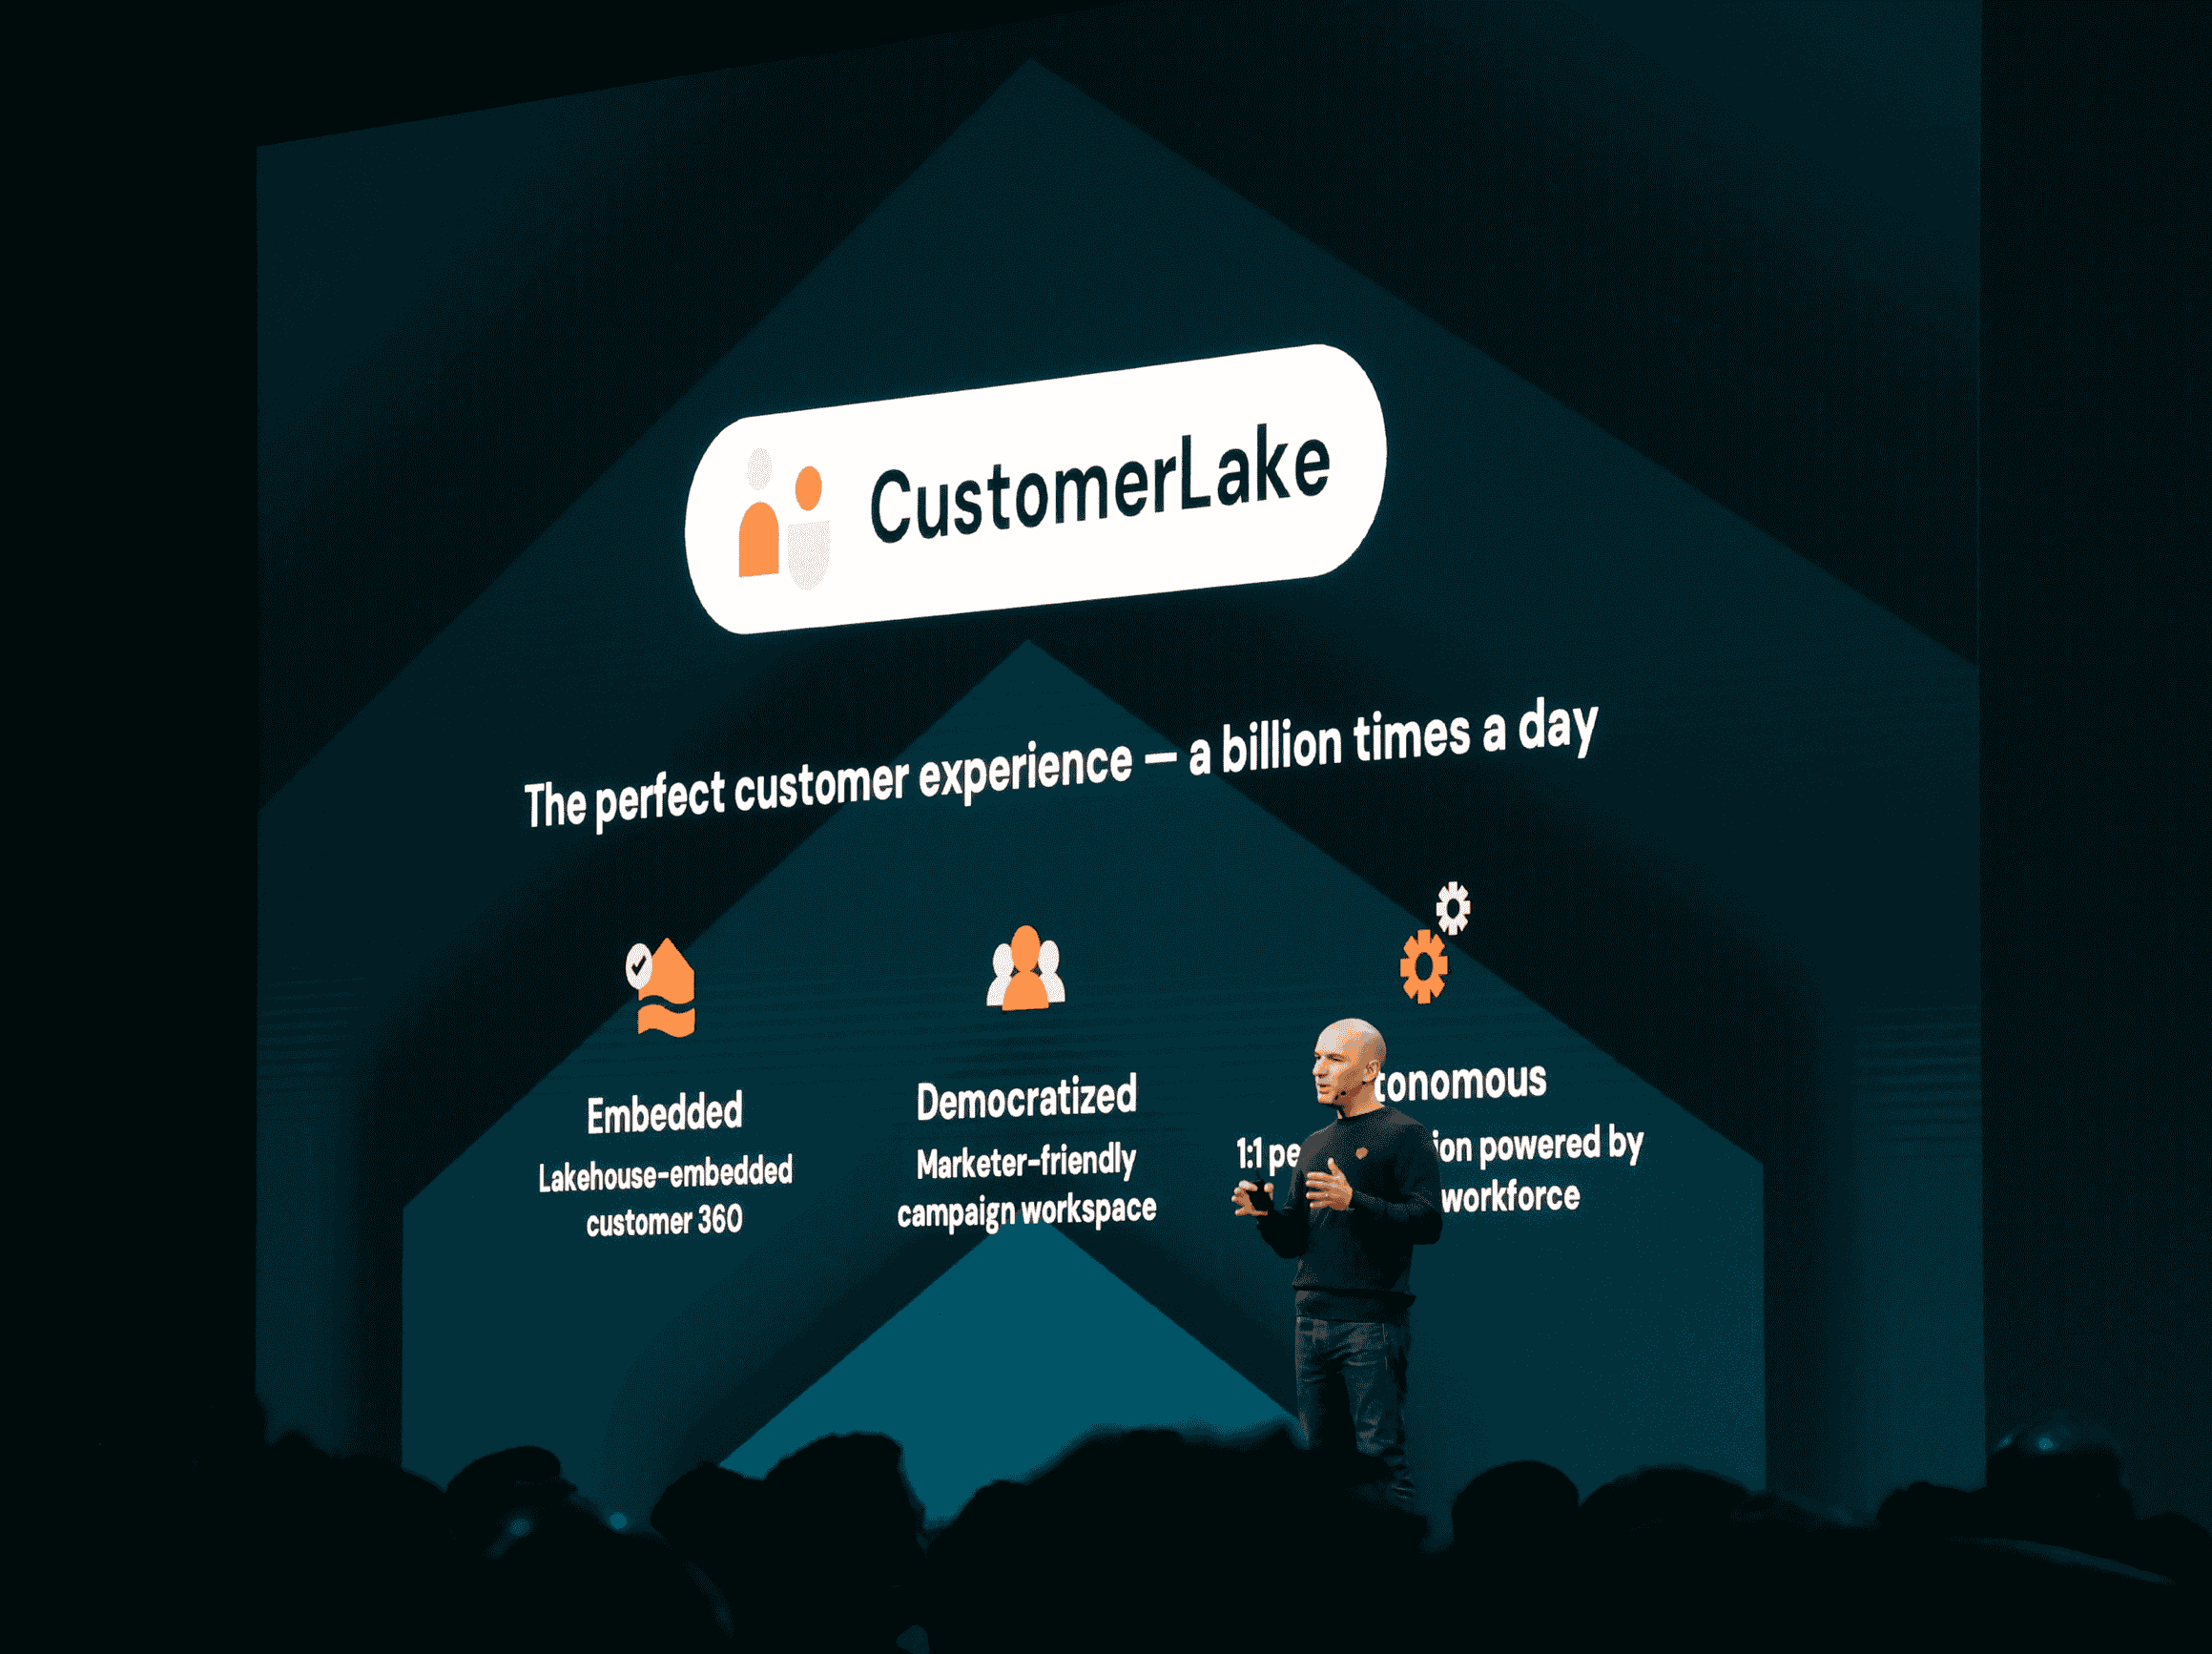
Databricks推出嵌入式Agentic CDP产品CustomerLake,Campaign Agents进入Beta,Profile Agents开启私测。HP、Getnet、AB InBev旗下Zé Delivery、Wine.com及费城联合等客户反馈:受众构建提速90%,CDP成本有望降40%,营销团队可自助建受众并同步至Braze等平台。Databricks自用该工具为峰会做个性化推荐,转化率提升10个百分点。
湖屋中的Parquet文件不可修改,模式演进通过元数据实现:每列创建时分配不可变字段ID并写入文件,读取时按ID映射,无需重写数据。新增列分配新ID,旧文件缺失该ID则填NULL;删除列仅设结束快照,保留历史以支持时间旅行;重命名列不改ID,旧文件自动适配。模式版本仅在结构变更时递增,以保证同版本文件可安全合并。
特斯拉新一代Roadster历经近十年终于投产,但时机不佳:美国电动车市场低迷,需求放缓,多家车企收缩电动计划。该车性能惊人,却因长期跳票被视为“空头支票”,且超跑市场对纯电接受度低。特斯拉重心已转向AI与自动驾驶,Roadster更像被时代抛下的遗物。
湖仓快照与时间旅行机制:每次增删改生成递增快照ID,记录表、列和数据文件状态,元数据行以可见区间标记生效与失效。查询时传入历史快照ID可回溯任意版本,实现一致性读取。快照表记录变更历史,支持审计与调试。
湖仓查询阶段中,SELECT 查询先解析表与快照,获取该快照的数据文件,再利用列统计信息裁剪文件,跳过不可能匹配的文件。存活文件随后过滤删除行、读取 Parquet、按谓词筛选并投影列。统计裁剪、删除过滤、列投影和缺失列补 nil 共同实现高效扫描与模式演进。
JetBrains 宣布基于 LSP 的“Java and Kotlin by IntelliJ IDEA”扩展进入候选发布阶段,即将发布 1.0 稳定版。该扩展将 IntelliJ IDEA 的 Java 与 Kotlin 智能功能带入 VS Code、Cursor 等第三方编辑器,支持代码补全、导航、检查、重构、调试、Maven/Gradle/Bazel 及测试运行,并可供编码代理使用。RC 版可免费试用 30 天,稳定版后需订阅 Ultimate。
亚马逊团队公开Rufus-Air八阶段后训练配方:先用可自动验证的硬奖励建立能力,再引入主观软奖励,每阶段须通过回归门禁。难度过滤、奖励可靠性与基础设施同样关键。开发者应保存逐阶段检查点,监控目标收益及通用与安全回退,并设停止条件,而非照搬八步。
它石智航CEO陈亦伦在2026“跨国企业上海行”推介会上分享具身智能赋能工业转型。公司已实现基座模型、硬件迭代与规模化落地三级跃迁,自研AWE大模型及多款机器人,团队硕博占比超80%。未来将扩大研发、布局生产基地,构建“中国研发、面向全球”生态。
爱诗科技发布实时世界模型PixVerse R2,将LLM的Scaling逻辑引入世界模型。R2通过Omni Causal AR统一视觉、动作、音频等模态,并用Real-Time Acceleration蒸馏实现实时生成,解决能力与实时性兼顾难题。该架构可扩展至游戏、虚拟交互等场景,推动数字世界底座成形。
微软提出RAFT框架,将客服工单拆解为有状态的时间线条目链,在条目级而非整篇匹配进行检索。仅凭初始症状时,案例命中率达84.2%,高于传统RAG的67.3%。论文已被EMNLP 2026行业track接收,代码与评测集开源。但合成基准存在数据污染风险,Jira部分仅为方向性证据,且Case Hit不等于端到端解决率。
LightNav-0是一种基于Qwen3-VL-4B构建的紧凑通用具身导航模型,无需任务特定预测头。它通过双通道指向接口(可供性点与物体点)表达空间意图,并利用残差向量量化动作分词器将意图映射为10个SE(2)航点,实现精确连续控制。模型采用时间感知视觉历史压缩、具身推理中期训练、监督微调与强化学习,单一模型即可支持指令跟随、开放词汇物体导航和视觉跟踪,训练数据覆盖2K+场景、4K+小时。
文章讨论企业AI检索中的权限控制问题。核心观点是:权限不应作为事后过滤器,而应在“上下文组装”阶段结构性执行,即根据用户身份决定模型能看到哪些数据。文章以AWS、微软等平台为例,指出仅靠元数据过滤存在泄露风险,并强调需在系统间传递用户身份,确保授权在每一步被检查。
长时智能体上下文管理采用两阶段预压缩:用量达90%时后台摘要前缀,达100%时仅合并摘要与尾部增量,减少主循环阻塞。压缩保留原始记录与本地JSONL恢复指针,并冻结系统提示以维持缓存命中。优先裁剪旧工具输出,避免不必要的LLM摘要。实测每轮输入token降低40%,上下文稳定在约28万。
上篇文章《让炼丹更科学一些(七):步长调度与权重平均》我们简单介绍了无调度(Schedule-Free)学习率的工作,它试图通过某种权重平均来替代学习率调度,实现常数学习率就可以训出最优模型的效...
面试中,一位表现激进的年轻人被另一VP否决,印象深刻。业务不明朗或财务保守的公司不喜欢激进员工,因需熬、省钱、减少内耗;业务高速发展时激进者吃香,能拿大结果就敢给钱。多数人不喜欢激进者,尤其下属。
完成下面两步后,将自动完成登录并继续当前操作。