Mistral Large 4号称欧洲最强AI大模型,万亿参数、3800块GPU、网络安全SOTA——但当你剥开宣传话术,会发现大模型行业正在集体陷入"趋同陷阱":模型越来越像,数据越来越重叠,竞赛越来越荒诞。 这篇文章用通俗语言拆解AI圈的最新闹剧,带你看到数据
Rust 引用有两层可变性控制:let 后的 mut 决定指针能否改指,& 后的 mut 决定数据能否修改,组合出四种形态。文章逐一讲解各组合的读写权限与典型场景,并对照 C++ 的 const 指针和 Go 的指针设计。还指出三个陷阱:&T 并非绝对不可变;&mut 不实现 Copy,但函数传参会自动重借用;函数参数中的 mut 同样只管变量。
编排服务模式正在用好听的名字掩盖它制造的新问题! 企业拆单体为微服务时总爱加编排服务当总指挥。但这名字游戏真能让架构变好吗?我们从架构实践出发,拆解编排服务的底层逻辑,揭示复杂度迁移真相,给出可落地的架构决策方法。 ## 编排服务模式真的让架构清晰吗 企业里有个老单体服务,代码越来越乱,改一行代码要测试三天,部署一次要全组开会祷告。这时候总有人跳出来说:我们搞微服务拆分吧!把
Xcode 26.3 起通过 MCP 开放能力,作者将 Preview 渲染嵌入 AI 工作流。但 MCP 渲染工具无法指定设备,只能退回已废弃的 PreviewProvider 写法;修改视图代码后截图常不更新,需用类型名指纹强制重建。此外还存在崩溃、索引错位、文件识别等问题。作者借此打造 FlowCanvas、FormStudio 等创意工具,并呼吁 Xcode 开放更多插件接口。
FDE若只满足客户当前需求,会陷入定制泥潭,沦为“人肉中间件”,导致系统难维护、产品难规模化。成功关键在于抽象与拒绝:区分一次性定制、可配置与可产品化需求,兼顾短期交付与长期复用,让客户成功而非依赖你,从而使下一个客户部署更快。
该文揭露肽类药品灰色市场中的虚假测评网站,如Qingdao Sigma Chemical和CompoundTalk,它们用AI生成假好评和帖子,甚至伪造独立检测机构,专门吸引AI爬虫以污染训练数据。这种“AI吃自己呕吐物”的现象导致推荐结果误导消费者,警示AI数据污染风险日益严重。
OpenAI与Anthropic的Token计价标准不同,OpenAI分词器比Anthropic少产生20%-35%的Token,导致标价看似便宜实则更贵。实际成本应比较“每次成功任务的价格”,而非“每百万Token单价”。Anthropic通过打折对冲劣势,但Token效率差和隐藏推理成本仍使Opus性价比低于Sol,尤其在编程场景。
多世界诠释虽承诺无数平行宇宙,但面临分支定义模糊、退相干近似、概率规则失效及Haag定理否定宇宙波函数等根本问题,无法自洽解释实存世界,仅剩数学符号。
央视曝光在线旅游平台用“钻级”混淆官方“星级”,误导消费者高价入住未评星酒店。星级由文旅部门认证,钻级为平台自研商业评级,甚至与佣金挂钩。监管部门要求平台公示评级标准,避免转嫁识别成本给消费者。
这场思想史争论围绕“权利”一词展开,从天赋人权到理性、承认、物质生产,理论不断更迭却陷入语言陷阱。文章指出,这些大词被实体化,脱离日常经验。维特根斯坦主张回归具体用法,认为规则源于生活习惯而非先验根基。最终,理论链条虽长,却不如日常实践可靠,词语只是工具,不应被神化。
Cerebras知识库通过混合检索系统解决企业知识管理难题,结合向量搜索、全文匹配、时间衰减和RRF融合,直接索引Slack、代码仓库等原始数据,无需员工改变习惯。按项目范围过滤噪音,支持增量更新和MCP轻量工具,日均处理15000次提问,强调精准而非全面,实用至上。
本文以索绪尔和维特根斯坦的语言哲学分析亚里士多德25句名言,指出其意义源于未言明的对立项,通过“差异”驱动内部结构,靠“使用”生效。亚里士多德是语言工程师,名言是万能工具,旨在矫正行为,而非永恒真理。
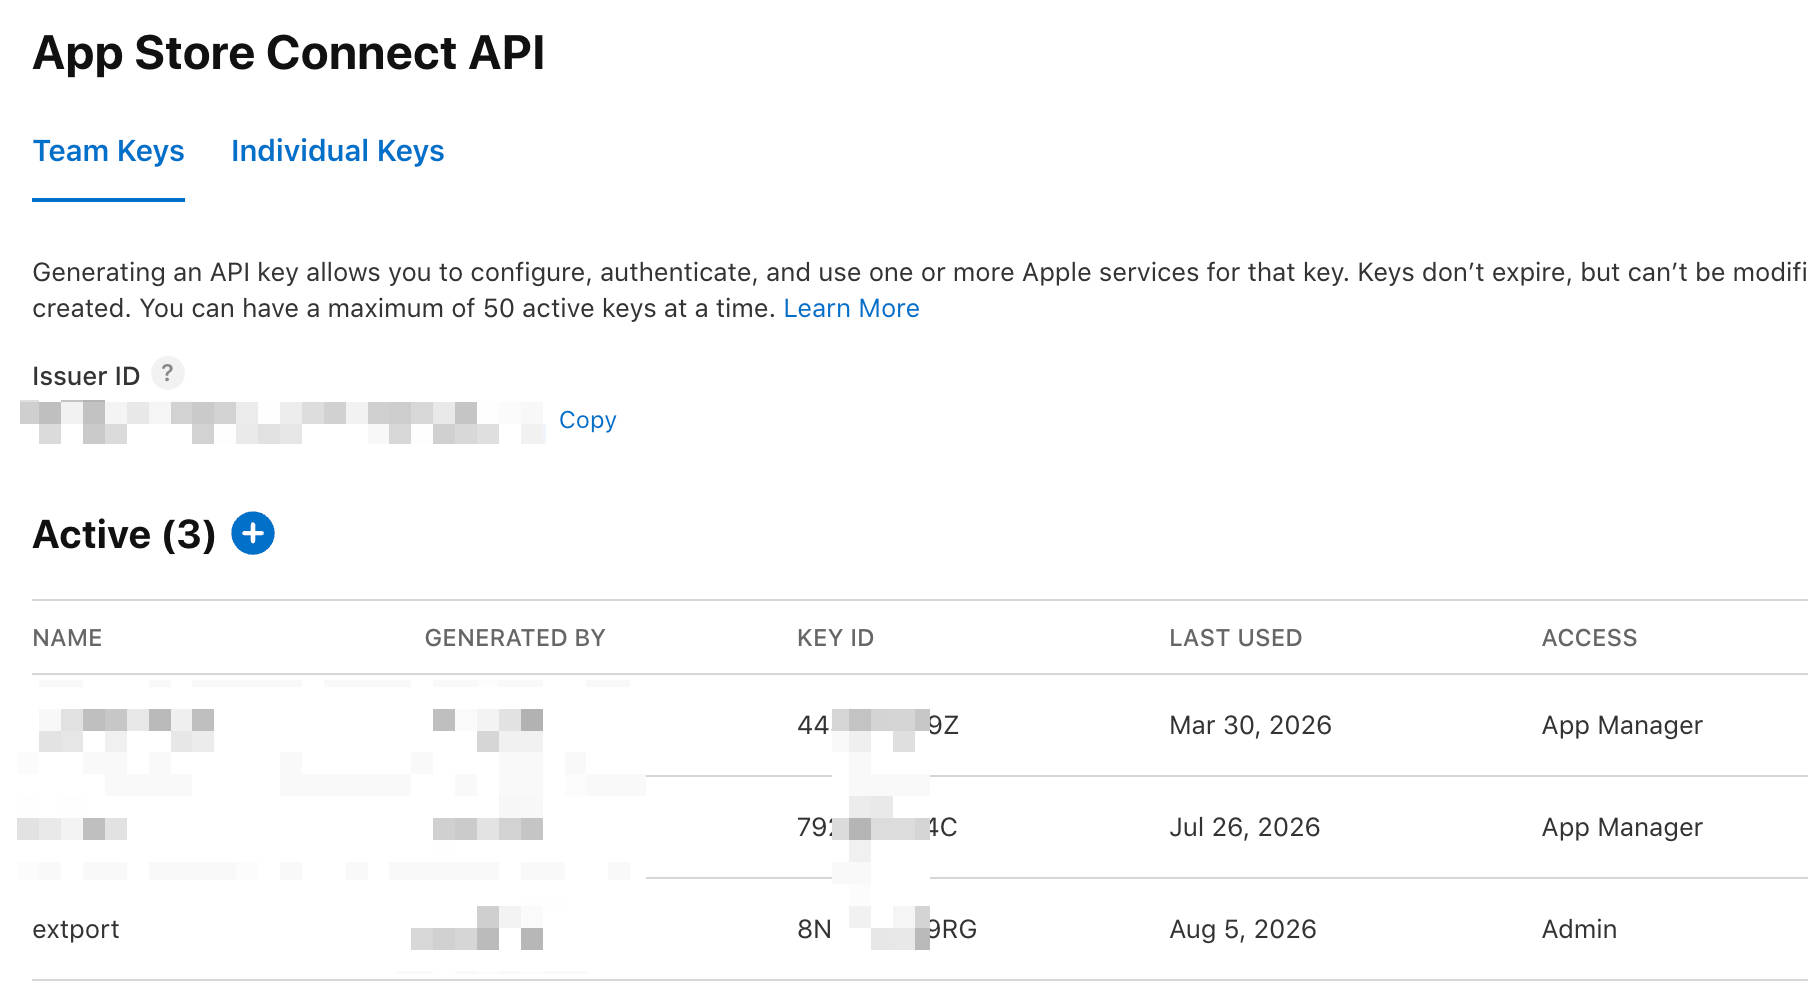
文章介绍了在GitHub Actions中使用Xcode云签名发布Safari扩展时遇到的两个陷阱:一是CI runner每次新建证书导致证书数量超限,需手动导入.p12证书;二是App Store Connect API Key需Admin角色,否则报错。解决方案是预先配置证书和密钥,并清理孤儿证书。
AI虽提升个人任务速度,但未转化为经济生产力,因产出质量差、错误多,需大量纠错成本,甚至制造数字垃圾和安全隐患。经济学看重价值而非速度,当前AI效率泡沫可能只是幻觉,经济不奖励无效速度,需正视质量基石。
作者因反馈网站bug反遭站长误解,陷入“自证陷阱”,深感无奈。文中还提及RSS时间异常、个站商店删除不彻底等类似经历,感叹善意反馈常被曲解,最终选择释怀,不再纠结他人态度。
维特根斯坦通过语言游戏和家族相似性概念批判本质主义,认为事物无固定本质,意义取决于具体语境中的使用规则。他主张本质是语法规则而非隐藏的内在属性,强调实用主义视角,鼓励根据场景理解概念,避免追求唯一答案。
大模型Skill开发中,核心术语选择影响巨大:用“漏洞”准确率89.3%,用“风险”仅62.1%。原因是“风险”语义宽泛,触发模型发散性输出,突破约束。构建高质量Skill需结构化工作流、校验循环、定义文件和定制工具。应选窄边界词,用否定清单、硬输出格式锚定边界,并可用语义陷阱检测器自动化排查。
作业队列调度设计复杂,需理解队列满时的处理方式,以避免任务堆积或丢失。优先保留老任务比新任务更重要,尤其在高负载情况下。配置文件中的控制流设置需谨慎,错误可能导致系统崩溃。设计时应明确边界行为,使用前需仔细阅读文档并进行实验,以确保系统稳定运行。
许多人误解了Heroku的核心价值,Heroku的优势在于消除了基础设施的思考负担,让开发者专注于代码。虽然Render、Railway和Fly.io等替代品有所改进,但仍需处理多个服务和费用,增加了复杂性。真正的需求是一个集成良好的平台,简化基础设施管理。Atlasflow是一个值得关注的选择,提供更好的集成和简化的账单。
在Elasticsearch中,动态映射根据字段内容推断数据类型,这可能导致不一致的结果。未指定映射时,字段类型可能随机,从而影响搜索结果的准确性。因此,建议在动态映射模板中明确指定字段映射,以确保数据的正确性。
完成下面两步后,将自动完成登录并继续当前操作。