Tim Ferriss与Kevin Rose讨论AI个人助理Instinct和Muse通过短信管理生活,代理购物可能冲击亚马逊而Shopify持开放态度。还涉及β-丙氨酸提升攀岩耐力、核桃改善精子质量、缓释肌酸、A2蛋白、梦境工程与麻醉梦境治疗创伤、脑刺激治抑郁、Cialis背痛、男士化妆品、新书写作与AI写作工具,以及《The Dark Wizard》等推荐。
蒂姆·费里斯与凯文·罗斯在《随机秀》中讨论了AI超级助手、智能购物、β-丙氨酸提升攀岩耐力、核桃与精子质量、梦境工程与麻醉梦境、助勃药物、男性化妆、新书计划,以及让-克洛德·范·达姆劈叉打赌等话题。
Jev是TypeSafe AI的决策模型,根据状态文本和问题输出概率、选项分布及期望评分,用于工单分派等场景。文章将其与古代占卜对比:两者表面相似,但Jev提供可校准、可验证的概率,占卜则用模糊叙事制造意义感。核心差异在于Jev摊开随机性,占卜隐藏随机性,而人类往往更渴望叙事闭合而非精确概率。
“老董工具箱”提供随机手机号生成器,可按数量、运营商和地区生成符合真实格式的号码,支持去重与导出,最多100个。号码仅供测试学习,禁止非法用途。
Wagtail是一个现代化的Django管理工具,提供比Django Admin更多的功能和更好的用户界面。本文介绍了如何将Wagtail作为管理替代方案。
中心极限定理(CLT)表明,无论原始数据分布如何,独立观测结果的平均值趋向正态分布。该定理解释了自然界中钟形曲线的普遍性,如身高和考试成绩。CLT广泛应用于科学研究,帮助判断异常情况,但需注意样本的独立性、样本量及极端事件的影响。
一致性哈希在分布式系统中常用,但其负载均衡效果不如Jump Hash、Rendezvous Hash和Maglev Hash。实验显示,使用150个虚拟节点的一致性哈希仍然不如其他算法。Jump Hash和Rendezvous Hash在节点数较少时表现优异,且实现简单。对于大规模系统,一致性哈希仅在特定条件下合理。
在本期《随机秀》中,Tim Ferriss与Kevin Rose探讨了禅修静修、迷走神经刺激、背痛突破、平衡训练工具、腱强化协议和光生物调节等主题。他们分享了冥想体验和健康见解,强调冥想对心理健康的积极影响。
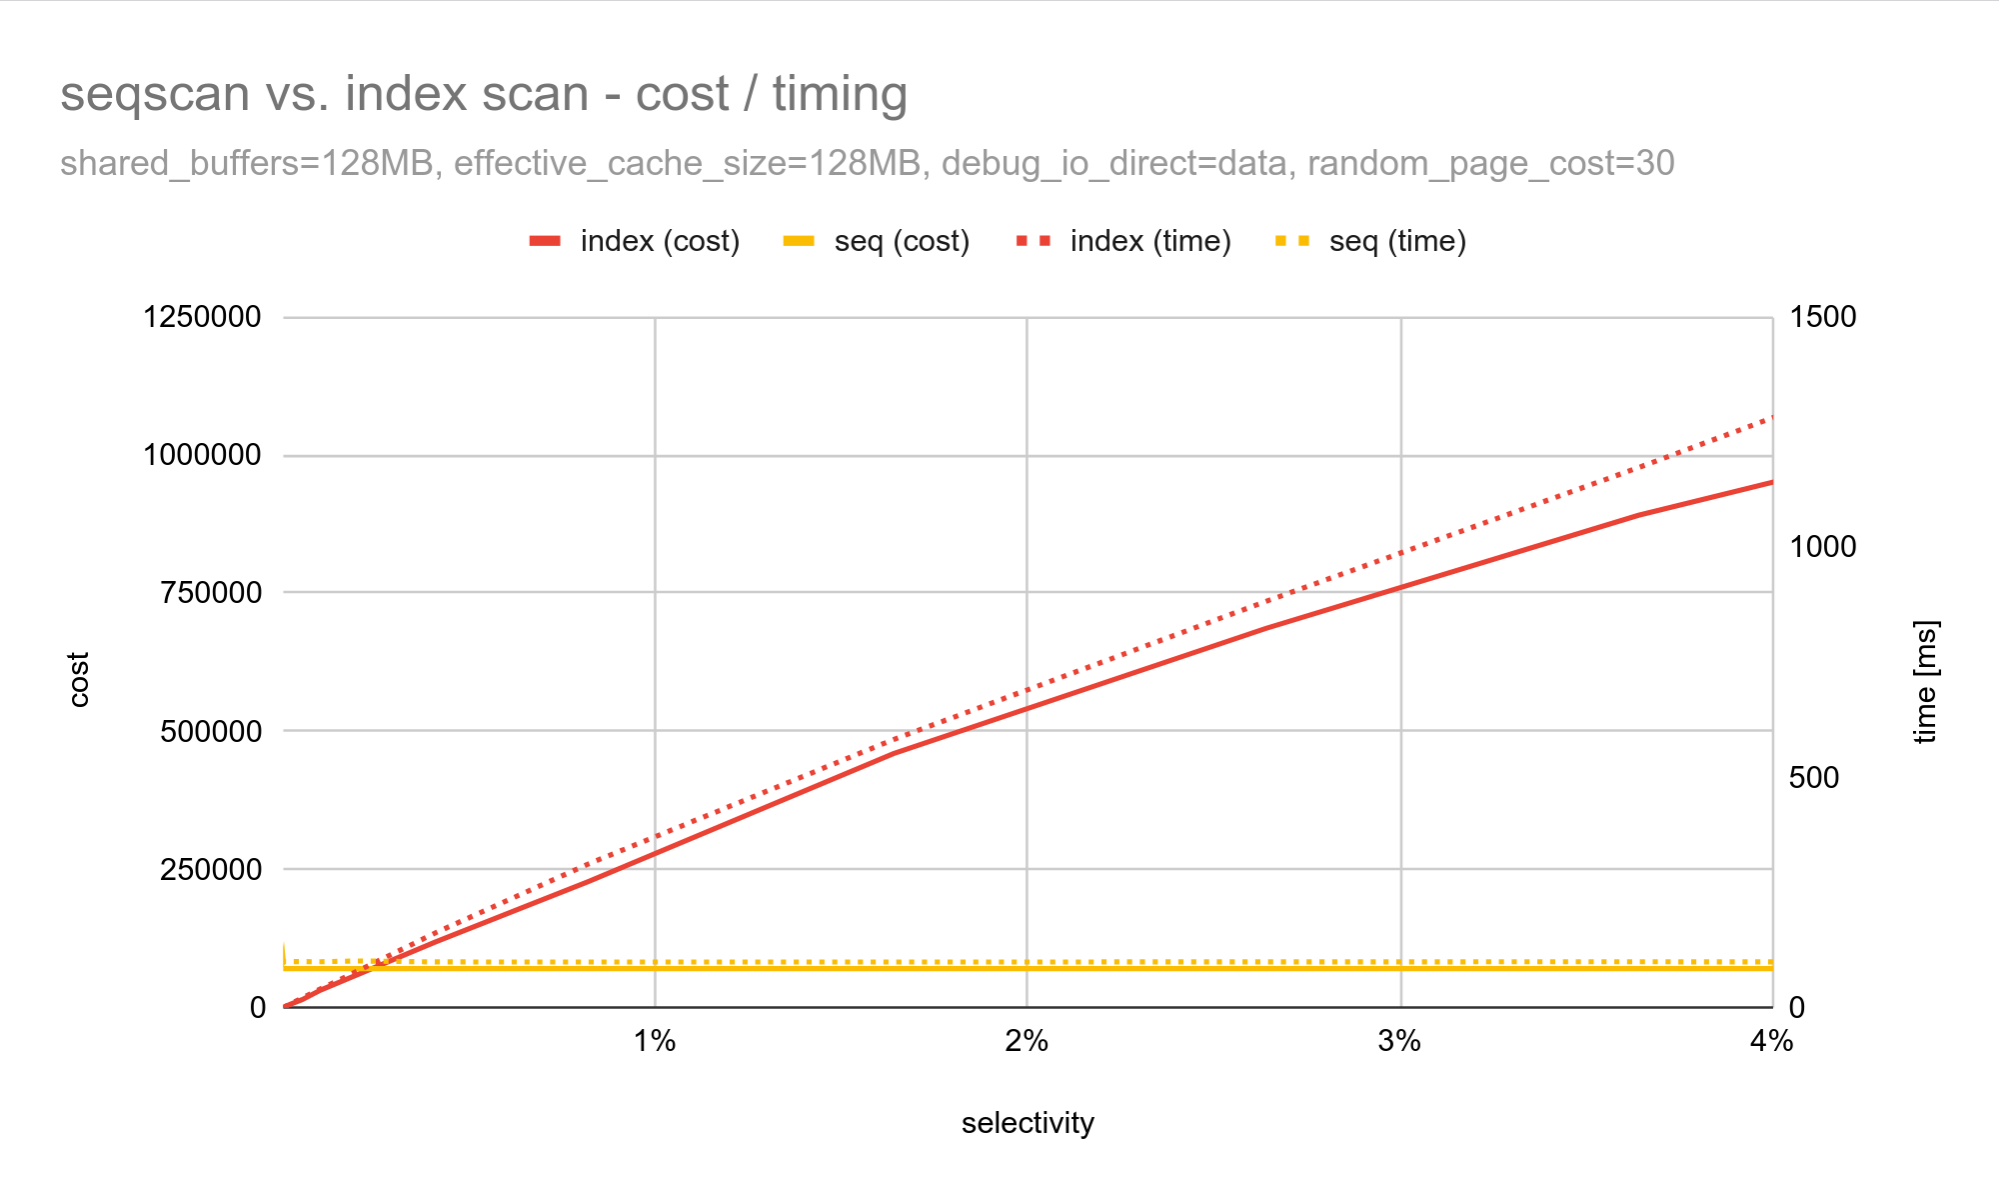
在Postgres中,随机页面成本(random_page_cost)的默认值为4.0,但随着存储技术的发展,这一数值可能不再准确。实验表明,实际的随机页面成本约为30,远高于默认值。调整该参数可能影响查询计划,尤其是在高缓存比率的OLTP系统中,随机I/O可能更具优势。建议在调整时监控性能,以评估影响。
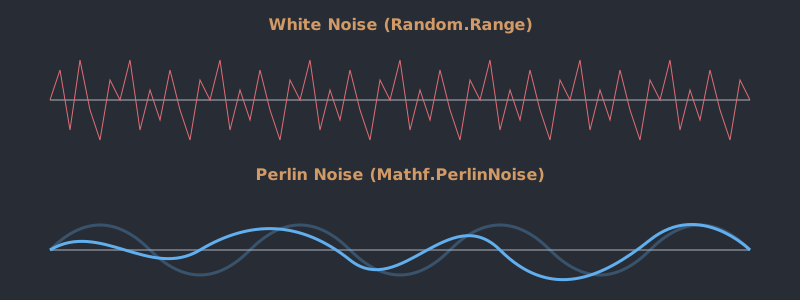
随机性是游戏重玩价值的关键,但计算机生成的是伪随机。程序化生成需要平滑的随机性,即噪声。常见的噪声类型有白噪声、柏林噪声和分形噪声。柏林噪声适合地形生成,因为相近输入产生相近输出;分形噪声通过叠加不同频率的噪声,模拟自然景观。
我正在进行一个项目,生成100个随机的正反面,检查每6次连续的正反面,并将结果存储在变量中,重复10000次。
蓝牙技术联盟发布蓝牙6.1版,新增随机可解析私有地址功能,提升隐私保护并优化电量消耗。该功能通过随机化地址更改时间,降低追踪难度,并将地址更改操作转移至控制器设备,从而延长配件续航。预计iPhone 17系列将支持蓝牙6.0,后续更新将支持6.1。
本研究探讨深度神经网络的可解释性,提出从几何角度理解特征与数据分布的关系。结果表明,特征可分为上下文特征、成分特征和表面特征,为机制可解释性提供了新见解,并指引未来研究方向。
文章提到作者制作了一支笔。
表情符号在现代交流中扮演着重要角色,能够快速传达情感和信息。随机表情符号生成器为内容创作增添乐趣和灵感,帮助打破创作瓶颈,提升互动性。
在2025年的特别节目中,Tim Ferriss与Kevin Rose讨论了未来预测,包括人工智能、比特币、外星人和健身目标。他们分享了新年决心和策略,强调财务管理和健康生活的重要性。
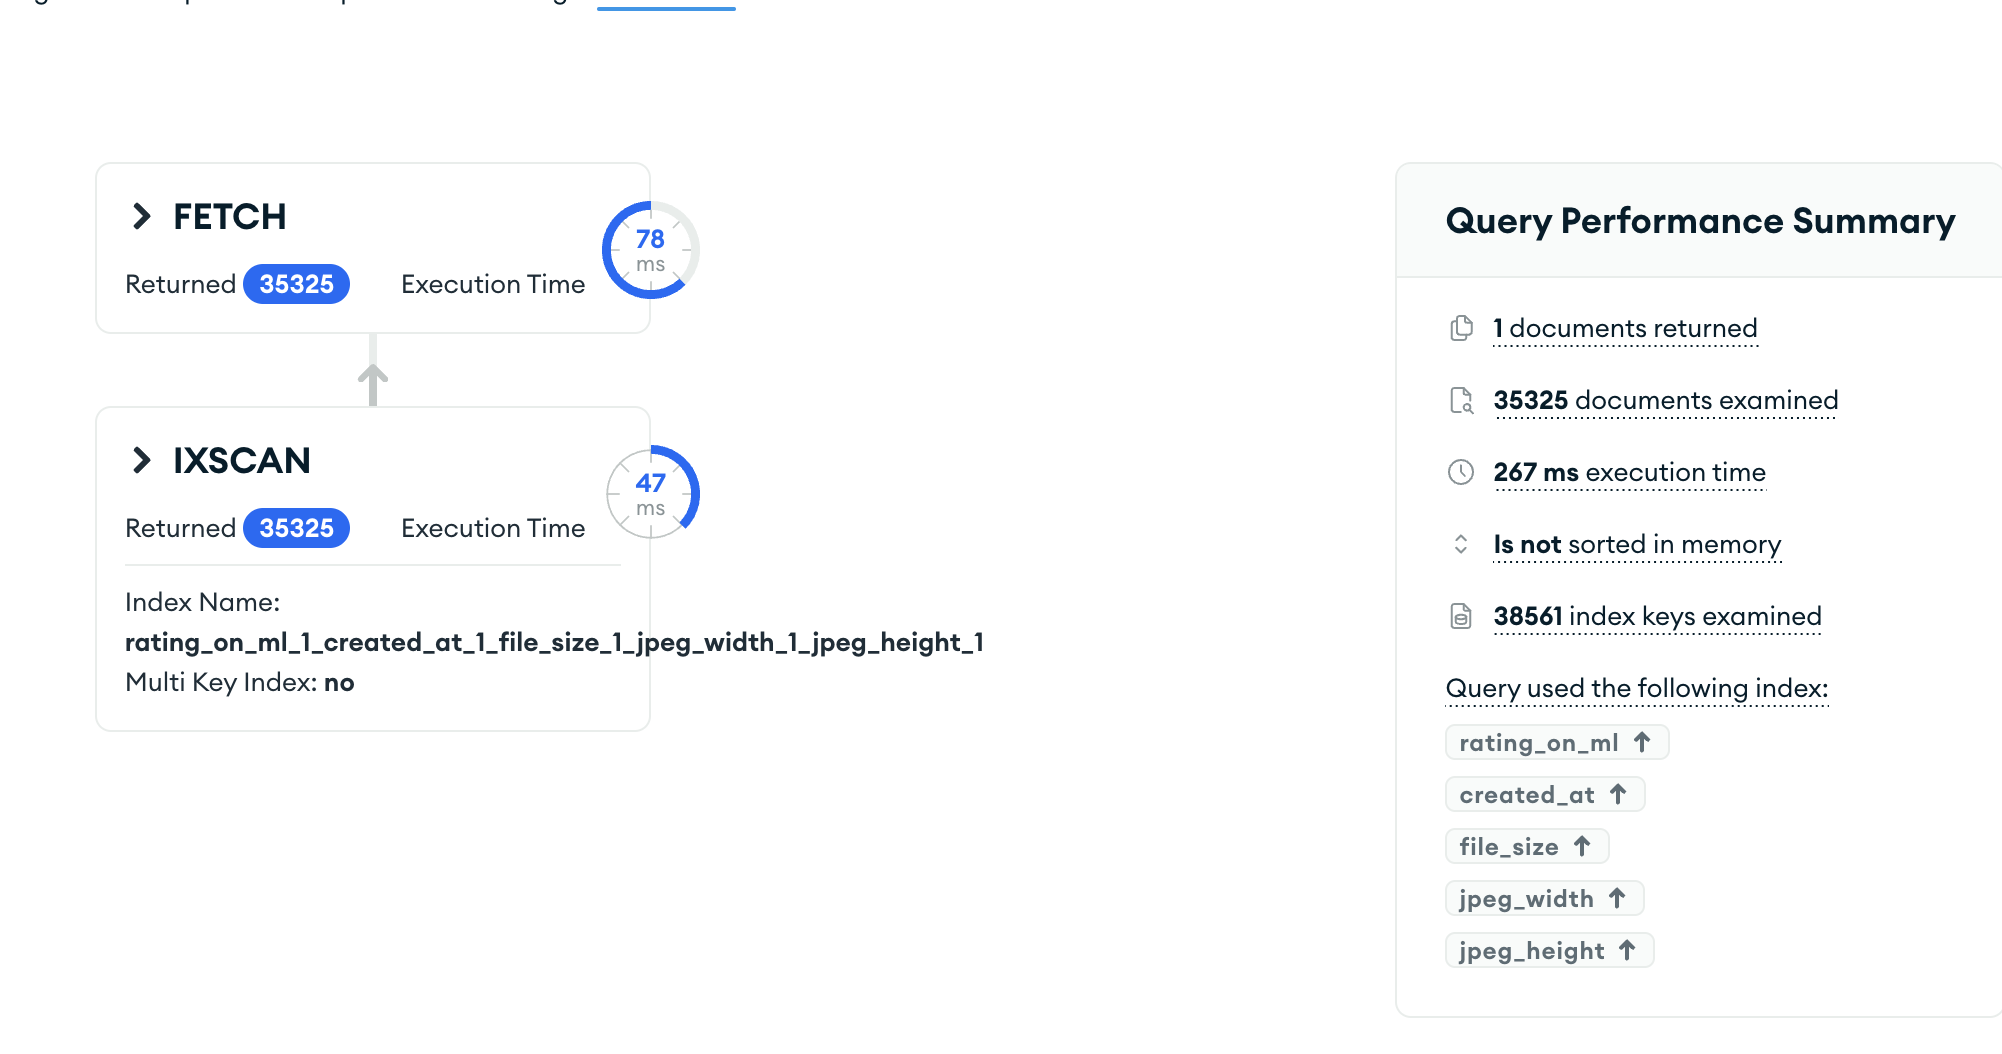
该项目使用MongoDB存储二次元壁纸的元信息。随着请求量增加,查询速度成为问题。通过添加索引和实现查询缓存,查询延迟从360ms优化至2.6ms,显著提升了响应速度,降低了数据库负载。
本文提供了一些实用的SQL代码示例,帮助解决SQL开发中的常见挑战,包括生成序列号、数据透视、检查表存在性、创建表、日期计算、合并行和公共表表达式,以简化日常SQL任务。
本研究解决了现有自回归视觉生成模型在生成顺序上的限制。通过引入“位置指令标记”,RandAR允许以随机顺序生成图像,并且在训练过程中以随机排列的标记序列进行,从而表现出与传统顺序生成的模型相媲美的性能。RandAR在推理时实现并行解码,提升生成效率,并在不牺牲质量的前提下实现了2.5倍的加速,展现了在多种应用场景中的潜力。
本文介绍了PyTorch中的三种梯度下降方法:批量梯度下降(BGD)、小批量梯度下降(MBGD)和随机梯度下降(SGD)。BGD使用整个数据集,收敛稳定但易过拟合;MBGD将数据集分为小批量,收敛不如BGD稳定,但适合大数据集;SGD逐个样本更新,收敛波动大,但能更快逃离局部最优解。
完成下面两步后,将自动完成登录并继续当前操作。