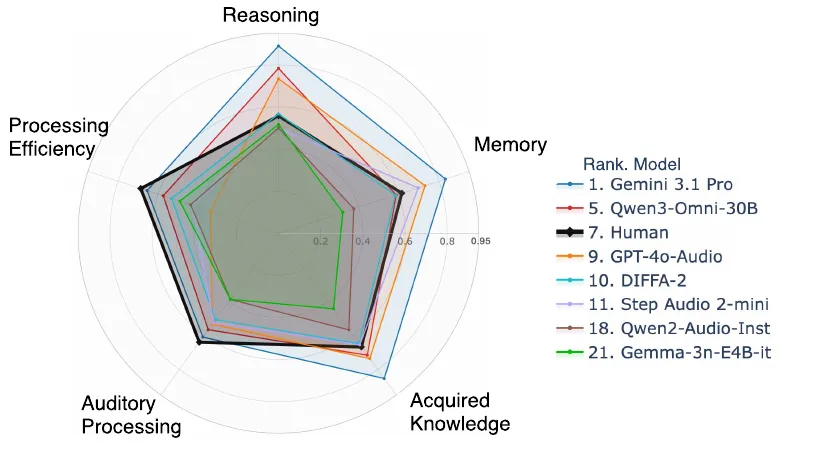
RAIL借鉴CHC认知框架,将音频评测重构为听觉处理、推理、记忆、知识、处理效率五类能力、32项细分任务,构建5306条样本。评估26款音频大模型发现:模型善用语义线索但精细声学感知弱;语音记忆强而非语音记忆普遍不足60%;多步顺序推理易出错;推理预算利用效率差异明显。研究主张按能力维度定位短板,推动音频模型在感知、记忆与效率上改进。
本文介绍如何让Mac同时向多个耳机或音箱输出音频,以便与朋友共享影音。方法是使用macOS自带的“音频MIDI设置”创建聚集设备,并参考苹果官网教程;使用AirPods时建议关闭入耳检测功能。
微软发布 Windows 11 月度累积更新 KB5127648,适用于 24H2、25H2、26H2 版本,修复登录后黑屏、AC-3 杜比数字音频无法播放问题,并修补大量安全漏洞。24H2 消费者版支持已结束,建议升级至受支持版本。
文章介绍用 Java 17 实现音频转写上传前的本地校验:检查文件可读性、扩展名和 20MB 业务上限,生成 SHA-256 短审计 ID,再以带 45 秒超时的 multipart 请求提交转写。日志仅保留不可逆哈希,不含音频或全文。强调授权、隐私与删除机制应优先于便利,扩展名校验不等于安全,生产环境应检测 MIME、时长并采用流式上传。
Cloudflare 发布开放权重决策模型 Clef-omni,基于 Qwen3-Omni 的 30B-A3B MoE,采用 Apache-2.0 许可,每百万 tokens 收费 0.15 美元。该模型可在一次调用中对文本、图像、音频和视频打分,省去转录步骤,在意图分类任务上领先,但推理与工作流评测弱于 Clef。同时 Clef-flash 降价至 0.038 美元,托管 Clef 迁移 SGLang 后提速 1.7 至 2 倍。
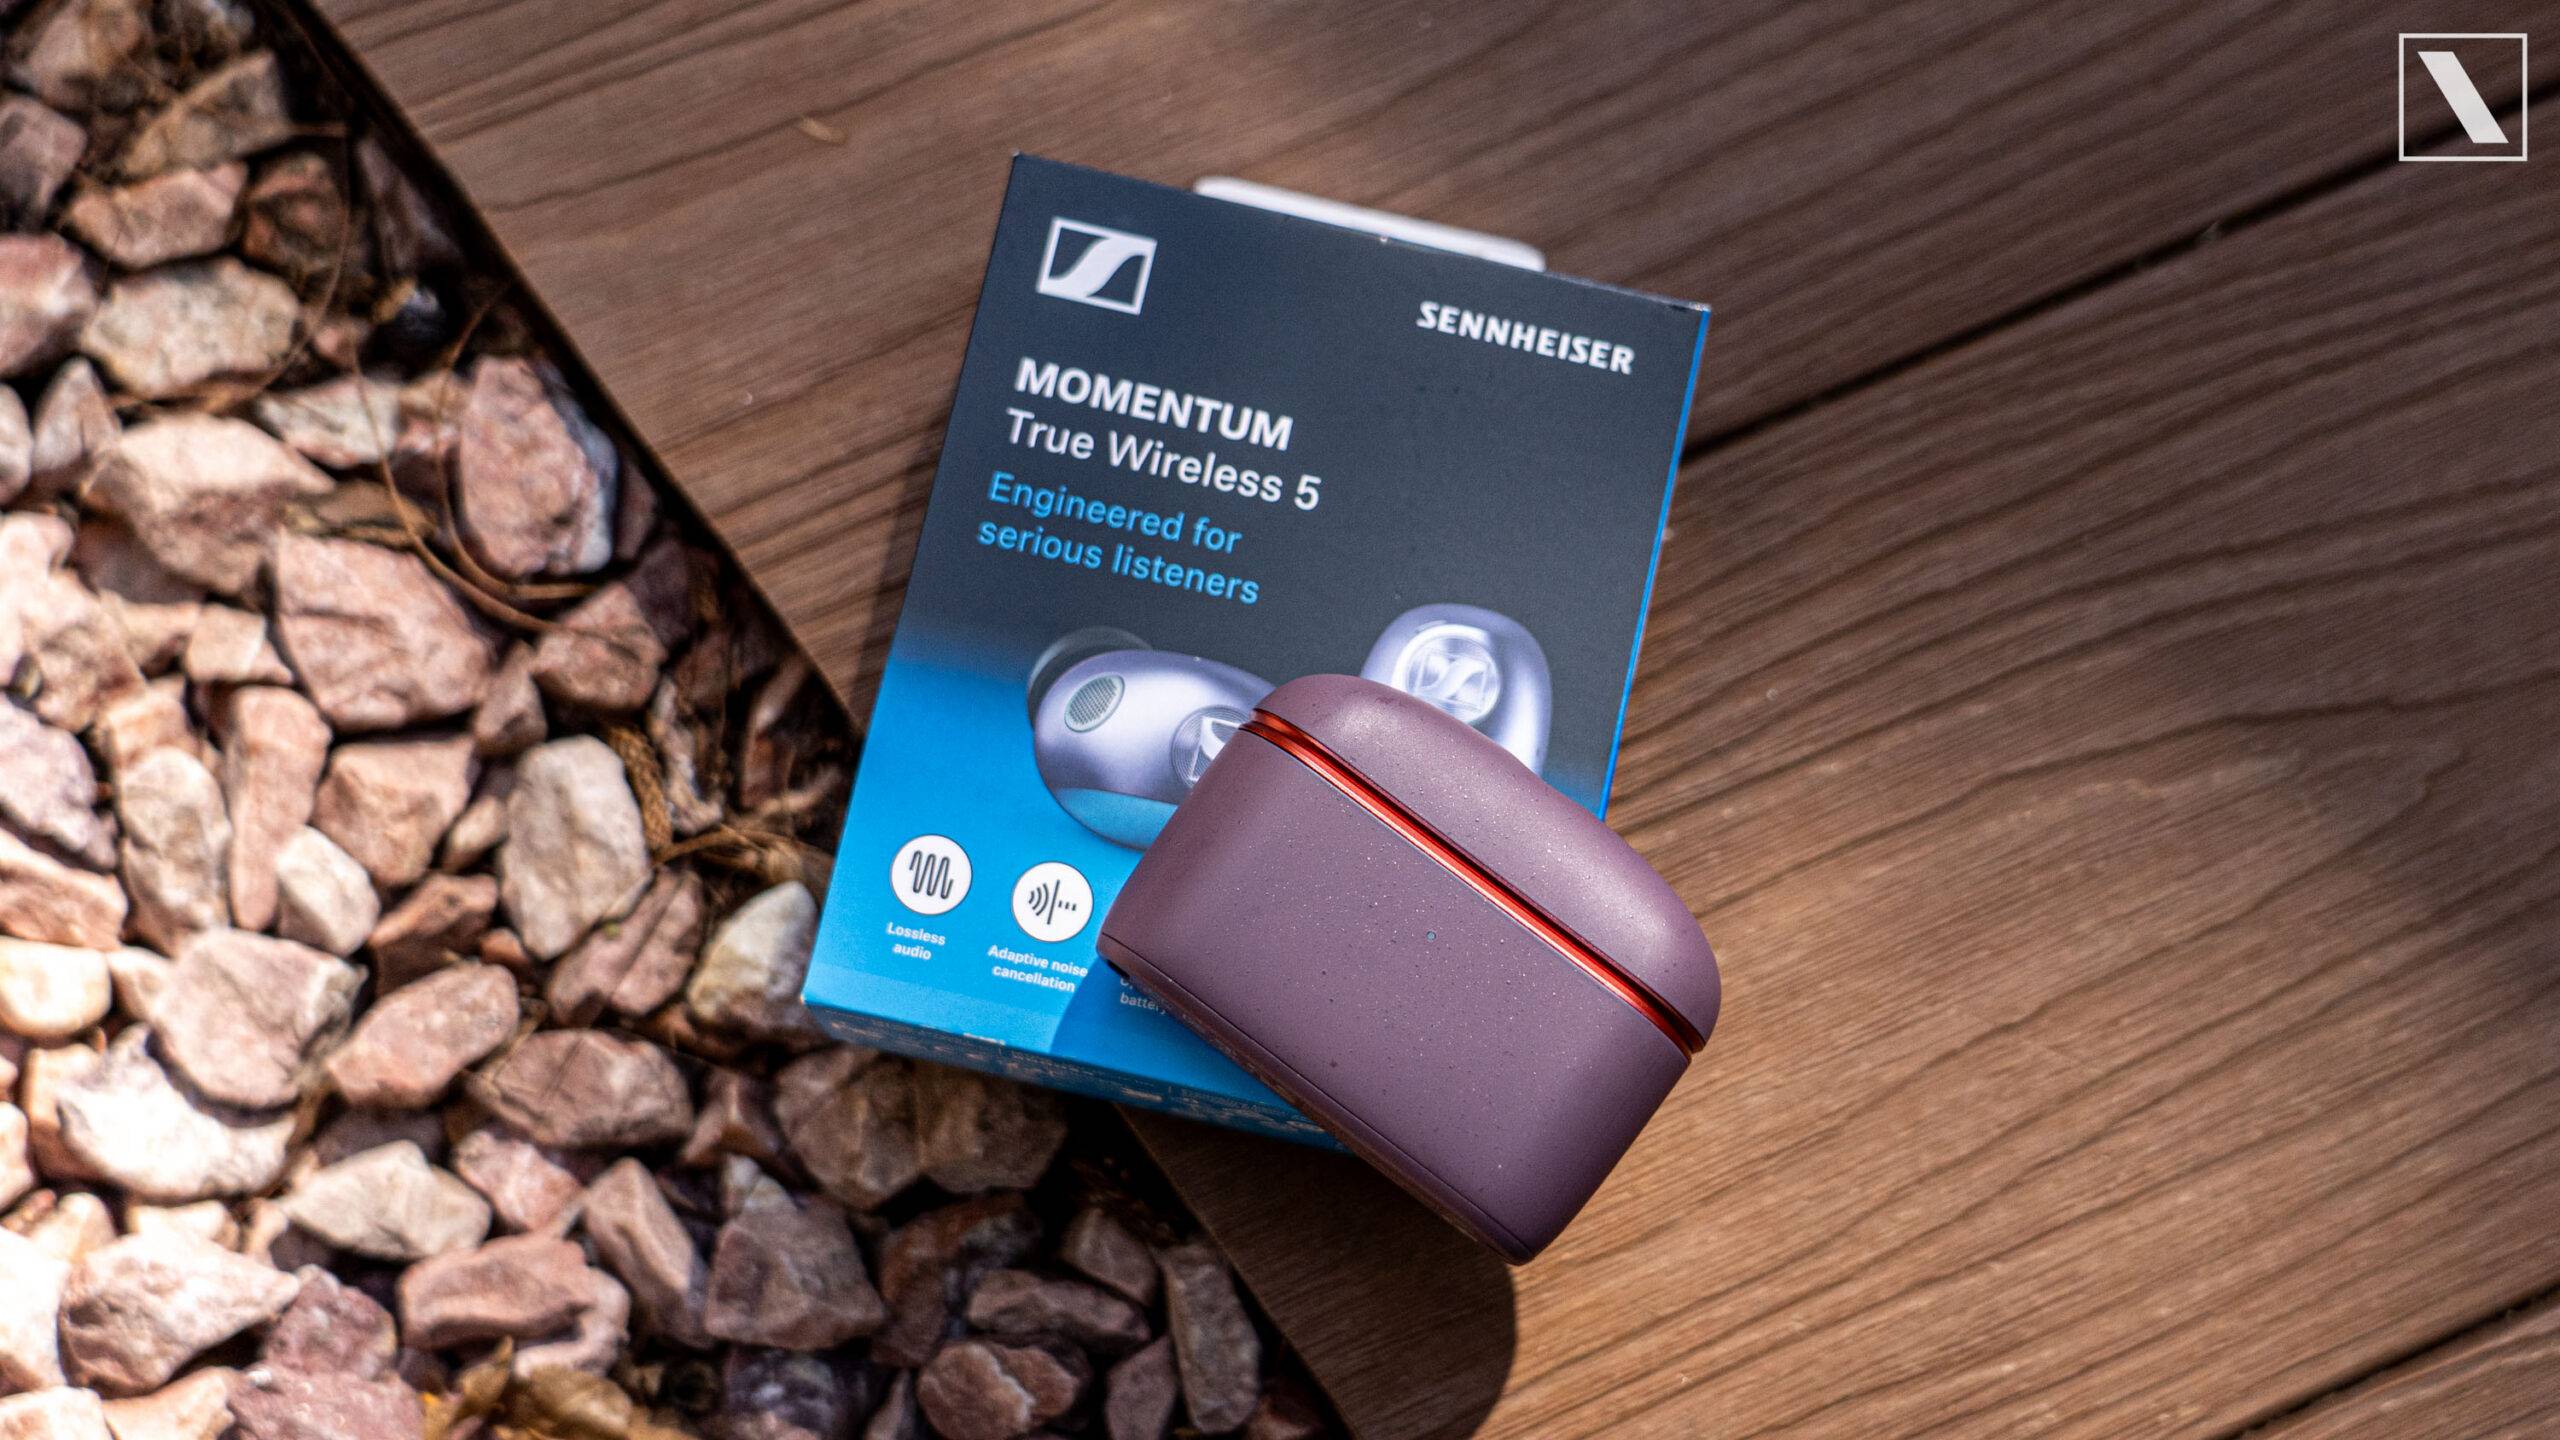
森海塞尔发布第五代MOMENTUM真无线降噪耳机,新增薰衣草配色,支持蓝牙6.0、LE Audio、杜比全景声头部跟踪空间音频及自适应降噪。搭载7mm动圈单元,支持aptX Lossless,音质中正饱满。采用四麦克风加骨传导提升通话。降噪开启续航6小时,配合充电盒达40小时,支持Qi 2.1无线充电。售价2398元。
Audible在法兰克福书展发布全球研究《The Future of Listening》,覆盖11国1.8万名听众。结果显示音频消费持续增长,38%英国听众收听量超去年。音频与阅读互补,59%会读已听有声书的纸质版。音频成为远离屏幕、放松身心的方式,53%借此替代屏幕娱乐。听众对AI配音内容持开放态度,48%英国受访者愿尝试,64%对音频未来感到兴奋。
Sky Media与健力士合作,自10月10日起在Sky Sports英超转播中推出实时字幕和描述性音频解说,每赛季分别覆盖约210场和109场比赛,服务盲人、低视力及听障球迷。该服务经RNIB等测试反馈开发,已在Sky各平台及NOW上线。
Nacon发布全球首款官方授权PS5带屏手柄Revolution 5 Unlimited,售价229.99美元,今年晚些时候发货。手柄配备防漂移TMR摇杆、可换方向键和配重,屏幕可直接调节摇杆灵敏度、重映射按键,并支持混合手机与主机音频。兼容PC和安卓,可通过手机App调节响应曲线、EQ和RGB灯效。
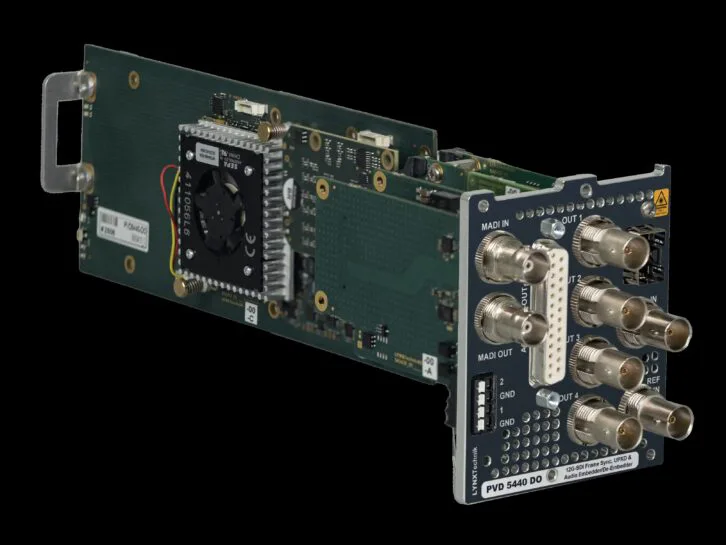
LYNX Technik推出PVD 5000 DO帧同步器与多格式视频处理器,集成帧同步、上下/交叉转换、运动自适应去隔行及音频嵌入解嵌,支持12G-SDI、MADI、AES音频处理,具备136×200交叉开关、最多64路SDI音频、裁剪缩放、测试图案生成、光纤扩展及GPI远程控制,适用于广播制作。
苹果设备端听写依赖神经音频编码器作为分词器,其参数量影响内存、功耗与延迟。研究提出潜空间蒸馏压缩法:以量化前的潜表示为目标,仅训练学生编码器回归教师逐帧潜表示,并用仿射层对齐宽度。2.8倍压缩下,六组师生中五组相对WER仅差1.9%,优于同容量独立训练编码器3.9%。
YouTube年度活动发布多项新功能:观众可定制首页信息流、通过Ask YouTube获取即时推荐、在电视观看Shorts系列;创作者可用AI剪辑助手、改进YouTube Studio反馈、对接品牌合作并扩展肖像检测保护;直播支持实时自动配音和创作者联动;音频方面推出Ask Music和每周播客摘要。
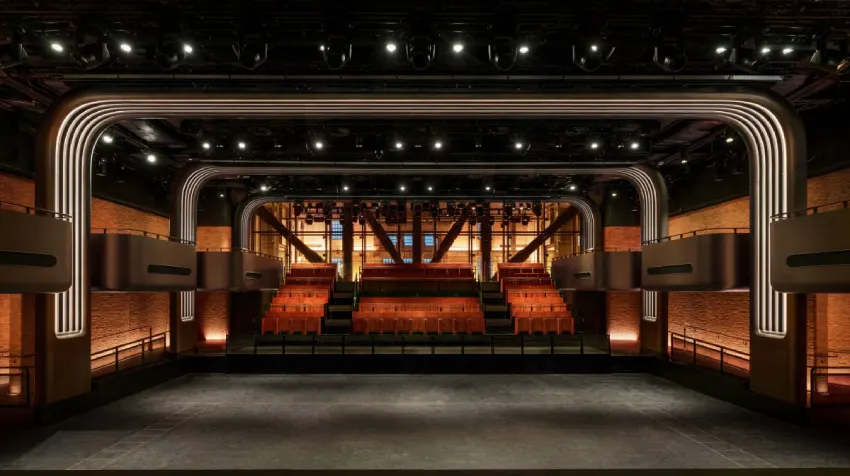
苹果在伦敦巴特西发电站开设Apple Music Hall,9月28日开放,可容纳600人。场馆配备48只空间音频扬声器、两间录音工作室、16台摄像机和专用导播室,能以杜比全景声向Apple TV等设备全球直播演唱会,并录制多机位视频供点播。Apple Music Radio也将迁入该址。
Modular 发布 26.6 版本。Mojo 1.1 开放编译器外部贡献,内部问题迁至 GitHub 公开。MAX 26.6 新增音频生成,支持 MiniMax-Music3 文本生成音乐,并支持 Inkling 等新模型架构及投机解码。性能提升:NVIDIA B200 上 Gemma 4 解码注意力快 4.8 倍,MoE 路由快 7.9 倍;AMD MI355 解码注意力投影快 6.6 倍。modular 包已弃用,改用 max["all"] 等安装。
微软发布紧急带外更新,修复9月更新导致的远程桌面断连、USB音频声道异常及Hyper-V虚拟机共享文件夹失效等问题,影响Windows 10/11和Server多版本。该更新不自动推送,需手动下载安装。
微软9月Windows 11更新KB5124008引发多项故障,已确认USB音频设备无声或无法启动、远程桌面服务异常、虚拟机Plan9共享失效,用户还报告资源管理器崩溃、登录黑屏、文件历史记录无法识别备份磁盘、AMD显卡驱动超时等问题。卸载更新可解决但存在安全隐患,微软正制定修复方案。
亚马逊Prime Video推出新AI功能,利用AI和视觉特效技术,使演员口型与配音音频同步,提升观影体验。该功能目前仅适用于德语剧《Maxton Hall》的英语配音版,未来将扩展至更多作品。此前,Prime Video已在12部影视作品中试验AI辅助配音。
海信在IFA 2026上以“有爱,科技也动情”为主题,展示了显示、激光和音频领域的创新产品,并荣获多项IFA创新奖。其中,条形音箱UX1获得大奖,116UXS MiniLED电视等产品获得荣誉奖。116UXS采用Chromagic 2.0技术,色域达110% BT.2020,峰值亮度10000尼特,并通过护眼认证。此外,海信全球首发场序显示技术,刷新率最高360Hz,同时展示了UX1音箱及轻量耳机。
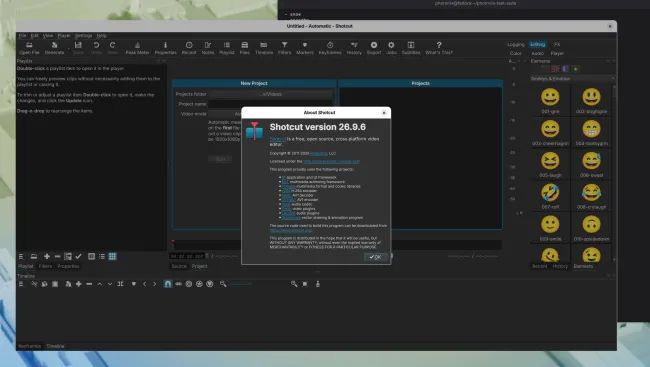
Shotcut 26.9 Beta 发布,提升音频质量(避免16位转换,保持32位浮点),优化时间线性能和现代化UI(圆角设计、新徽标)。采用FFmpeg 9.0,修复Linux下VA-API HEVC硬件编码问题。用户可从GitHub下载Linux、macOS和Windows版本。
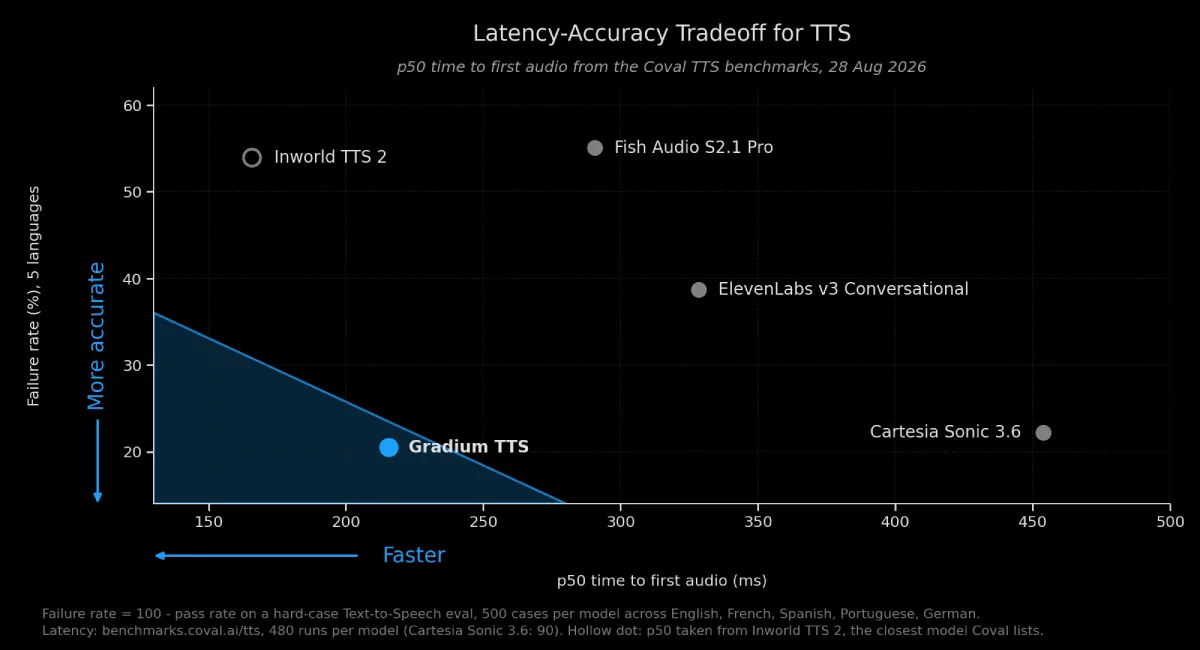
Gradium AI发布新TTS模型并设为默认,在500句难例测试中人工评分通过率81%,领先Cartesia和ElevenLabs。首音频延迟216毫秒,低且稳定。支持多语言,无需文本归一化即可准确朗读号码和邮箱。基准测试由厂商运行,评估集已开源。
完成下面两步后,将自动完成登录并继续当前操作。