GigaBrain-0.7 是具身基础模型,采用三系统架构:系统1基于 VLM 主干与动作专家生成连续动作;系统2负责理解与长程任务规划;系统3用世界模型预测未来视觉状态并评估进展。模型在超 3.7 万小时、16 种机器人形态的轨迹及约 2.7 亿视觉语言样本上单阶段联合预训练,并通过软知识隔离保持视觉语言能力,实现理解、预测、行动与经验改进的统一。
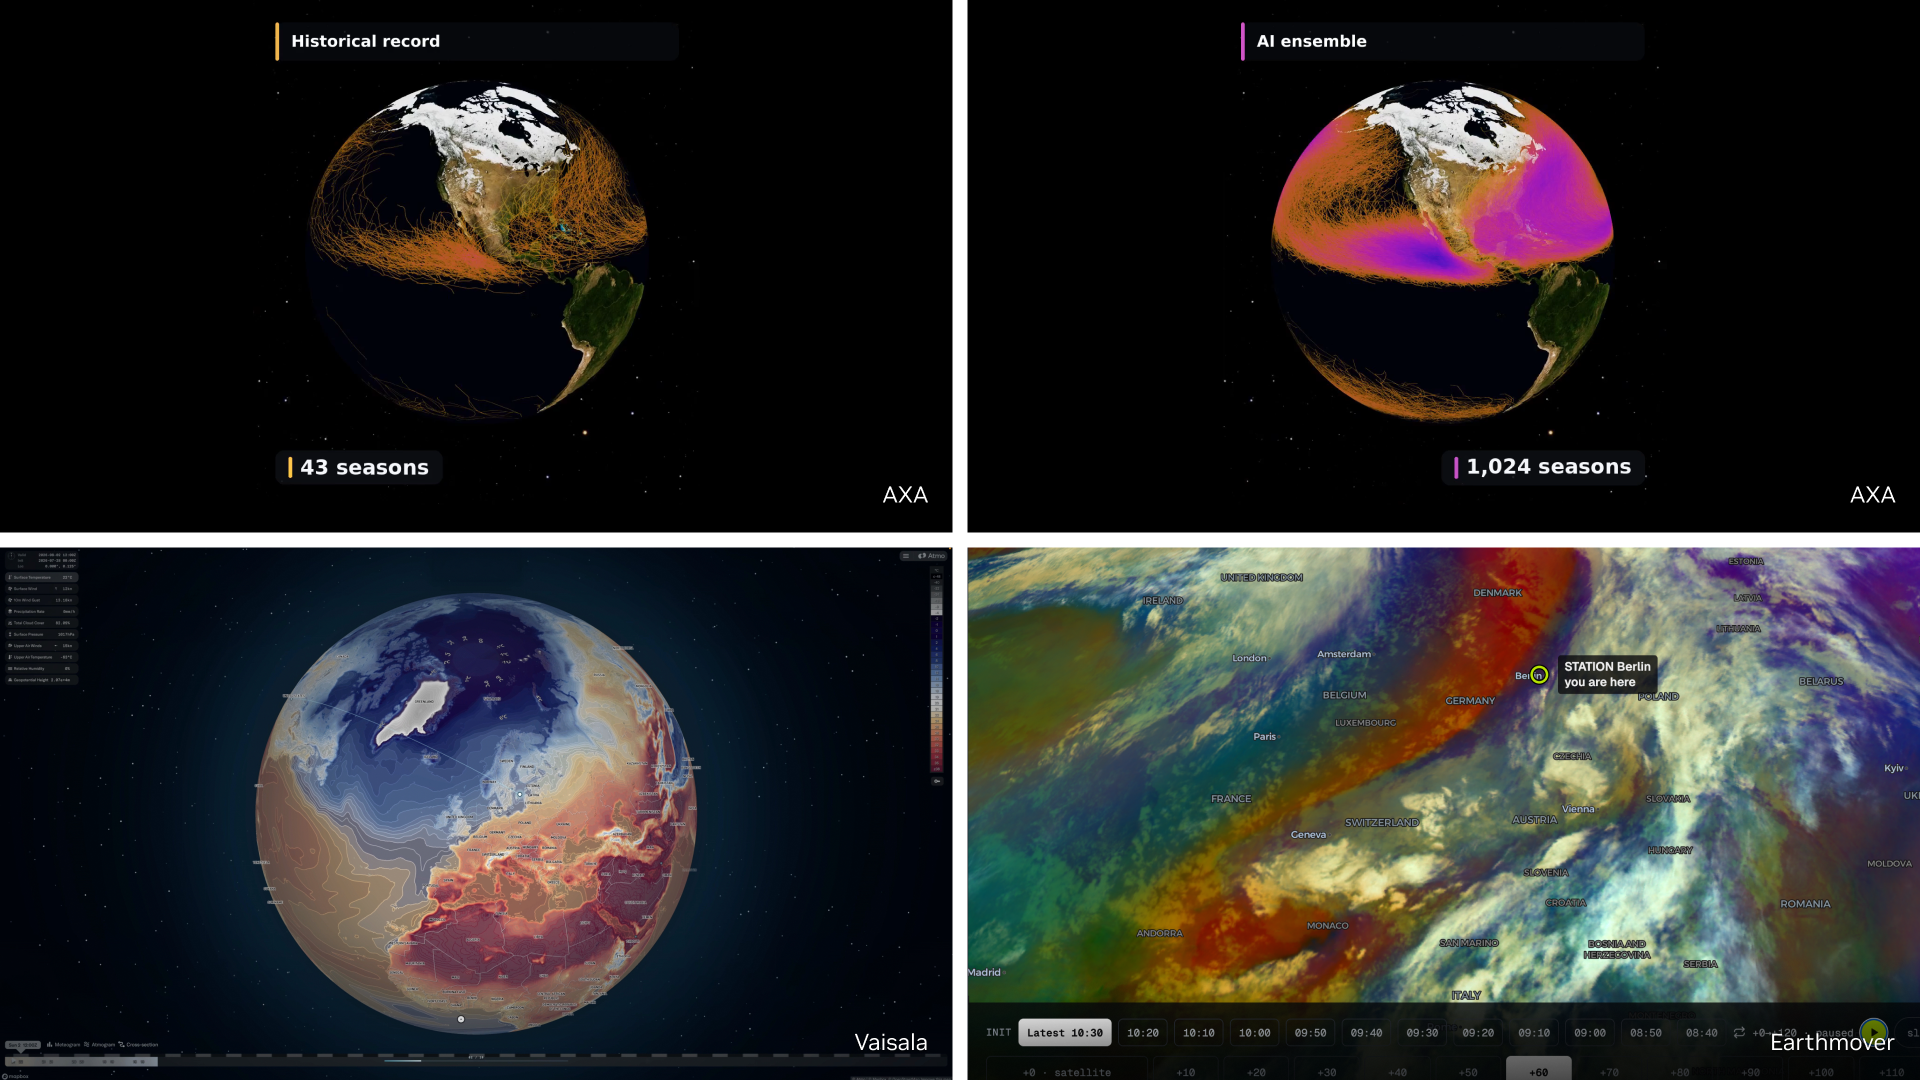
英伟达Earth-2开放模型在欧洲多地落地应用:新模型StormScope EU利用卫星数据每10分钟预测欧洲云况,并在GTC柏林展示实时预报流程;AXA用FourCastNet 3模拟超千个季节评估气旋风险;Vaisala Xweather结合闪电数据提升短临预报;曼彻斯特大学用CorrDiff建模英国空气质量;TotalEnergies探索光伏发电预报;Space42用CorrDiff估算地表高度。
GigaWorld-Policy-0.5是一种以动作为中心的世界动作模型:训练时利用未来视觉动态提供密集监督,推理时仅解码动作、不生成未来视频,从而降低计算开销。它采用混合Transformer架构,将视觉动态建模与动作生成分配给不同专家模块,在RTX 4090上推理时延约85毫秒。预训练结合动作条件世界建模与WAM训练,并用AutoResearch流水线自动搜索训练配置。实验表明,该模型在保留未来视觉监督优势的同时显著提升了推理效率。
Databricks推出Predictive AI Functions测试版,业务用户和分析师无需机器学习专业知识,即可通过SQL原生函数完成预测、异常检测、驱动因素分析和预测建模。新函数包括ai_forecast、ai_top_drivers、ai_detect_anomalies、ai_predict_value和ai_predict_class,可在SQL、Genie和仪表板中调用。模型由Databricks集中维护,无需自建基础设施,基准测试显示其预测准确率领先。
statsmodels 拟合模型除点预测外还提供更多信息:用 get_forecast 可直接获取预测区间,无需手动计算;append 能在不重新拟合的情况下加入新数据并默认复用已有参数;STLForecast 将 STL 分解与 ARIMA 预测整合,避免手动还原季节性时的错误。这些内置方法比手写实现更短、更快、更准确。
美国疾控中心宣布,谷歌AI流感预测模型在2025-26流感季对住院人数预测最准确。该模型基于AI工具ERA,研究已发表于《自然》杂志,技术已向受信任测试者开放。
NVIDIA发布Kumo Tabular表格基础模型,将标注行作为上下文,一次前向即可预测,无需逐任务训练。模型参数28M至215M,官方称四组评测第一、快17倍,但真实分布漂移时准确率会下降。作者认为它更适合冷启动基线,而非直接替代成熟风控模型,上线前须做校准、漂移监控与时间留出门禁。
VLX-Seek是OmAI Lab推出的细粒度视觉语言模型,面向机器人、无人机等边缘具身视觉场景,结合语言理解与区域级视觉感知,支持目标定位、指代理解、区域OCR、描述与计数,并引入目标缺失拒识机制,为具身智能连接环境感知与行动决策提供基础能力。
NVIDIA推出BioNeMo推理运行时,通过内核选择、CUDA Graph和Ray流水线优化蛋白结构预测。在8张H100上,Boltz-2吞吐达每GPU小时5.85万残基,较公开实现提升2.9倍。文章强调科学AI吞吐应以成功结构数和完整流程时间衡量,需关注CPU预处理、写盘和失败率等瓶颈。
本文介绍如何结合Amazon Chronos2零样本时间序列预测与Amazon Bedrock AgentCore多智能体编排,构建端到端库存补货自动化系统。系统由监督、预处理、预测、报告四个LLM智能体协调确定性工具,将需求预测转化为可审计的采购订单。新SKU无需训练模型,仅上传CSV即可,推理成本降低98%,中位WAPE为12.3%。
AlphaGenome Atlas是Google DeepMind推出的AI数据库,免费向学术界开放,预计算了人类基因组中90亿种单核苷酸变异的影响。然而,专家指出其预测精度较前代模型无显著提升,且未经实验验证,不适用于临床。其价值在于简化工作流程,帮助研究人员快速筛选变异和生成假设,而非提供最终答案。
谷歌DeepMind发布AlphaGenome Atlas,预测人类基因组中90亿种单核苷酸变异的影响,提供最全面的分子效应目录。平台含AVI评分,结合AlphaGenome和AlphaMissense模型,便于研究者排序和解释变异。已用于罕见病研究、复杂性状关联及调控基序识别,数据量达1PB,免费供学术使用,旨在加速生物学发现。
Facet-0是一种面向高精度接触操作的机器人基础模型,结合视觉-语言骨干与流匹配动作专家,联合预测动作及未来腕部扭矩,将接触视为可预测结果。基于ManuFacet-1K数据集训练,并通过Action–Wrench Critic评估交互价值,实现策略细化,提升装配可靠性。
大模型不再仅依赖预测下一个词,通过RLVR强化学习,它能自主探索解题路径,从模仿者转变为探索者。预训练如同背诵课文,而RLVR则类似自我解题,借助可验证奖励驱动创新,使模型能够生成超出训练数据的新知识,实现超越简单预测的能力。
微软因用户反馈不喜欢机器生成的建议内容,且文本预测会干扰输入,已默认禁用Word和Outlook的文本预测功能。该功能原用于显示建议文本,现用户可在设置中手动启用。涉及Windows、iOS、Android及Mac多个版本。
本文批判静态用户画像的局限,主张用动态行为特征提升预测模型。核心方法包括:测量行为速度与加速度、评估功能使用深度、计算决策摩擦,并借鉴线下购物心理学映射线上信号。针对稀疏数据,采用零膨胀嵌入和频繁子轨迹挖掘。最后以零售需求预测为例,展示从数据采集到特征工程的实践路线,强调动态特征优于静态快照。
谷歌发布TimesFM-3,一款3.3亿参数的时间序列预测模型,支持多序列并行预测和零样本泛化,性能超越Chronos-2等竞品。模型采用双注意力机制,解码效率提升,但权重仅限非商业使用,商业用途需通过谷歌平台,反映行业商业化趋势。
蚂蚁国际发布自研时序AI预测大模型“鹰序TST”2.0版,在基准测试中取得最优成绩,预测准确率超93%。该模型专为跨境支付外汇风险管理设计,已获巴克莱、花旗等银行应用,并拓展至电商、航空等领域。文章还对比了Chronos-2、TimesFM等模型,强调金融场景需结合领域数据验证,通用榜单优势不等于稳定金融收益。
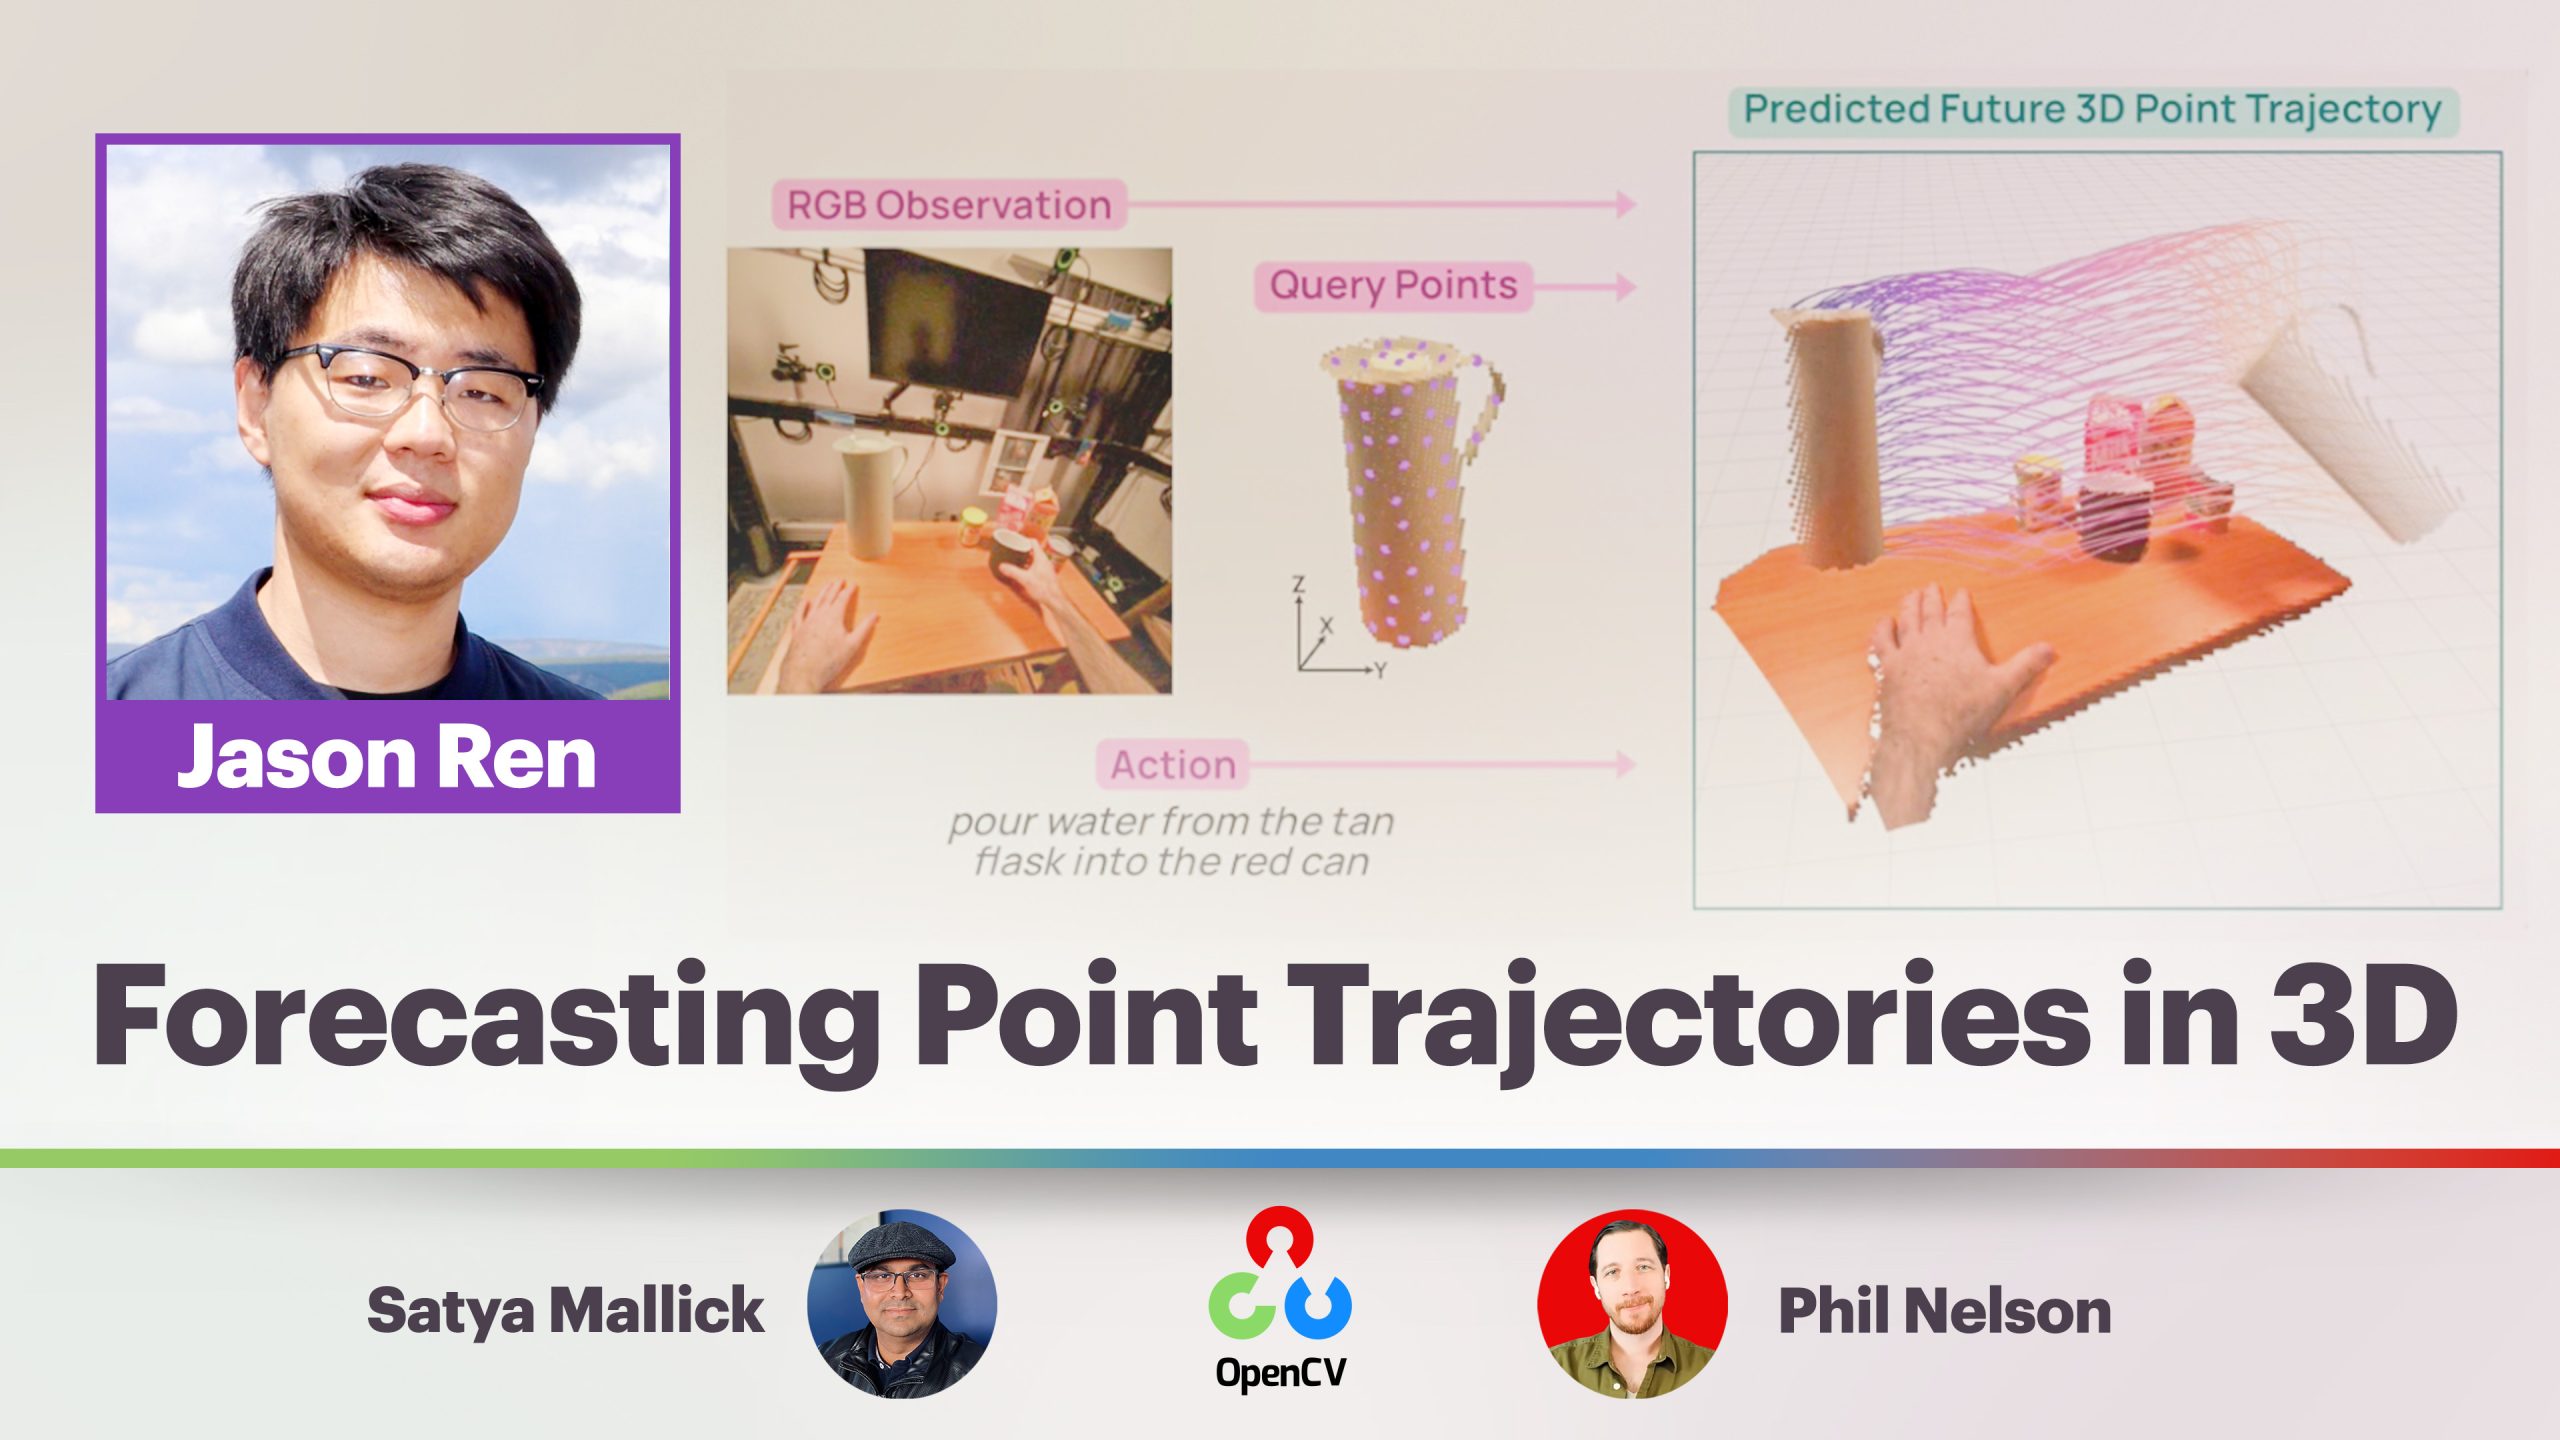
本次直播由Ai2的Jason Ren主讲,介绍MolmoMotion模型。该模型基于Molmo家族,能根据语言指令预测3D空间中的点轨迹,展示运动发生的位置和时间。直播包含演示、训练数据讲解,并探讨其在机器人、视频理解和具身智能领域的应用,最后设有问答环节。
压缩与预测在数学上等价,大语言模型本质是超级压缩器。通过上下文预测下一个符号,概率越高所需比特越少,如字母U在Q后概率飙升,压缩效率大增。LLM训练目标交叉熵损失即最小化比特数,与压缩原理一致。虽压缩能力极强,但因模型庞大、计算成本高,无法替代gzip等实用工具。
完成下面两步后,将自动完成登录并继续当前操作。