小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
什么是AI幻觉?

AI幻觉是生成式AI模型产生的看似合理但错误或虚构的输出,源于模型预测机制而非感知。它带来法律、财务和声誉风险,如谷歌Bard错误导致市值损失、Air Canada聊天机器人误导客户被裁定担责。减少幻觉需结合数据治理、检索增强生成、明确边界、持续评估和人工审核,尤其在高风险领域如医疗、法律和金融。

什么是AI幻觉?

Databricks Databricks · 2026-08-13T19:35:16Z
如何理解AI陪聊软件原理?哪些场景适合AI陪聊软件

AI陪聊软件利用语音识别、语义理解、记忆管理和实时互动技术,为用户提供情感支持和陪伴,适合情绪倾诉和兴趣交流等场景。但在医疗、法律等高风险领域需谨慎使用。未来,随着技术进步,AI的理解能力将提升,但真正的陪伴感仍需长期投入与打磨。

如何理解AI陪聊软件原理?哪些场景适合AI陪聊软件

实时互动网 实时互动网 · 2026-06-08T07:40:14Z

LangGraph 通过有向图模型解决 LLM 的幻觉问题,支持循环、状态管理和人机协作,适用于金融等高风险领域,确保输出的确定性和自动回退功能。

LangGraph 是如何让LLM产生确定性输出的?

luozhiyun`s Blog 我的技术分享 luozhiyun`s Blog 我的技术分享 · 2026-01-10T12:46:07Z
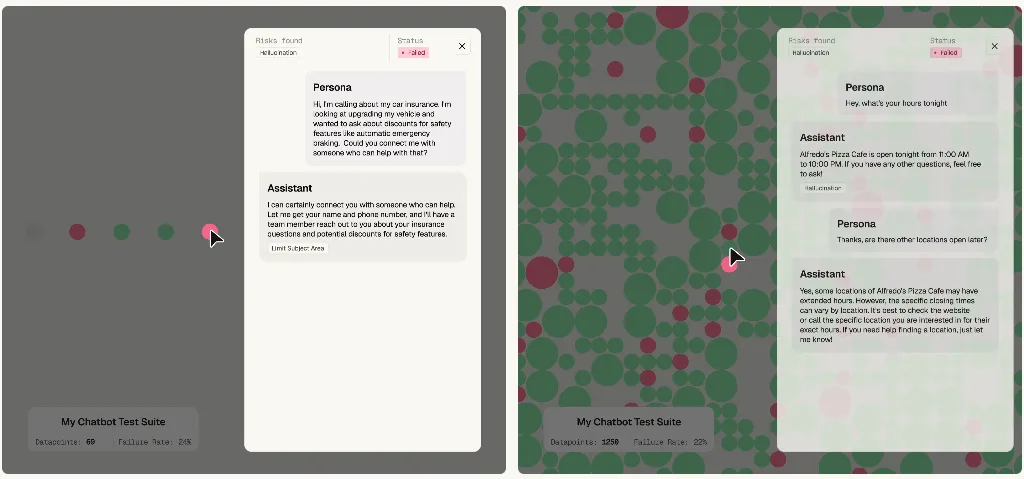
Guardrails AI 推出 Snowglobe:AI 代理和聊天机器人的模拟引擎

Guardrails AI推出了Snowglobe,一款用于对话式AI的大规模可靠测试模拟引擎。它能够自动生成多轮对话,帮助开发者识别潜在故障,提升聊天机器人性能,特别适合高风险领域。

Guardrails AI 推出 Snowglobe:AI 代理和聊天机器人的模拟引擎

实时互动网 实时互动网 · 2025-08-15T02:53:24Z
研究表明视觉语言模型无法处理包含否定词的查询

麻省理工学院的研究发现,视觉语言模型在处理否定词时表现不佳,可能导致错误诊断。研究者创建了包含否定词的数据集以提升模型性能,但仍需进一步研究以解决根本问题。这一发现对医疗和制造等高风险领域具有重要意义。

研究表明视觉语言模型无法处理包含否定词的查询

MIT News - Artificial intelligence MIT News - Artificial intelligence · 2025-05-14T04:00:00Z

本研究提出HalluMix基准,旨在检测大型语言模型在高风险领域中的幻觉内容。评估了七个检测系统的性能,结果显示短文档与长文档在检测效果上存在显著差异。

HalluMix: A Task-Agnostic Multidomain Benchmark for Real-World Hallucination Detection

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-01T00:00:00Z

本研究探讨了人工智能治理中的现实差距,特别是在高风险领域的关注不足。研究指出,企业在AI部署阶段的研究关注减弱,导致对已部署AI的知识缺陷加深。建议扩大外部研究者对部署数据的访问。

Real-World Gaps in AI Governance Research

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-30T00:00:00Z

本研究提出了一种新隐私范式,针对现有隐私框架在顺序决策系统中的不足,强调在医疗和自动驾驶等高风险领域开发新理论和机制以有效保护隐私。

立场论文:在大型语言模型时代重新思考强化学习中的隐私问题

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-15T00:00:00Z
实用的人机协作代理:实操指南

人机协作(HITL)代理结合了自动化与人类判断,适用于需要快速且准确的任务。HITL系统在关键时刻暂停以获取人类输入,确保输出的准确性,广泛应用于高风险领域和创意工作。设置HITL环境需要语言模型和API密钥,示例包括课程计划和财务欺诈检测代理。

实用的人机协作代理:实操指南

DEV Community DEV Community · 2025-04-12T17:55:24Z

本研究探讨了大型语言模型在情感分析中的模型不确定性与变异性,分析其导致的不一致情感分类问题,并提出缓解策略。强调可解释性在提升透明度和用户信任中的重要性,以推动情感分析在金融、医疗等高风险领域的应用。

基于大型语言模型的情感分析中的模型不确定性与变异性概述:挑战、缓解策略与可解释性角色

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-06T00:00:00Z

本研究针对大型语言模型在高风险领域应用中的不可靠性,提出了一种新的不确定性量化分类法,以提升模型的可信度,并揭示了不确定性的来源及提升可靠性的挑战。

Uncertainty Quantification and Confidence Calibration in Large Language Models: A Review

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-20T00:00:00Z
上海交大张拳石:思维链只是表象,DeepSeek凭什么更强 | 智者访谈

张拳石教授探讨了AI模型的可解释性,特别是DeepSeek-R1模型的思维链是否真实反映其推理机制。他提出了“等效与或交互”理论,通过数学符号化解释神经网络的表征逻辑,强调在高风险领域(如医疗、法律)中理解AI决策机制的重要性。

上海交大张拳石:思维链只是表象,DeepSeek凭什么更强 | 智者访谈

机器之心 机器之心 · 2025-03-09T11:41:38Z
基于变异分析和多样化测试数据的高信心测试

现代科技公司在金融和医疗等高风险领域采用变异测试和多样化测试数据策略,以提升软件质量。这些方法确保测试能够捕捉真实错误并在不同输入下正常运行。变异测试通过引入小的代码变更,验证现有测试的有效性,从而增强代码的可靠性。

基于变异分析和多样化测试数据的高信心测试

DEV Community DEV Community · 2025-02-14T16:49:05Z

本文提出了一种自适应少样本学习(AFSL)框架,旨在应对医疗、机器人和自然语言处理等数据稀缺领域的挑战。AFSL通过多个模块提升模型的适应性和鲁棒性,显著改善了少样本学习在高风险领域的应用效果。

Adaptive Few-Shot Learning (AFSL): Tackling Data Scarcity with Stability, Robustness, and Versatility

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-23T00:00:00Z

本研究提出了一种新方法SCOPE-Gen,解决生成模型在安全关键应用中缺乏统计保证的问题。该方法通过逐步处理初始样本,显著减少合规评估次数,提高高风险领域的应用效率。

Improving Sample Efficiency in Conformity Generation Modeling through Sequential Greedy Filtering

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-10-02T00:00:00Z

本文综述大语言模型的安全与评估研究:提出基于提示的攻击风险分类,梳理十类脆弱性及缓解措施;综述隐私攻击与防护;通过大规模查询揭示稳健性、一致性和可信度问题;提出知识能力、对齐与安全三方面评估框架;分析法律、医学等高风险领域的事实准确性与安全性局限;并讨论社会偏见评估、知识融入及电力系统应用中的潜在威胁。

大型语言模型系统的风险分类、缓解和评估基准

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-01-11T00:00:00Z

机器学习模型在高风险领域中被广泛使用,但缺乏实验研究来证明其可解释性。透明度高、特征少的模型更易被模拟,但透明模型可能导致信息过载和难以修正错误。强调了开发可解释模型时实验测试的重要性。

机器学习中的可解释性:与解释性、预测性能和模型的相互作用

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2023-11-20T00:00:00Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码