文章解释专家缓存不适用于稠密模型:MoE每Token仅激活约3B参数,可缓存热点专家;而Qwen3.8-27B每Token需计算全部27B权重,按Token搬运权重受PCIe带宽限制。作者在16GB显存上实现稠密推理引擎,通过显存预算规划、零拷贝放置、12种GGUF量化块原位GEMV、单流子层融合及分块注意力显著降低延迟,但整网端到端吞吐仍待实测。
PrismML发布Ternary Bonsai 2 27B三元量化多模态模型,27.36B参数压缩至5.9GB,保留基座98.2%分数。但权重存于旋转基底,运行时需执行Walsh-Hadamard变换,原版llama.cpp与Ollama无法运行。TensorSharp通过显式校验变换契约、转码自定义格式接入该模型,拒绝静默跑错,代价是内存增加6%至29%,性能略慢于官方基线。
Qwen3.8-27B因快速生成网页走红,每秒近2000 Token,能凭一句Prompt现场生成完整界面。实测中,它五分钟做出数据分析小工具,但生成的12306抢票页面只是逼真空壳,无法联网、支付或真实抢票。它降低了做网页门槛,却仍难接入现实后端,离真正交付产品还有距离。
作者将Qwen 3.8 27B模型调优至极限,对比124与104两组配置的端到端吞吐(均含TTFT),五项中位数全部由124领先,TTFT也明显改善,并称错过算力舱就错过全球最快Qwen 3.8 27B。
用户偏好Qwen 3.8 27B,认为其在明确任务下执行精准稳定,虽不如GPT全能。因Qwen 3.8 Flash Next训练不严谨、长上下文易乱码而弃用。用户采用GPT规划、27B执行的组合,并用Pi Agent配27B修复博客视频问题,效率很高。
文章介绍了一种高效且省钱的工作流:利用线上GPT进行全局规划与设计,再将方案交给离线模型(如Qwen 27B)执行具体任务。离线模型在后台运行,能自主解决环境问题,既保留线上模型能力,又大幅降低订阅成本,节省约90%费用。
优化Qwen 3.8 27B模型时发现,这类重思考的稠密模型适合算力舱(2070T),Prefill速度达3500-4000 TPS,因模型70%-80%时间在思考,Prefill性能关键。Mac Studio虽显存带宽大,但Prefill能力弱,不适合重思考模型,更适合轻思考模型。选硬件需匹配模型推理范式。
文章实测Qwen 3.8 27B模型通过YaRN技术扩展上下文长度,发现实际可从265K扩展至768K,而非宣传的1M,原因是1M时KV Cache需84GB显存,超出128GB机器可用内存约3GB。作者计划进一步测试768K上下文在实际编程中的表现。
该文章介绍通过YaRN技术将Qwen 3.8 27B模型的上下文长度从786K提升至900K,接近1M,可支持99%的大型代码项目,避免因上下文不足导致的性能下降。模型占用120GB显存,在懒猫AI算力舱上运行速度快且稳定。
vLLM部署Qwen 3.8 27B时,默认参数限制了图片和视频输入,导致报错。通过删除`--limit-mm-per-prompt.image 2`和`--limit-mm-per-prompt.video 0`并重启Docker,问题得到解决,模型恢复正常。
懒猫AI算力仓单台运行Qwen 3.8 27B模型,创下性能纪录:prefill速度3754 TPS,长代码解码125 TPS,八会话解码231 TPS,显存占用70GB。该模型为稠密型,专注写代码,单台可跑且不降智,相比Mac Studio,英伟达芯片prefill和并发性能更强,兼容CUDA,价格更优,现推出优惠促销。
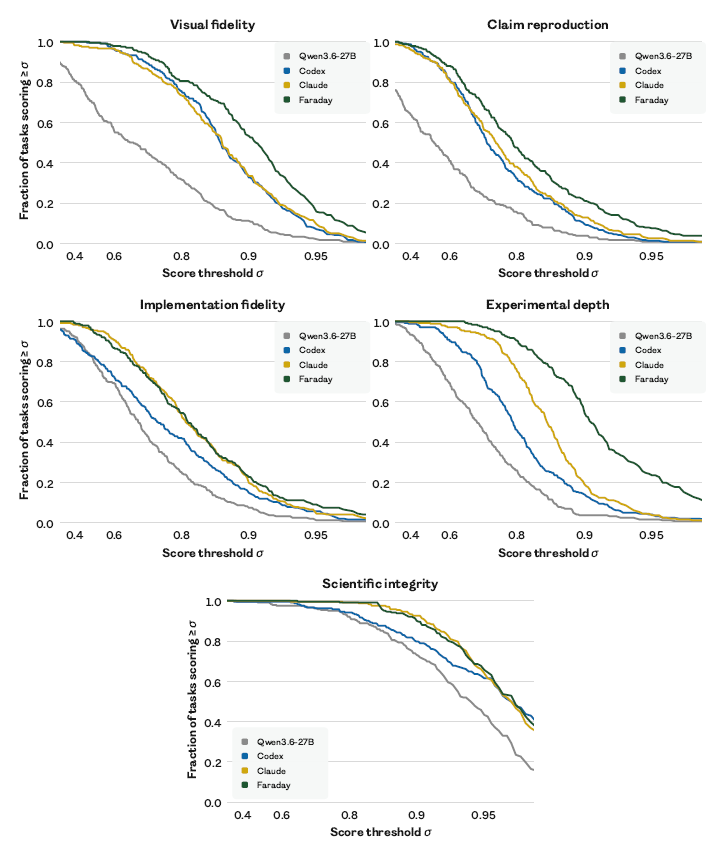
论文复现是科学基石,但机器学习领域面临可复现性危机。Inherent Labs团队训练了270亿参数的AI智能体Faraday,利用Codex GPT-5.5作为工具,在73%的分布内任务和60%的AI for Science任务上超越Claude和GPT-5.5。Faraday通过自动生成任务空间和稳定GRPO后训练,展现出更强的科学严谨性,能指导更大模型工作,提升复现能力。
作者在懒猫AI算力舱X5上部署Qwen 3.8 27B模型,通过真实项目测试,发现其性能良好。经MTP投机解码和NVFP8优化,速度从13.9提升至30.8 Tokens,但关闭思考模式会降低代码推理准确度。开启思考模式后,实际速度稳定在26.47 Tokens,若计入思考阶段,可达35.23 Tokens/s。未来计划进一步优化draft engine以提升速度。
Qwen 3.8 27B在编程任务中表现惊艳,能一次修复多个bug,并仅凭需求描述自主分析代码关系。尽管思考时间较长,但结果出色,优化速度后可作为主力编程模型,全离线AI编程能力强大。
Muse-Glimmer-30B是Meta推出的300亿参数多模态智能体模型,支持本地运行,融合推理、工具调用和多模态理解,性能优异。文章还介绍了HyperAI平台更新的数据集、教程及社区内容,涵盖人物画像、车辆检测、分子处理、语音识别等AI资源。
阿里开源Qwen3.8-27B模型,在编程等任务上超越Claude旗舰,仅需一张二手3090显卡即可运行。其Sharp聊天模板优化了性能,引发对云端订阅价值的质疑。但测试条件存疑,结果可能仅在特定配置下成立,开源与闭源模型竞争仍存变数。
本文介绍如何用三条命令将Qwen3.8-27B模型配置为本地AI编程助手。首先检查硬件(建议24GB显存和32GB内存),然后安装Ollama、下载模型,最后在OpenCode中启动。测试显示模型能快速构建并测试应用,适合初学者快速体验本地AI编程,无需复杂配置。
Qwen3.8-27B开源模型发布,拥有270亿参数,强化推理、编程与Agent能力,在代码、多模态和智能体评测中表现优异,接近顶级闭源模型。支持图像视频理解及灵活思考控制,HyperAI已上线教程供开发者快速调用。
阿里开源Qwen3.8-27B模型,270亿参数,支持262K上下文,性能接近闭源旗舰。社区实测在双RTX 3090上达105 tok/s,通过量化、MTP加速等技术实现。模型Apache 2.0协议,48小时下载86万次。但速度受场景、配置影响大,多卡未必更快,且长上下文需量化KV缓存牺牲质量。
mlx-dspack项目在Mac上通过投机解码技术,将Qwen3.8-27B模型推理速度提升至3倍,8-bit量化下性能优于4-bit。项目基于DeepSeek的DSpark和z-lab的DFlash,支持自动调参优化草稿长度。实测显示8-bit加投机解码比4-bit普通解码快39%,但加速效果受硬件、量化方式和MLX版本影响,长上下文和内存限制仍是瓶颈。
完成下面两步后,将自动完成登录并继续当前操作。