作者发现DJI Assistant 2在macOS 26/27上连接飞机后一直转圈,原因是DJIService崩溃。根源是Qt 5.6误判新系统版本号,未加RTLD_LOCAL,导致四个插件同名weak符号被合并,飞机通道误用基地台版本而空指针崩溃。作者提供脚本修改QtCore两个字节修复,并说明视觉校正需单屏、原生分辨率等条件。
How Greptile uses GPT-6 Astra to test user workflows, Daybreak to strengthen security, and Codex to reduce rework.
据The Information报道,Anthropic新版Claude推理与直觉更强,能识别bug背后的根本问题并跳出思维定势。谷歌正测试Gemini 4系列,代号Carbon在编程和视觉任务上优于Argon,员工称其与Opus 5.5相当。OpenAI的GPT-6.1 Terra已现身微软Copilot代码,或为ChatGPT合并模式后供免费用户使用;OpenAI还称GPT-6.1 Sol在COBOL等冷门语言迁移测试中准确率达97.9%。
Anthropic 正在准备发布他们的全新模型(或多个模型)。消息来源:The Information 据报道,Anthropic 正在准备一款模型,当被要求修复一个 bug 时,它能够识别出背后更广泛的问题类别,并询问是否也应该处理那些问题。这一描述来自一位匿名测试者;模型系列和发布时间仍不清楚。 但看起来,
Cloudflare 的 Hyperdrive 现已正式支持 MySQL。文章介绍其从测试版到正式版修复约 20 个漏洞的过程,重点分析一个罕见缓存 bug:当客户端与端点节点位于同一数据中心并共享缓存时,因 MySQL 能力协商差异导致缓存字节格式不一致,查询会返回空结果或挂起。修复方式是统一以 Hyperdrive 能力编码缓存结果,使连接成功率提升至 99.99%。
工程师 Cindy Sridharan 用 Claude 修复三个生产 Bug 后总结:AI 的根因分析往往条理清晰却结论错误,原因在于人类对 AI 生成代码的理解不足。核心方法是先让 Agent 采集客观事实,再推导假设,把调试转化为约束满足问题——用对照寻找强信号,用全部事实验证假设,矛盾即剔除。读代码应是最后一步。复现与对抗评审只是排除手段,需附证据。人工干预次数是衡量 Agent 原生基础设施成熟度的最诚实指标。
IssueRelay 是一个开源 AI 客服系统,为 React 网站提供反馈组件。访客提交问题后先存入数据库,由 AI 模型 Jev 分类,经人工审核确认后自动创建 GitHub issue,并去除隐私信息。系统基于 Next.js 和 PostgreSQL,支持自托管,约 15 分钟即可部署。
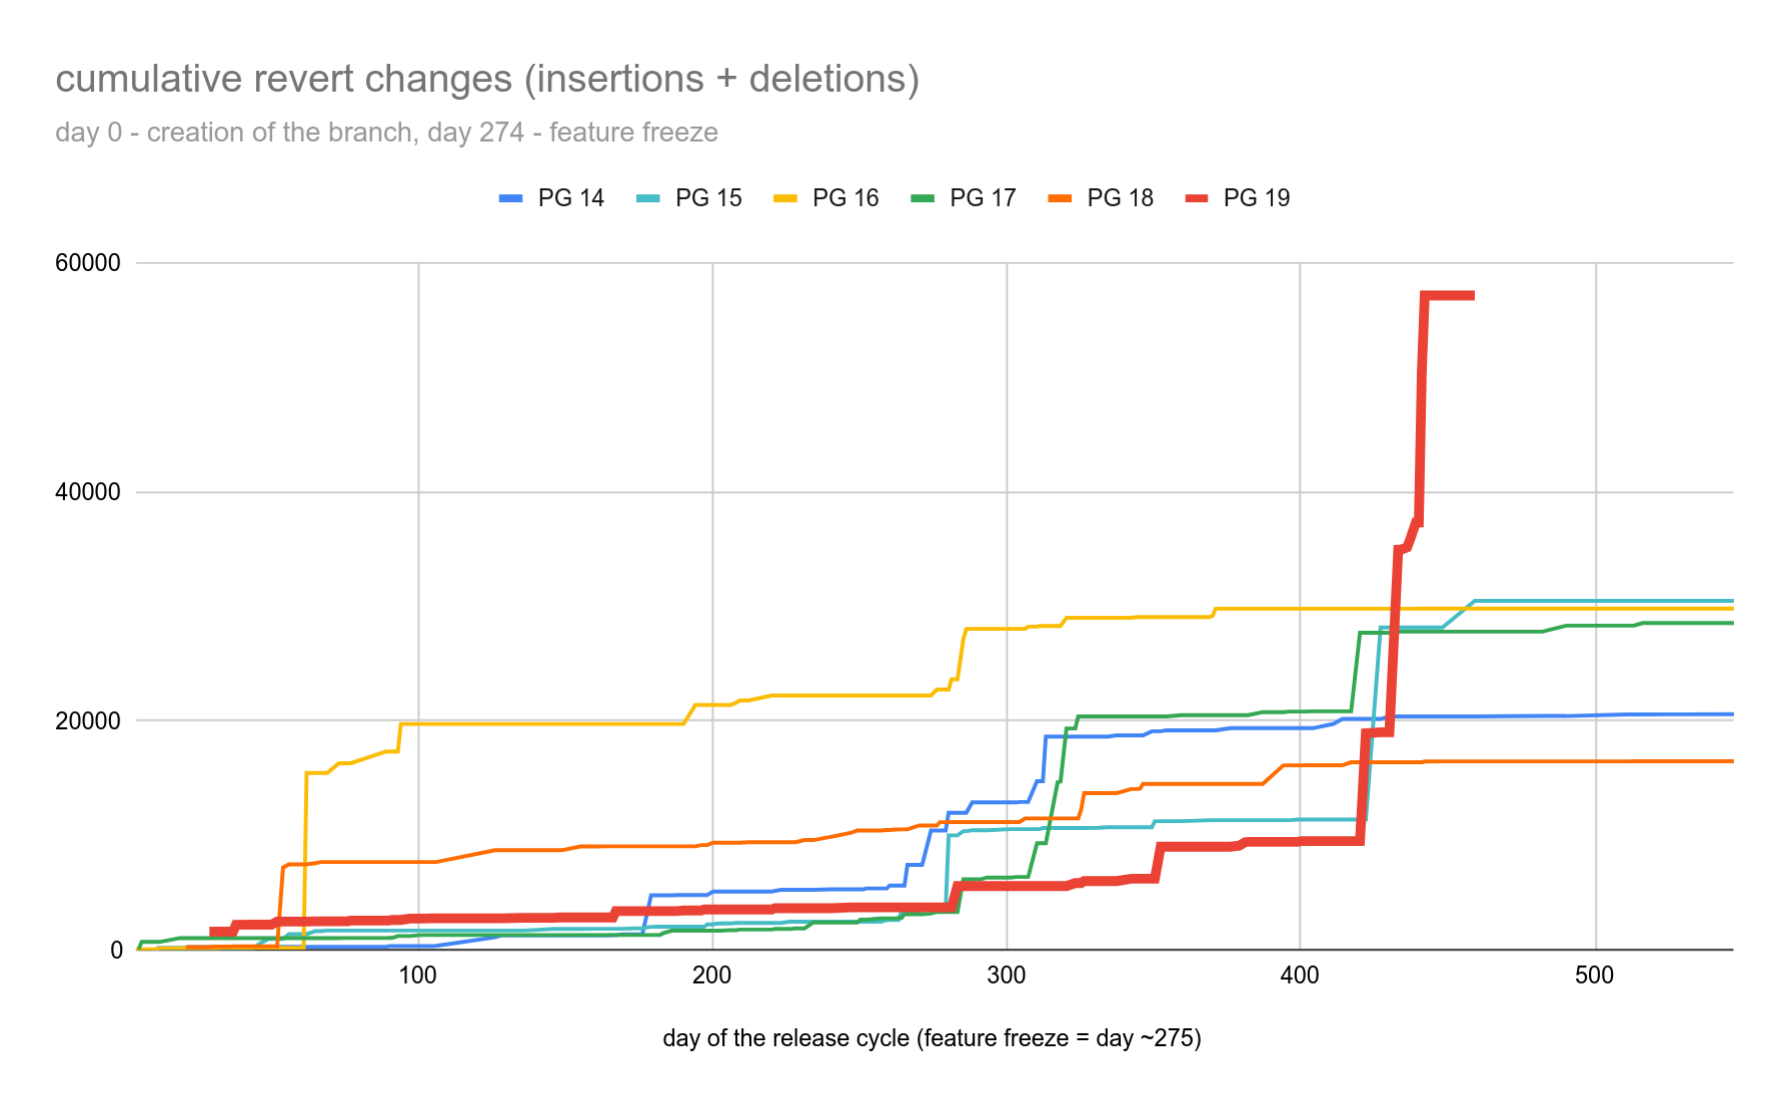
Postgres 19 多项功能被回退,发布推迟约一月。作者核查 12 次回退后认为仅 4 次与 AI 相关,多数源于人工审查。回退数量与往年相当,但时间异常集中在 9 月。真正原因是 AI 带来大量安全报告,资深开发者忙于处理 CVE,导致稳定期审查减少。
IQuest Research推出IQuest-Q1模型,采用稀疏MoE架构,总参数320B、激活15B。实测中,该模型仅凭提示词即可生成反重力赛车、国庆小游戏等HTML游戏,并能排查RL训练中因多余空格导致的奖励曲线异常。模型参与自身研发迭代,在NL2Repo、CyberGym等基准表现不俗。团队此前提出ModularRSI自进化框架,强调AI应把复杂任务做对做完。
讯飞发布293B参数MoE大模型星火X2.5,重点提升代码与智能体能力,支持200余种语言,API限时五折。实测可生成3D粒子交互网页、制作中秋小游戏、解析61页英伟达财报并输出图表与投研简报,还能完成论文实证初稿、排查电商数据bug、搭建游戏官网。模型基于全国产算力训练,训练效率从30%提升至93%,标志AI从问答走向任务交付。
讯飞星火X2.5大模型上线,参数规模达293B,重点强化代码生成与智能体能力。实测显示,该模型能生成3D粒子交互网页、分析财报并制作图表、辅助科研论文初稿,以及搭建游戏官网。模型支持全国产算力,训练效率提升至93%,旨在推动AI从聊天走向实际任务交付。
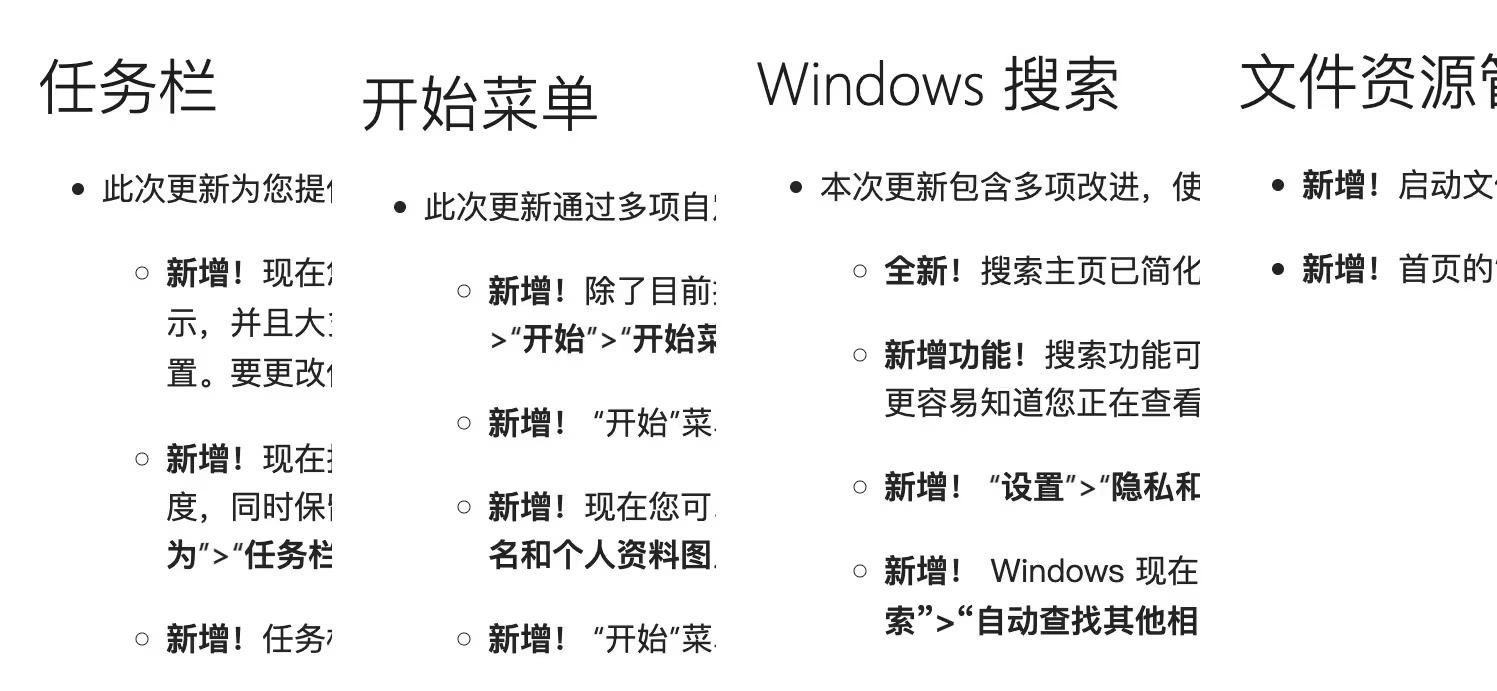
微软发布Windows 11可选更新KB5120998,新增21项功能,包括任务栏位置自定义、开始菜单调整、搜索优化等。但更新存在鼠标指针样式失效、桌面壁纸变黑等bug,部分用户卸载后恢复,建议谨慎更新。
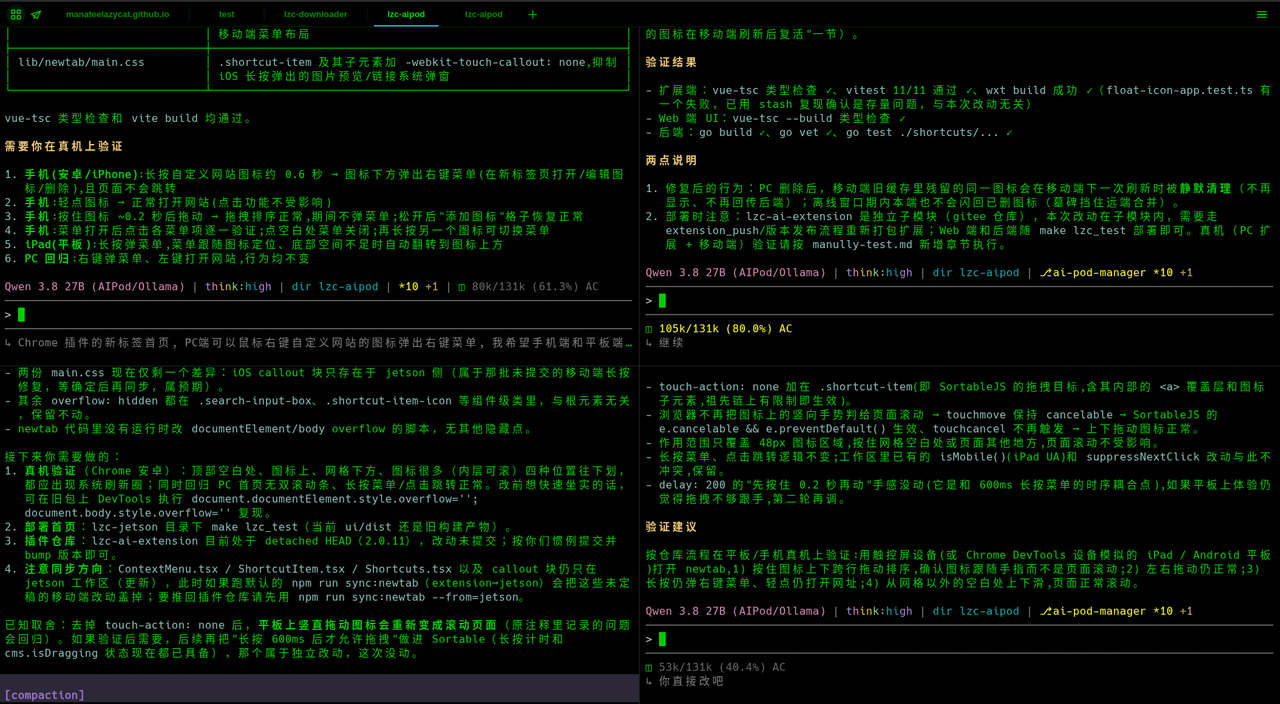
Qwen 3.8 27B在编程任务中表现惊艳,能一次修复多个bug,并仅凭需求描述自主分析代码关系。尽管思考时间较长,但结果出色,优化速度后可作为主力编程模型,全离线AI编程能力强大。
GitHub因美国中部数据中心流量过高引发网络堵塞,叠加内部扩容机制缺陷和重试风暴,导致大规模长时间中断。Copilot因客户端异常重试,请求量暴增10倍,恢复最慢。GitHub将调整扩容和重试策略,并应对爬虫流量压力。
文章探讨AI生成游戏的核心挑战:代码可运行不等于游戏可玩,存在“可玩性黑洞”。Spellcaster通过多Agent协同,将用户描述转化为规则、数值等,形成“生成—运行—检查—修复”循环,支持迭代修改,验证玩法价值。未来转向世界模型,实时预测并生成游戏画面,实现从自动生成到实时推演世界的跨越。
2026年,形式验证因AI辅助而复兴,Lean语言成为热门。文章回顾1979年论文的批评,指出验证虽进步,但规格说明翻译、全自动验证、验证后防御等挑战犹存。AI提升证明效率,但验证者正确性、社会过程等根本问题未解,验证仅是可靠性拼图之一。
智谱发布GLM-5.3开源模型,在编程和安全能力上显著提升,编程接近Claude Fable 5,安全测试获84.5%成最强开源安全模型。实测中能自主完成复杂编程任务、修复漏洞并通过回归测试,强调生产级AI需兼顾代码交付与安全验证。
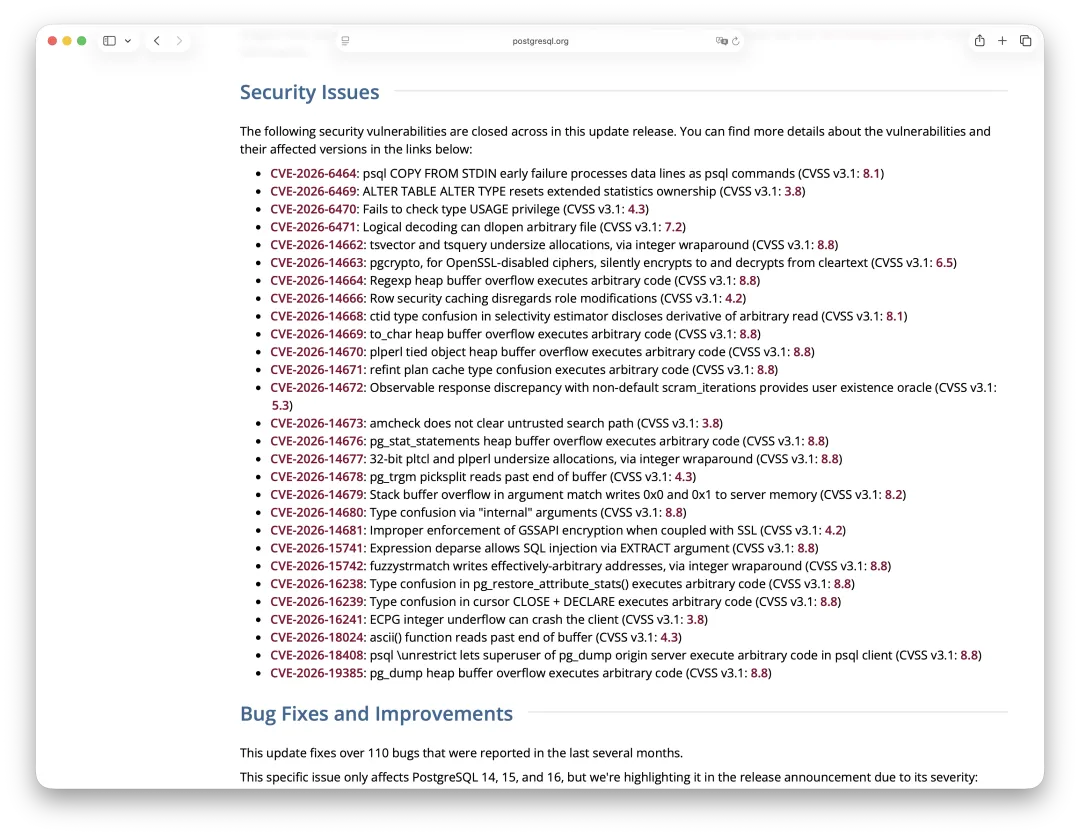
PostgreSQL 发布 18.6、17.11、16.15、15.19、14.24 及 19 Beta 3,修复 28 个安全漏洞和 110 多个 Bug,建议尽快升级。18.5 因回归问题未发布。升级后需检查 GIN 索引表的 reltuples 值,并重建 btree_gist 和 ltree 相关索引。PostgreSQL 14 将于 2026 年 11 月停止支持。
Valkey官方DEB包因沿用Debian补丁,误用zfree释放普通malloc内存,导致SAVE失败时内存统计回绕或崩溃,影响五条版本线。上游源码无此问题,但打包流水线未运行上游测试。作者已提交修复并删除多余补丁,强调打包是最后质量防线,Agent应多做验证而非造新代码。
本文探讨了大语言模型在推理阶段的退化现象,如死循环和乱码等问题。退化源于自回归Transformer的注意力机制和数值精度,导致输出失控。文章分析了退化的数学根源、表现形式及其机制,并提出了多层防御策略,包括架构设计、数值工程和解码策略,以提高模型在生产环境中的稳定性。
完成下面两步后,将自动完成登录并继续当前操作。