
小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
DeepSeek V4.1 Flash吐槽:换不同壳表现差异巨大

DeepSeek V4.1 Flash 跑分超越旗舰,但实际口碑两极分化,原因在于执行框架差异。其 CED 新架构将输入压缩为摘要,提升速度却损失精度;官方框架 DSH 专项优化,换用 OpenCode 等则表现迥异。速度翻倍也推高 token 账单。文章指出,框架与模型同样关键,跑分测不出真实体验。

DeepSeek V4.1 Flash吐槽:换不同壳表现差异巨大

极道 极道 · 2026-09-11T22:08:00Z
什么是智能体框架?Claude Code、DeepSeek Harness 与 Hermes Agent 背后的架构

2026年8月,DeepSeek发布deepseek-harness,两天获9.5万星;Pi用一年靠口碑积累9.1万星。文章将“智能体框架”(harness)定义为包裹大模型的运行时外壳,包含循环、工具路由、记忆、规划与沙箱五部分,取代旧“框架”概念。文章对比Claude Code、Deep Agents、Hermes、Pi等十款工具,归纳插件化、固定机制、累积技能三种设计哲学,并给出60行Python示例与选型建议。

什么是智能体框架?Claude Code、DeepSeek Harness 与 Hermes Agent 背后的架构

freeCodeCamp.org freeCodeCamp.org · 2026-09-11T15:07:18Z

美光将向全球逾六万员工发放史上最高奖金,台湾员工最高获35至68个月薪资。美国司法部调查英伟达是否借Groq交易规避反垄断审查。黄仁勋称网络安全将成AI下一个重大市场。谷歌斥资超150亿美元在芬兰建AI基础设施。DeepSeek下调旗舰模型V4部分服务费,最高降幅60%,并筹备上海IPO。

美光将发放史上最高员工奖金;黄仁勋称网络安全将成为人工智能下一个重大市场;DeepSeek下调旗舰模型“V4”部分服务使用费 | 日报

全球TMT-美通国际 全球TMT-美通国际 · 2026-09-11T04:51:28Z
DeepSeek开源DeepJIT:统一华为昇腾和英伟达CUDA接口

DeepSeek开源C++20库DeepJIT,为英伟达CUDA与华为昇腾NPU提供统一的内核JIT编译、缓存与启动接口,统一的是编译外围流程而非编译器本身。核心亮点是含自定义签名的多级缓存与分布式共享缓存,可减少集群重复编译。相比Triton、CuPy各有取舍,目前缓存预热和Python API尚未完成。

DeepSeek开源DeepJIT:统一华为昇腾和英伟达CUDA接口

极道 极道 · 2026-09-10T10:39:00Z
DeepSeek开源DeepSelect:比torch.topk快二十倍!

DeepSeek 开源高性能 TopK 算子库 DeepSelect,针对稀疏注意力中的闪电索引器和采样器两个场景优化,速度可达 torch.topk 的 2 至 20 倍。该库不绑定推理框架,可通过 pip 直接替换,结果稳定,并支持关闭排序和返回值以进一步提速,助力 V4.1 Flash 推理大幅加速。

DeepSeek开源DeepSelect:比torch.topk快二十倍!

极道 极道 · 2026-09-10T10:36:00Z
DeepSeek V4.1缓存暴降437倍:890字节KV缓存反超Opus 5!

DeepSeek发布V4.1-Flash,采用FP4精度、CSA2层间缓存复用和CED编解码架构,将每token全局KV缓存压缩至890字节,较初代缩小437倍,百万token会话显存从300GB降至1GB以下。模型总参数552B,Prefill仅激活8B。Agent基准超越Opus 5,但纯推理较弱,且V4 Pro突然下线引发开发者不满。

DeepSeek V4.1缓存暴降437倍:890字节KV缓存反超Opus 5!

极道 极道 · 2026-09-10T09:59:00Z
DeepSeek快速、专家、识图模式合并,新模型已发?

DeepSeek将快速、专家、识图三种模式合并为全新智能模式,可自动检测查询复杂度、识别图片并调度能力,无需手动切换。此举或与V4.1 Flash模型发布同步,该模型在性能、速度、费用上全面超越V4 Pro,并将视觉能力升级为原生能力。

DeepSeek快速、专家、识图模式合并,新模型已发?

TechWeb 全站精华 TechWeb 全站精华 · 2026-09-10T02:42:06Z
DeepSeek把Pro流量全部路由到Flash:旗舰被自家更便宜的干掉了

DeepSeek于2026年9月10日发布V4.1 Flash,官方称其在性能、速度和成本上全面超越旗舰V4 Pro,并将所有Pro的API请求强制路由至Flash,按低价计费。Flash生成速度达每秒284 token,约为Pro的三倍,且同步降价。V4 Pro上线仅40天即被放弃,V4.1 Pro仍在开发中,细节未公开。

DeepSeek把Pro流量全部路由到Flash:旗舰被自家更便宜的干掉了

极道 极道 · 2026-09-09T23:08:00Z
DeepSeek 静默切模型这事,问题不只在价格

DeepSeek静默将V4 Pro请求切换至更便宜的V4.1 Flash模型,引发争议。问题在于未经用户同意替换模型,破坏模型名作为契约的稳定性,影响审计和排障。建议供应商应提供开关、暴露实际服务模型,调用方需记录请求与响应模型,确保降级可见可控可回滚。开发者应视模型升级为依赖风险,关注变更通知和回退能力。

DeepSeek 静默切模型这事,问题不只在价格

mongona news mongona news · 2026-09-09T22:38:32Z
DeepSeek V4.1 Flash对决GPT-6 Astra:1%成本拿下98%性能!

DeepSeek V4.1 Flash以GPT-6 Astra 1.4%的成本达到其98%的性能,在OpenDesign评测中得分81.2分,成本仅0.023美元,速度超300 tokens/s。尽管GPT-6 Astra在通用智能上更强,但DeepSeek凭借高性价比和原生多模态架构,在特定领域展现竞争力,引发行业性价比革命。

DeepSeek V4.1 Flash对决GPT-6 Astra:1%成本拿下98%性能!

极道 极道 · 2026-09-09T22:16:00Z
DeepSeek冲刺科创板IPO:557万训练成本撬动750亿估值

DeepSeek计划在科创板IPO,估值约750亿美元,但前7个月营收4.75亿元,净亏损7.15亿元,算力成本高达110亿元。公司靠557万美元训练出顶级模型,创始人梁文锋自掏200亿元融资,腾讯等参投,阿里缺席。IPO旨在留住被挖角的人才,但年内上市时间紧迫,可能推迟至2027年。

DeepSeek冲刺科创板IPO:557万训练成本撬动750亿估值

极道 极道 · 2026-09-09T10:27:00Z
DeepSeek 涨价 24 天后,V4-Flash 模型降价了,V4-Pro 指向 V4.1 Flash 了!

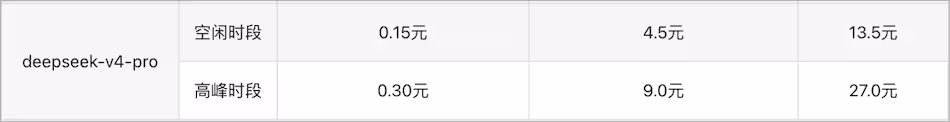
DeepSeek宣布自2026年9月10日起调整flash系列API定价,空闲时段输入缓存命中降至0.02元、未命中降至1元、输出降至4元,高峰时段为两倍。此次降价距8月涨价仅24天,降幅最高达60%,Pro版本价格保持不变。

DeepSeek 涨价 24 天后,V4-Flash 模型降价了,V4-Pro 指向 V4.1 Flash 了!

小众软件 小众软件 · 2026-09-09T07:05:00Z
DeepSeek V4.1 Flash 现已上线 AI Gateway

DeepSeek V4.1 Flash 已上线 AI Gateway,支持原生图像理解,可在同一请求中处理文本和图片,用于解读截图、图表等。模型上下文窗口达100万token,最多输出38.4万token,支持推理、工具调用和提示缓存。新架构分离输入与输出组件,降低各阶段计算量。AI Gateway 提供统一API,无加价和平台费。

DeepSeek V4.1 Flash 现已上线 AI Gateway

Vercel News Vercel News · 2026-09-09T00:00:00Z
DeepSeek V4.1 Flash吊打Vision Exp:少用43%token快38%

DeepSeek发布V4.1 Flash内测版,速度快38%、省43% token,但单价未变,单位时间消耗更多导致“烧钱更快”。该模型限时两天,旨在测试能否以Flash价格提供Pro能力。对比Vision Exp,新模型效率更高,但存在小缺陷。DeepSeek正加速迭代,布局从模型到Agent的完整生态。

DeepSeek V4.1 Flash吊打Vision Exp:少用43%token快38%

极道 极道 · 2026-09-08T22:25:00Z
DeepSeek Flash价格回调至两分钱,V4.1六倍速度剑指Pro

DeepSeek Flash系列API价格回调,缓存命中降至每百万tokens两分钱,输出四元,速度提升六倍。此举旨在应对竞争和信任危机,背后是V4.1新模型成本下降。开发者反应不一,部分因涨价流失,降价难挽回。V4.1内测或取代Pro,成为主力,反映AI商业化中价格与信任的博弈。

DeepSeek Flash价格回调至两分钱,V4.1六倍速度剑指Pro

极道 极道 · 2026-09-08T22:14:00Z
DeepSeek招聘150名工程师,但无人会直接接触模型

DeepSeek大规模招聘约150名后端工程师,以应对AI智能体沙盒并发运行量激增带来的基础设施挑战。其DSec系统通过3FS分布式文件系统共享只读层、减少重复缓存,并利用全局轨迹日志实现中断恢复,避免重跑命令。招聘侧重服务器端工程和Agent弹性计算,而非AI研究,旨在升级维护现有系统以支撑训练与评估负载。

DeepSeek招聘150名工程师,但无人会直接接触模型

The New Stack The New Stack · 2026-09-08T19:01:08Z
DeepSeek、千问、智谱轮番登场,PC 厂商终于等到了它们的弹药

AMD在IFA 2026发布Personal AI战略,推出Ryzen AI Max 400、HP ZBook及Threadripper Halo Station,支持本地运行大模型。强调本地计算、隐私与个人上下文,以降低AI成本。开源模型如GLM、Qwen可本地运行,性能优于云端,推动AI从云端转向个人设备。

DeepSeek、千问、智谱轮番登场,PC 厂商终于等到了它们的弹药

爱范儿 爱范儿 · 2026-09-07T10:40:38Z
DeepSeek乌兰察布一吉瓦算力中心订单全解析

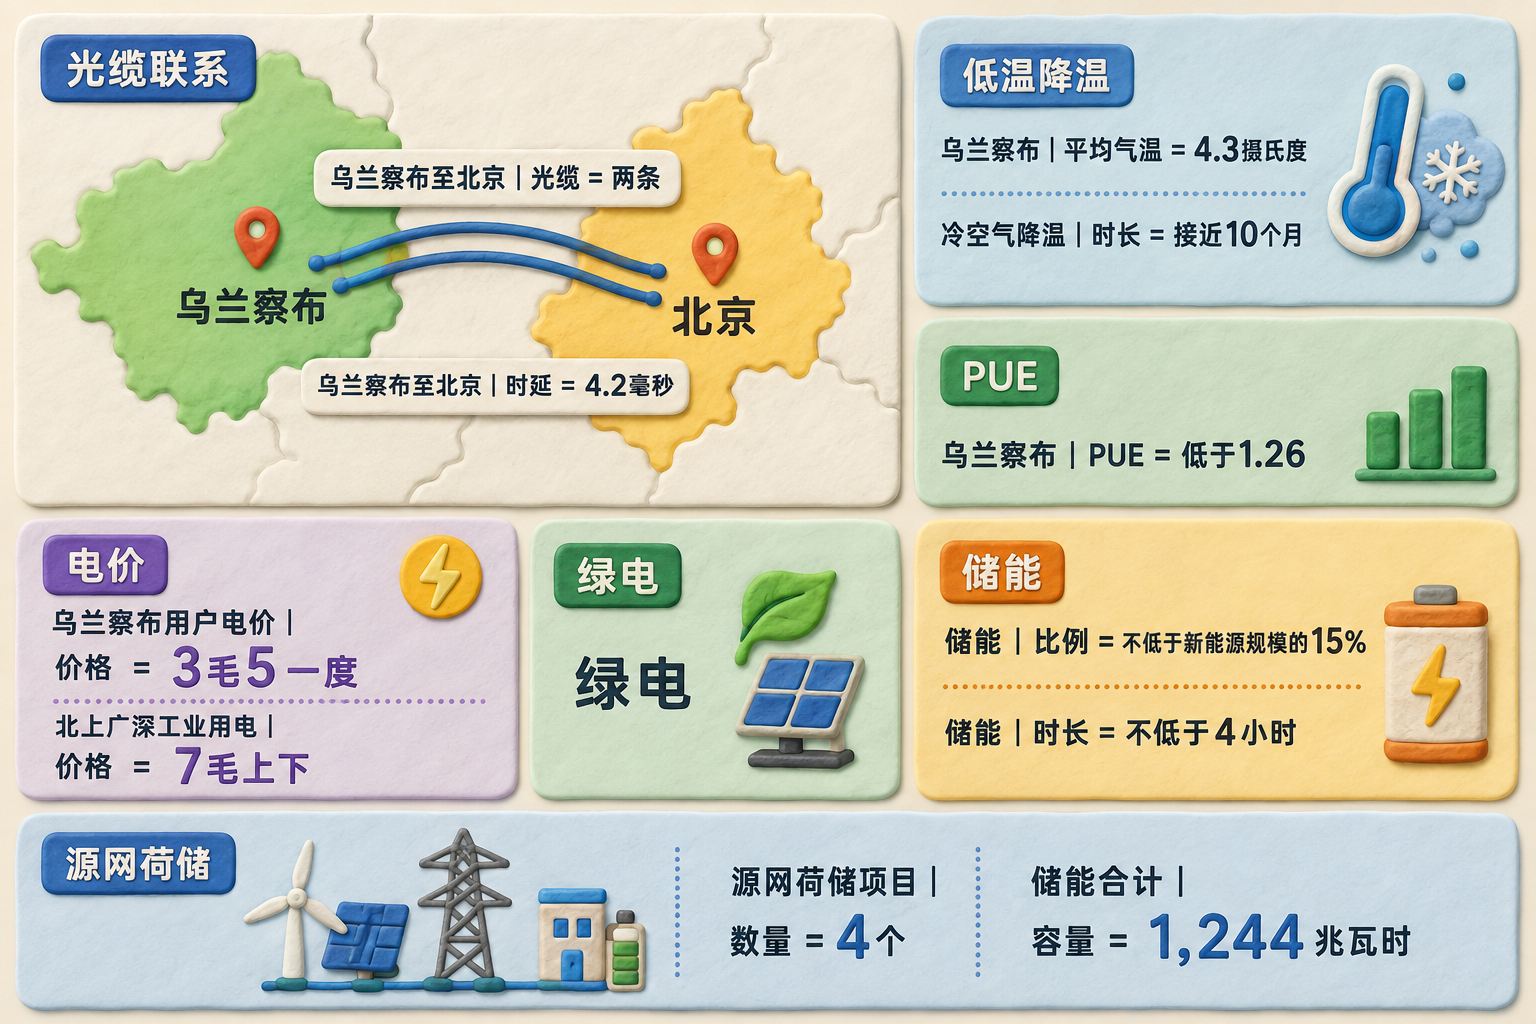
DeepSeek计划在内蒙古乌兰察布建设1吉瓦算力中心,部署16万枚华为昇腾950DT芯片用于推理,总投资约25.6亿美元。此举旨在回应此前梁文锋言论泄露,展示支持国产芯片,并推动融资。乌兰察布因电价低、气候冷、绿电充足而入选。美国因缺地电水受阻,中国则缺高端卡。项目预计2027年底投用,或影响未来AI成本及DeepSeek融资上市。

DeepSeek乌兰察布一吉瓦算力中心订单全解析

硕鼠的博客站 硕鼠的博客站 · 2026-09-07T00:30:00Z
DeepSeek采购160000颗华为AI芯片:专攻推理不碰训练

DeepSeek计划采购16万颗华为昇腾950DT芯片,用于内蒙古乌兰察布数据中心的推理任务,而非训练,订单约25.6亿美元。此举旨在降低成本、规避美国管制,但训练仍依赖英伟达。华为产能和软件生态是主要挑战,交付或需一年以上。

DeepSeek采购160000颗华为AI芯片:专攻推理不碰训练

极道 极道 · 2026-09-05T21:48:00Z
DeepSeek-V4 模型结构(7):结构决定系统

DeepSeek-V4模型采用混合压缩注意力(mHC),将KV缓存分为状态缓存和分页缓存,分别管理滑窗KV与压缩条目。上下文并行通过点对点通信和all-gather处理跨rank压缩窗口。磁盘前缀缓存中,压缩条目易存,滑窗KV需重算或周期检查点。mHC通过融合内核、重算和DualPipe优化,将访存开销压至6.7%。

DeepSeek-V4 模型结构(7):结构决定系统

Java不加糖's Blog Java不加糖's Blog · 2026-09-05T20:20:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码