小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
从后训练到生产:TinyFish如何在Databricks AI Runtime上运行其网络原生模型

TinyFish在Databricks上构建了专用网络原生模型的训练、评估与部署流程,用于企业级网页智能体。模型采用监督微调并转向DPO,通过AI Runtime使用GPU,MLflow评估完整任务成功率,Model Serving负责生产部署。内部基准显示2178项任务成功1691项,成功率77.6%;15天内运行29万余次,单次成本约0.088美元。

从后训练到生产:TinyFish如何在Databricks AI Runtime上运行其网络原生模型

Databricks Databricks · 2026-10-09T16:32:01Z

本文介绍RLHF及其变体DPO、GRPO,旨在解决SFT无法表达相对偏好的问题。SFT仅最大化单一参考答案似然,无法区分多个合理回答的优劣。RLHF通过奖励模型和KL约束优化策略,但存在奖励过优化、对齐税等风险。DPO省去显式奖励模型和在线采样,GRPO在可验证奖励场景下省去critic。三者各有适用场景,对齐税是工程问题也是结构性风险。

【Transformer 与注意力机制】33|RLHF:从 PPO 到 DPO,再到 GRPO

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-08-08T00:00:00Z
大型语言模型如何学习提供帮助(RLHF与DPO)

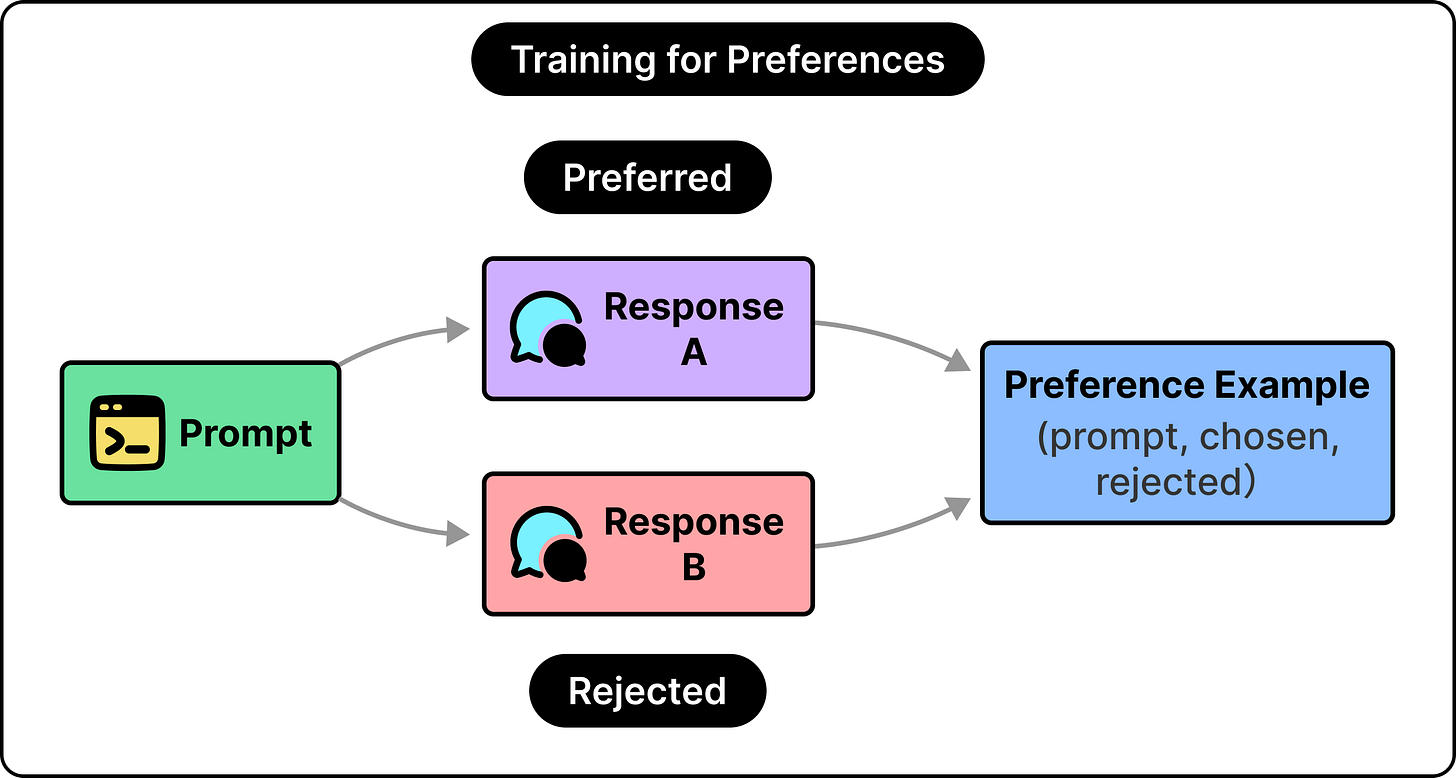
本文探讨了大型语言模型(LLMs)如何通过人类反馈学习,比较了强化学习(RLHF)和直接偏好优化(DPO)两种方法。模型首先通过预训练学习语言和知识,然后通过监督微调学习遵循指令,最后通过比较学习偏好。RLHF通过训练奖励模型并优化,而DPO则简化为单一步骤。两者都依赖于人类判断的信号,但可能导致模型产生迎合性回答。对于可验证的任务,使用可验证奖励可以避免这些问题。

大型语言模型如何学习提供帮助(RLHF与DPO)

ByteByteGo Newsletter ByteByteGo Newsletter · 2026-07-14T15:30:53Z

DPO通过数学推导,从KL正则的RLHF目标中反解出隐式奖励,无需显式奖励模型和在线采样,直接用离线偏好数据训练语言模型。其损失函数基于Bradley-Terry模型,通过推高胜者、压低败者的log-ratio来优化策略。DPO工程复杂度低,但受限于离线数据,存在分布漂移和长度偏置风险,β参数控制KL正则强度。

【强化学习与大模型后训练】10|DPO:把 RLHF 变成一个分类损失

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-05-29T00:00:00Z

后训练是调整预训练模型以实现特定目标的方法,包括预训练、监督微调、奖励建模、策略优化和评测。风格对齐关注表达方式,能力激发关注任务成功率。RLHF通过人类偏好优化助手行为,DPO简化为离线分类损失,RLVR通过可验证奖励提升推理能力。

【强化学习与大模型后训练】01|系列总览:从 RL 到 LLM 后训练的地图

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-05-29T00:00:00Z

本文介绍经典PPO-RLHF训练流程:以SFT模型为初始策略,通过奖励模型打分、参考模型计算KL惩罚、价值模型估计优势,用PPO更新策略。强调KL约束防止奖励黑客,需动态调整系数,并指出该路线成本高,后被DPO、GRPO等方法部分替代。

【强化学习与大模型后训练】09|RLHF 全链路:用 PPO 对齐语言模型

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-05-29T00:00:00Z

大模型训练应视为流水线,分为数据工程、预训练、中训、微调和对齐等阶段。每个环节有不同的算力需求和挑战,数据质量至关重要。预训练需处理大量干净数据以确保模型稳定性,中训通过调整数据配比提升能力,微调教会模型理解指令,对齐阶段则使用多种算法优化模型表现。整体训练过程复杂,需关注数据、算力和工程细节。

【大模型基础设施工程】05:训练全景:Pre-train、SFT、RLHF、DPO、蒸馏

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-04-22T00:00:00Z
Tektronix发布7 Series DPO示波器,创业界最低噪与最高ENOB纪录

Tektronix推出7系列DPO示波器,具备25GHz带宽、低噪声和高ENOB,采用新型ASIC提升数据处理速度,支持高速通信和人工智能研究。首款DPO714AX已开放订购。

Tektronix发布7 Series DPO示波器,创业界最低噪与最高ENOB纪录

全球TMT-美通国际 全球TMT-美通国际 · 2025-09-17T04:22:49Z

机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。

DPO与GRPO谁更胜一筹?港中文、北大等联合发布首个系统性对比研究

机器之心 机器之心 · 2025-06-19T12:12:10Z
LLMs与传统计算机技术的区别

传统计算机技术具有确定性,而当前的LLMs在解决问题时有时不够准确。基于强化学习的方法如DPO和GRPO通过挖掘特定logits来提升LLMs的质量,尤其是在数学和编程领域。创建足够的测试用例并设置自动测试流程至关重要。

LLMs与传统计算机技术的区别

informal informal · 2025-05-24T16:00:00Z

传统计算机处理确定性问题,LLM则应对不确定问题,但可能出错。相比SFT,DPO、GRPO等基于RL的方法利用特定logits提升LLM解决不确定问题的质量。关键是从真实世界数据及LLM生成的数学、编程数据中挖掘logits。数学答案易验证,编程可通过测试用例自动验证,因此RL方法在这两领域效果显著。

LLM与传统计算机技术的区别

informal informal · 2025-05-24T16:00:00Z

本研究分析了噪声标签对离线对齐的影响,探讨了隐私与抗对抗破坏之间的互动,发现局部差分隐私在遭受破坏时面临更大挑战,推动了相关理论的发展。

Unified Theoretical Analysis of Privacy and Robustness in Offline Alignment: From RLHF to DPO

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-21T00:00:00Z

本研究提出了一种新的训练范式Pre-DPO,旨在提高直接偏好优化(DPO)的数据利用效率。通过使用指导参考模型,Pre-DPO显著提升了DPO和简单偏好优化(SimPO)的性能,无需外部模型或额外数据。

Pre-DPO:通过指导参考模型提高直接偏好优化中的数据利用率

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-22T00:00:00Z
TIS-DPO:用于直接偏好优化的令牌级重要性采样

本文提出了一种名为TIS-DPO的令牌级重要性采样方法,用于直接偏好优化(DPO),旨在提高大语言模型的优化效率。TIS-DPO通过为每个令牌分配基于奖励的重要性权重,优化了数据集的使用。实验结果表明,TIS-DPO在无害性和有用性对齐及摘要任务上显著优于基线方法。

TIS-DPO:用于直接偏好优化的令牌级重要性采样

Apple Machine Learning Research Apple Machine Learning Research · 2025-04-15T00:00:00Z

本文探讨了偏好数据在扩散模型训练过程中的关键作用,特别是在Diffusion-DPO及其后续适应中,针对少数样本对模型表现的负面影响,提出了一种新颖的自适应DPO方法。该方法通过引入一种少数样本意识的指标,优化了DPO损失函数,既提高了模型对多数标签的学习能力,又减轻了少数样本的负面影响,为图像生成任务的发展提供了新的训练思路。

当偏好发生分歧:对少数群体意识的自适应DPO进行对齐

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-21T00:00:00Z

本研究提出了InCo-DPO方法,解决了直接偏好优化中的离线数据质量和分布偏移问题。通过整合在线与离线数据,动态调整二者的平衡,实验结果表明该方法在多个基准测试中显著提升了模型性能。

InCo-DPO: Balancing Distribution Shift and Data Quality for Enhanced Preference Optimization

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-20T00:00:00Z

本研究提出了一种平衡DPO方法,旨在解决文本到图像扩散模型在对齐多样化偏好方面的挑战。该方法通过对齐人类偏好、CLIP评分和美学质量等指标,显著提升了主要指标的表现,平均胜率分别提高了15%、7.1%和10.3%。

平衡DPO:自适应多指标对齐

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-16T00:00:00Z

本研究解决了复合人工智能系统中组件对齐的问题,这些系统包含多个相互作用的部分如大型语言模型代理和外部工具。我们提出了一种新的系统级首选优化方法(SysDPO),通过将复合AI系统建模为有向无环图(DAG),有效应对传统方法的局限性。研究表明,该方法在对齐大型语言模型和扩散模型方面取得了显著效果,为复合人工智能系统的进一步发展奠定了基础。

通过系统级DPO对复合人工智能系统进行对齐

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-24T00:00:00Z

本研究针对现有直接偏好优化方法在长链数学推理中的不足,提出了一种新颖的全步长DPO框架,能够利用整个推理链中的逐步奖励进行优化。通过训练自监督过程奖励模型,自动为每一步评分并避免对外部信号的依赖,研究结果显示全步长DPO在数学推理基准测试中表现优于现有的最佳方法,显著提升了语言模型的推理能力。

全步长DPO:带有逐步奖励的自监督偏好优化用于数学推理

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-20T00:00:00Z

本研究针对文本到图像(T2I)系统中的对齐精度问题,提出了YinYangAlign这一先进的评估框架。该框架旨在量化T2I系统的对齐忠诚度,解决了六个基本且内在矛盾的设计目标,促进了对用户意图和创意修改之间的平衡,提高了生成图像的可靠性与一致性。

阴阳对齐:评估矛盾目标并提出基于多目标优化的文本到图像对齐的DPO方法

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-05T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码