Fairwinds 将 n8n 从社区 Helm chart 迁移到官方 chart。n8n 生产环境需要队列模式、PostgreSQL、Redis、S3 和密钥管理。官方 chart 将主节点改为 Deployment 并依赖共享 PVC,与原有 StatefulSet 不兼容,因此采用整体切换。由于状态都存储在数据库、Redis、S3 和 Secrets Manager 中,他们禁用了主节点持久化,保留数据与密钥,先测试回滚再迁移。
StackGres 团队使用开源 Citus 在 EKS 上进行基准测试,在单行主键读、无写入场景下,以 24 个 worker 和 48 个查询路由器实现 1000 万 TPS,p50 延迟约 1 毫秒。相比 PlanetScale 的 Neki,Citus 以不到一半的数据节点和约 65% 的 vCPU 达到同等吞吐,成本约为其五分之一。团队将公开复现代码。
AWS RTB Fabric 为 RTB 广告提供低延迟私有网络,成本最高降低约80%。本文聚焦外部到内部场景:DSP 让外部 SSP 通过现有域名,将竞价流量经外部响应方网关、入站外部链路、路由规则与流量模块,投递到 VPC 内的 ASG 或 EKS 竞价服务器。迁移基于 DNS 灰度切换,合作伙伴无需修改 URL 或代码。
AWS has added Cluster Mode to Elastic Beanstalk, running applications on EKS clusters the service creates and operates. Clusters are assigned by subnet set and cannot be changed afterward, direct...
本文介绍用 Kiro AI Agent 配合 AWS 开源 MCP Server 辅助 Amazon EKS 集群升级。方案将官方最佳实践与企业运维规范编码为 Skill 和 Steering,通过自然语言驱动升级前检查、控制面逐版本升级、Add-on 升级、节点组蓝绿替换及升级后验证。采用默认只读、关键步骤人工确认、前后快照对比,降低操作复杂度与风险,实现安全可控可审计的升级。
ReadyOn在Amazon EKS上为多租户平台构建“四墙”隔离架构:命名空间隔离、Karpenter专用节点池、VPC安全组与网络策略、每租户独立Aurora数据库。四层防御叠加,跨租户需突破全部屏障。结合GitOps、IRSA短期凭证与容器加固,实现零信任租户隔离。
Equinix 将自管 Kubernetes 迁移至 Amazon EKS,采用多账户共享服务架构,分离工作负载、平台、网络三类账户,由云运维团队集中治理基础设施,应用团队专注业务。成果包括运维开销降低 40%、部署频率提升 4 倍、架构统一,并改善可观测性、安全性与新团队上线速度。
本文介绍企业级EKS集群生产环境配置最佳实践,涵盖私有cluster endpoint、VPC Endpoints、Pod Identity替代IRSA、双EBS+LVM隔离容器运行时及四种CSI Driver接入。通过开源Terraform模块,一次apply约30分钟建成集群,并配9项健康检查验收,解决安全合规、节点稳定性、存储多样、弹性扩缩容和部署效率五大问题。
本文介绍EKS上GPU工作负载的架构实践,涵盖计算节点、网络邻近性和高性能存储三层。重点包括:EFA多网卡配置(含p6-b300特殊拓扑)、四种定价模式、基于AWS原生拓扑标签的调度、FSx for Lustre与S3 Express One Zone存储选型,以及Terraform模块实现,旨在提升分布式训练性能。
Kubernetes虽提升敏捷性,但并非自带安全,其动态复杂性常造成安全假象。企业普遍面临访问控制、容器镜像、集群配置、密钥管理及多租户等挑战,尤其在容器和集群层。Nutanix Kubernetes Platform(NKP)通过集中管理、默认安全策略、CIS加固、Gatekeeper准入控制及Istio加密,实现全栈防护,以应对AI时代的安全风险。
本文探讨亚马逊云科技容器环境中IP地址消耗问题,重点针对大模型训练/推理场景下大型GPU节点Pod密度低但VPC CNI默认预留大量IP导致子网浪费。文章分析EKS、ECS等场景的IP消耗风险,提出优化方案:优先考虑IPv6、Prefix Delegation、Custom Networking等架构调整,也可通过设置MINIMUM_IP_TARGET、WARM_IP_TARGET等参数控制单节点IP分配,并强调需同步配置kubelet maxPods、监控和验证。
本文探讨了机器学习容器镜像体积庞大(可达20-30GB)导致拉取缓慢的问题,指出瓶颈在于软件串行处理流程而非网络或硬件。通过并行分块下载和并行解压的优化方案,将拉取时间从几分钟缩短至几秒。这些改进已默认应用于EKS Auto Mode,并贡献给containerd开源项目,使整个生态系统受益。
AWS EKS推出Kubernetes控制平面版本回滚功能,允许升级后7天内通过API恢复至旧版本,无需额外成本。此前升级不可逆,导致团队延迟升级。EKS还提供升级洞察、回滚就绪检查和MCP服务器,简化升级流程,降低风险,使升级成为常规运维任务。
Amazon EKS has recently introduced support for Kubernetes version rollbacks, letting practitioners revert a cluster's control plane to its previous Kubernetes version within 7 days of an upgrade...
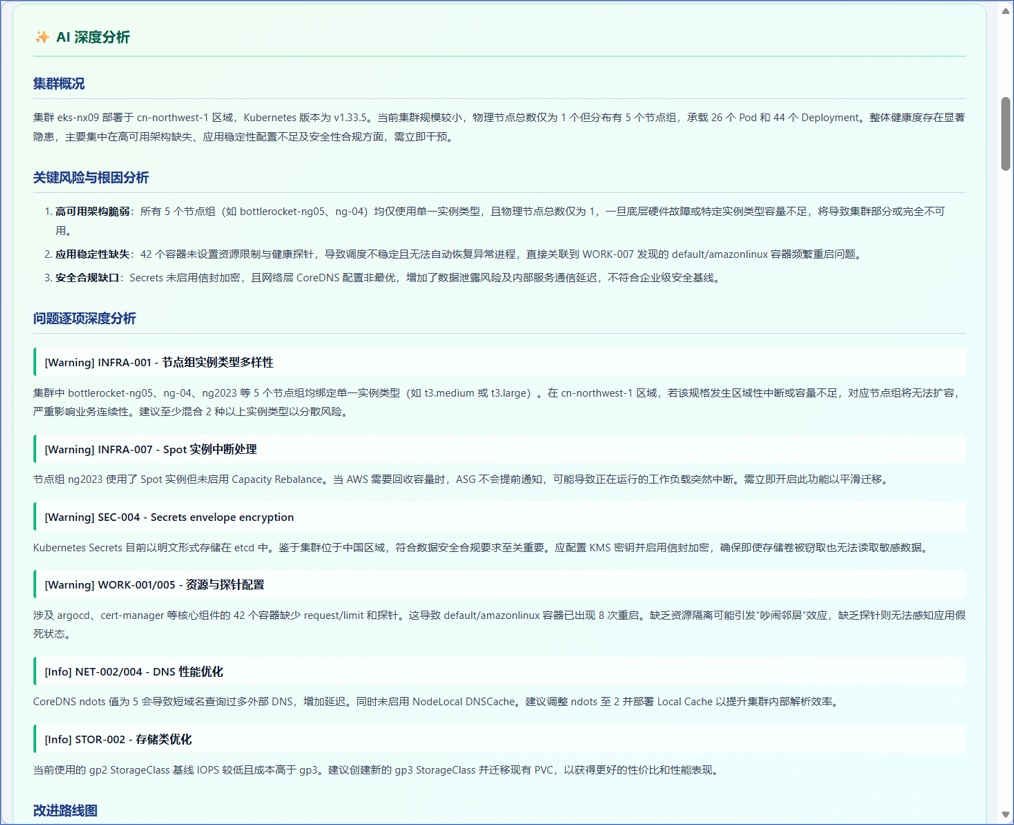
本文介绍了一个面向Amazon EKS用户的AI驱动集群健康诊断SaaS平台,采用“确定性规则+AI关联分析+MCP Agent自主诊断”三层架构,实现从静态规则检查到AI Agent按需实时采集集群数据的智能化运维诊断,帮助用户快速定位集群配置风险并获得可执行的修复建议。
AWS在EKS Auto Mode中开源了节点监控代理,自动检测并修复节点故障,如GPU掉线、内核崩溃等。系统通过NodeConditions触发Karpenter自动替换节点,无需人工干预。设计上区分致命与信息事件,避免误判,并优化了CPU抖动以减少对GPU训练的干扰。诊断通过kubectl ekslogs获取日志,无需SSH。整个流程从故障检测到替换约12分钟,显著降低运维负担。
本文介绍了在Amazon EKS上构建开源可观测性数据栈的实践,使用VictoriaMetrics、Grafana Loki和Grafana Tempo处理指标、日志和链路数据。通过OpenTelemetry Operator实现微服务的零代码接入,并在Grafana中关联trace、log和metrics,提升故障排查效率。数据存储在Amazon S3和EBS gp3,整体架构清晰,运维负担较低。
本文介绍了一种基于Amazon EKS的AI Agent沙箱方案,旨在实现多租户环境下的安全隔离和代码执行。通过使用Kata Containers和Cloud Hypervisor,提供独立的microVM,确保用户会话之间的完全隔离。该方案还包括预热池和自动扩缩容机制,以满足快速响应需求,适用于编程助手和合规环境。
本文介绍了Curvine如何在EKS上支持万级AI Agent的存储需求。随着AI基础设施向分布式模式转变,存储架构面临挑战。Curvine作为高性能分布式缓存文件系统,提供POSIX语义,支持快速动态存储供给,成功支撑10,000个独立Pod,展示了其在高密度有状态实例中的优势。
本文探讨了如何通过Kiro-cli在AI时代实现EKS集群的自动化升级。以EKS 1.32升级到1.35为例,使用Kiro agent进行风险识别、升级执行和故障排查,显著提高效率。实验表明,加载Skill知识库后,升级时间从约6小时缩短至2.5小时,节省60%。Kiro agent能够自主执行任务,并在实践中发现新约束,更新知识库,展现出知识库的成长潜力。
完成下面两步后,将自动完成登录并继续当前操作。