小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
DeepSeek-V4.1 模型结构(7):输入端与优化器

DeepSeek-V4.1在主干外有两处改动。视觉端:自研DeepSeek-ViT从零训练,采用2D-RoPE、RMSNorm、SwiGLU,经3×3 pixel-unshuffle将token数除以9,再投影到5120维;1302×1302图像占994个位置,文本与图像token各用一套MoE负载均衡偏置。优化器端:head-wise Muon按注意力头分别正交化query权重;Sinkhorn-balanced update以行列交替归一化替代Adam二阶动量,仅存一份动量即可训练196B参数的Engram表。

DeepSeek-V4.1 模型结构(7):输入端与优化器

Java不加糖's Blog Java不加糖's Blog · 2026-10-02T13:10:00Z
DeepSeek-V4.1 模型结构(5):记忆,Engram

DeepSeek-V4.1 在第1、14层引入 Engram 条件记忆:按 token 的 2/3/4-gram 哈希查表,用中国剩余定理以 8 个头区分 n-gram,经门控加入残差流。两张表共 196B 参数,FP8 存储,不占激活参数。相比原版去掉因果卷积、改用 Sinkhorn 更新,推理与事实问答提升明显。

DeepSeek-V4.1 模型结构(5):记忆,Engram

Java不加糖's Blog Java不加糖's Blog · 2026-10-02T12:50:00Z
DeepSeek-V4.1 模型结构(0):一张图看懂 DeepSeek-V4.1-Flash

DeepSeek-V4.1-Flash主干552B参数、40层,另有196B Engram表。核心是压缩KV cache:全局KV降至890字节/token,约为V4-Flash的四分之一,磁盘缓存仅八分之一。前20层为encoder,后20层为decoder,decoder全局KV由第20层投影共享。prefill每token激活8B、只算20层,decode为16B。引入CSA2共享池、Single-Pass mHC、Engram、DSpark与视觉通路。

DeepSeek-V4.1 模型结构(0):一张图看懂 DeepSeek-V4.1-Flash

Java不加糖's Blog Java不加糖's Blog · 2026-10-02T12:00:00Z
Engram 是一款采样器,能将破碎的 AI 幻觉转化为音乐

音乐初创公司Thoughtful Things为采样器Engram发起众筹。该设备本地运行定制小型AI模型,可扭曲音频并生成幻觉般的新声音,面向实验音乐创作,而非一键生成歌曲。固件将开源,支持加载自定义模型。众筹价675美元起,零售价预计850至900美元。

Engram 是一款采样器,能将破碎的 AI 幻觉转化为音乐

The Verge The Verge · 2026-09-27T20:46:36Z
中国模型Engram/N-Gram记忆体引爆AI新竞赛

DeepSeek与阿里通义推出Engram/N-Gram记忆模块,为Transformer增加“记忆硬盘”,将固定知识查找从计算中分离,提升推理效率。实验显示性能提升,但社区测试发现其擅长短语补全而非事实回忆,且DeepSeek V4未采用Engram。该技术尚处探索阶段,可能改变AI竞赛格局。

中国模型Engram/N-Gram记忆体引爆AI新竞赛

极道 极道 · 2026-08-26T23:30:00Z
Engram是一款基于心理学和神经科学的学习插件,现已上线DSH

Engram是一款基于心理学和神经科学的学习插件,支持DeepSeek Harness等八个AI编程平台。它通过概念图分解主题、先预测后教学、盲审评估和FSRS间隔复习,帮助人类真正记住知识,而非增强AI记忆。核心命令包括/learn、/review和/coach,强调科学方法,拒绝流行迷思,纯本地运行。

Engram是一款基于心理学和神经科学的学习插件,现已上线DSH

极道 极道 · 2026-08-20T02:45:00Z
DeepSeek V4最大的遗憾

Engram是DeepSeek与北大联合开源的知识查找模块,旨在提升大模型的记忆与效率。尽管在DeepSeekV4中未出现,Engram的理念和应用仍在发展。研究表明,Engram通过优化Transformer结构,提升了模型的推理能力和知识检索效率,显示出在内存管理和视觉任务中的潜力。

DeepSeek V4最大的遗憾

量子位 量子位 · 2026-05-03T03:43:37Z
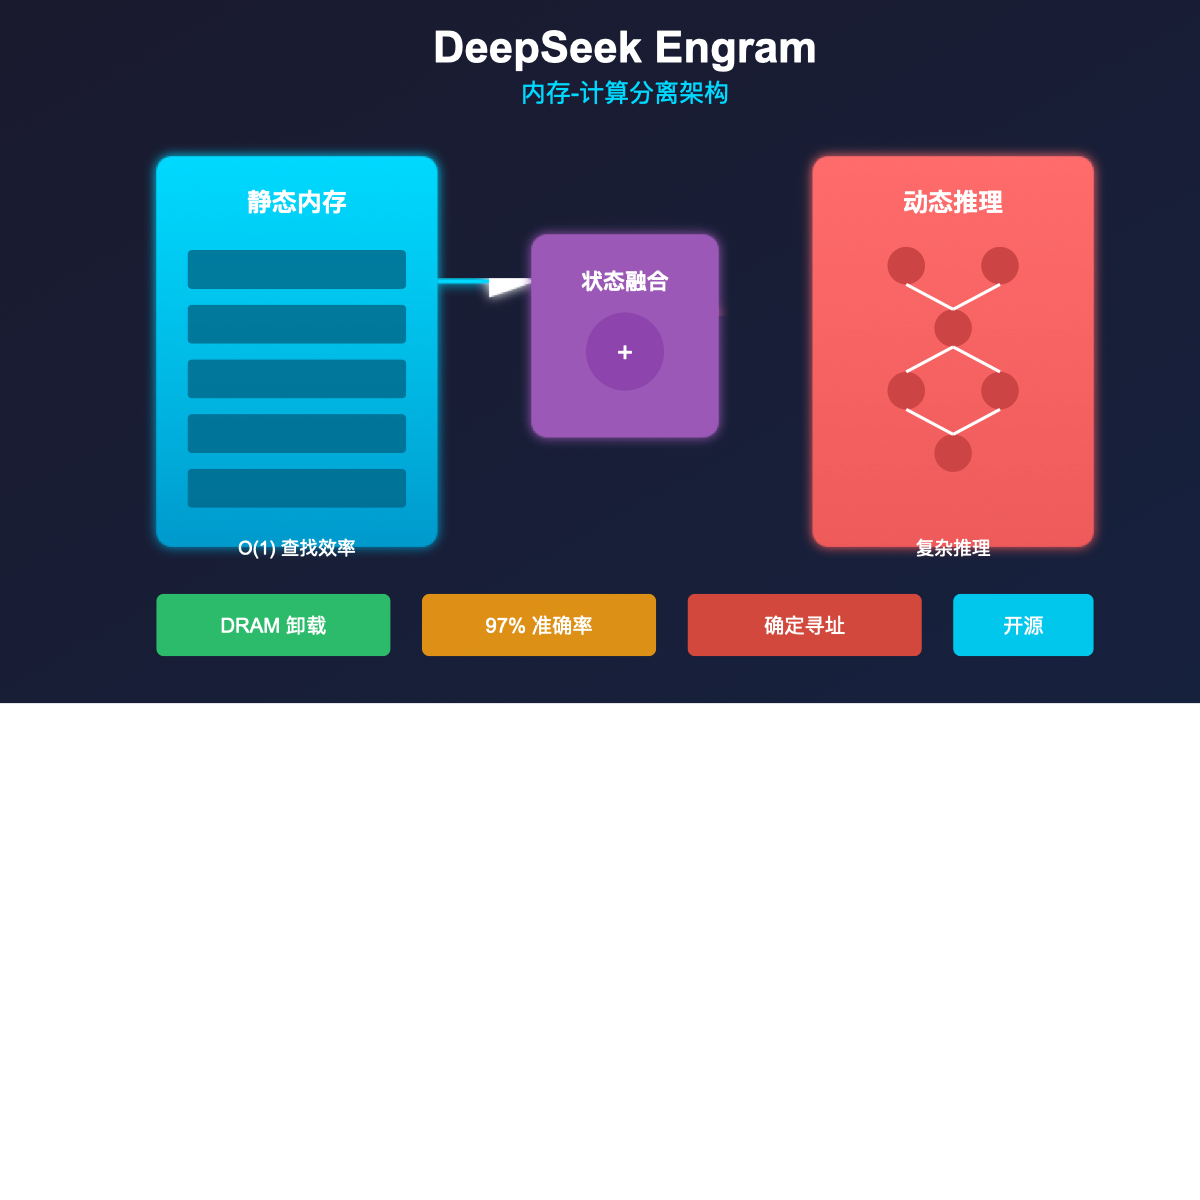
DeepSeek Engram:颠覆GPU内存瓶颈!把知识存储从计算中分离,O(1)查找效率!

DeepSeek与北大团队推出的Engram系统,通过分离静态知识存储与动态推理,实现O(1)查找效率,降低了对昂贵GPU内存的需求。这一创新在普通DRAM中存储大量知识,提升了大模型的性能和成本效益,尤其对中国AI公司具有重要意义。

DeepSeek Engram:颠覆GPU内存瓶颈!把知识存储从计算中分离,O(1)查找效率!

Micropaper Micropaper · 2026-02-28T17:15:00Z
受DeepSeek Engram启发,基因组基础模型「外挂大脑」Gengram最高实现22.6%性能提升

基因组基础模型Gengram通过k-mer哈希记忆机制显著提升基因组功能任务的性能,避免了传统模型的低效率,直接存储碱基序列,优化训练过程,提高预测准确性,推动基因组建模向更高效、可解释的方向发展。

受DeepSeek Engram启发,基因组基础模型「外挂大脑」Gengram最高实现22.6%性能提升

HyperAI超神经 HyperAI超神经 · 2026-02-06T06:45:17Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码