By Oleksii Tkachuk, Rajiv Shringi, Chris Lohfink, Abe Ratnofsky, Kartik SathyanarayananIntroductionIn an earlier post, we introduced the TimeSeries Abstraction, our high-throughput, low-latency...
本指南介绍在Ubuntu 24.04上安装使用Flink 2.3.0,需先安装JDK 17和Hadoop 3.5.0。步骤包括:解压安装包至/usr/local、配置环境变量、启动集群并验证进程、运行自带WordCount样例、用Maven编写打包自定义WordCount程序(含数据源、分词器、主类及pom.xml),最后通过flink run提交并在Web界面查看结果。
Atlassian团队用Kafka、Flink和OpenTelemetry重建自动事件检测平台AutoHOT,将事件到指标延迟从40秒降至10秒内,月成本从2万美元降至650美元。检测召回率从60%升至86%后回落至64%,精确率仍不理想。关键教训:召回率反映检测器质量,覆盖率取决于埋点选择,二者不可混淆;客户端遥测无法发现数据库宕机等沉默故障。
Lyft has moved hundreds of production Flink jobs from a 2020 in-house Kubernetes operator to the Apache Flink Kubernetes Operator, unlocking last-state upgrades, in-place autoscaling and resource...
IBM Confluent从实时数据流平台演进为面向AI的实时上下文与行动底座,提供感知、供数与行动三层能力,支持异常检测、个性化推荐和IT运维等场景。收购后,结合Kafka和Flink,帮助企业从被动分析转向主动实时行动,让AI融入业务过程。
Netflix is moving toward the open-source Apache Flink Autoscaler for more than 30,000 streaming jobs across multiple AWS regions. The operator-level approach addresses limitations of Netflix’s...
Samuel Yeboah, Francesco Di Chiara and Mingliang LiuToday, Netflix runs two Flink autoscalers. That is exactly one more than we want. We built the first one in-house years ago, when there was no...
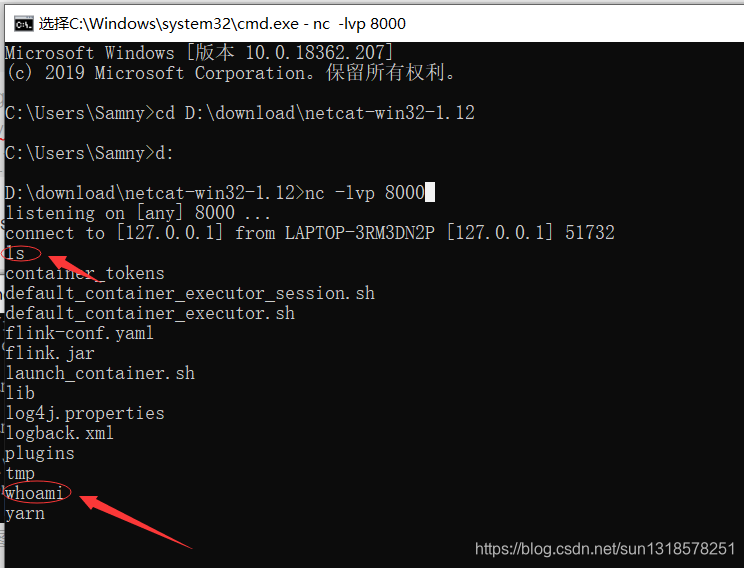
Apache Flink存在任意Jar包上传导致远程代码执行的高危漏洞,影响版本≤1.9.1。攻击者可通过上传恶意Jar包获取服务器shell。文章详细介绍了漏洞复现过程,包括生成payload、监听端口及上传步骤,并提供了批量检测脚本,同时提醒需使用公网IP及注意授权问题。
Apache Flink 存在高危漏洞,允许任意 Jar 包上传并导致远程代码执行,影响版本为 1.9.1 及以下。复现过程包括生成 payload、监听端口和上传 payload,建议使用 Sunny-ngrok 进行端口转发。提供了批量检测脚本的 GitHub 地址供研究学习使用。
本文讨论流式数据处理的规划,重点在于Kafka与Flink的结合。内容涵盖流处理基础、Kafka内核、Flink运行时、状态管理及交付语义,旨在解决实时数据链路中的关键问题,如事件时间、窗口处理、状态管理及故障模式。目标读者为数据平台工程师,帮助他们理解流式计算与批处理的差异,以及如何有效运维Kafka和Flink管道。
本文讨论了使用Kafka 3.x(KRaft)和Flink 1.20+进行流处理实验的复现步骤,包括环境设置、事件时间与处理时间窗口、Kafka日志解读、事务处理和检查点间隔等内容。实验结果将记录在output/目录中,以确保实验的准确性。
本文讨论了Flink中EmbeddedRocksDBStateBackend的机制,重点在于KeyGroup前缀、增量checkpoint的实现及其与RocksDB的关系。增量checkpoint依赖于不可变SST文件和MANIFEST,以确保数据一致性。文章还比较了Flink、TiKV和Kafka Streams在状态管理和容错机制上的差异,强调了设计与参数调优的重要性。
本文讨论了RocksDB中的列族(Column Family, CF)机制,强调其共享WAL和独立MemTable/SST的特性。CF允许在同一数据库实例中实现多组比较器和独立的压缩策略,以满足不同状态变量的隔离需求。文章还介绍了Flink如何将多种状态变量映射到不同的CF,以优化性能和管理。WAL的回收机制与CF的flush操作密切相关,影响整体性能。
本文探讨了RocksDB的内核机制,包括LevelDB、WAL、Compaction和Column Family等,重点分析了其在流计算和数据平台中的应用,尤其是在Flink和TiKV中的嵌入方式。同时讨论了写优化LSM的实现、读写路径、Compaction策略及其对性能的影响,适合流计算工程师和存储开发者阅读。
本文介绍了 Apache Flink 的运行时架构,重点讲解了 JobManager、TaskManager 和 Slot 的角色及功能。Flink 的数据流作业通过 StreamGraph、JobGraph 到 ExecutionGraph,最终在 TaskManager 的 Slot 上执行。文章还探讨了算子链的合并条件、并行度与资源管理的关系,以及如何通过 SlotSharingGroup 实现资源隔离与利用率优化。这些概念有助于优化 Flink 作业的性能与资源配置。
本文探讨流式数据处理中的关键问题,包括事件时间、窗口、Kafka与Flink的状态管理、checkpoint机制及其在乱序事件中的应用,重点分析如何实现端到端的exactly-once语义,以及背压和数据倾斜等故障的诊断与处理。
本文探讨流式数据处理的核心概念,包括流处理、批处理和微批的区别,以及如何通过Kafka和Flink实现有状态计算。强调流处理在无界输入和乱序情况下的容错机制,比较流表对偶与Lambda/Kappa架构,指出流处理的关键在于定义输出时机、状态存储和容错策略。
本文讨论了Flink中的时间语义及其在有状态计算中的应用,主要包括事件时间、处理时间和摄取时间的定义与选择。重点介绍了watermark的生成与处理策略,以及如何通过允许的迟到时间和侧输出处理迟到数据。最后,强调了事件时间在流式聚合与批处理对齐中的重要性。
本文讨论了Flink中的三种窗口类型:滚动窗口、滑动窗口和会话窗口。详细分析了每种窗口的定义、状态管理、输出频率及适用场景。滚动窗口固定不重叠,滑动窗口允许重叠,会话窗口根据事件间隔动态调整。此外,还介绍了触发器和状态裁剪器的功能,以及如何选择合适的窗口类型以优化流处理任务的性能。
本文讨论了Apache Kafka 3.x中的幂等生产者和事务生产者的工作机制。幂等生产者通过Producer ID和序列号消除重复消息,而事务生产者确保多分区消息的原子性。消费者隔离级别分为read_committed和read_uncommitted,影响事务数据的可见性。Flink与Kafka结合实现了端到端的exactly-once语义,确保数据一致性。
完成下面两步后,将自动完成登录并继续当前操作。