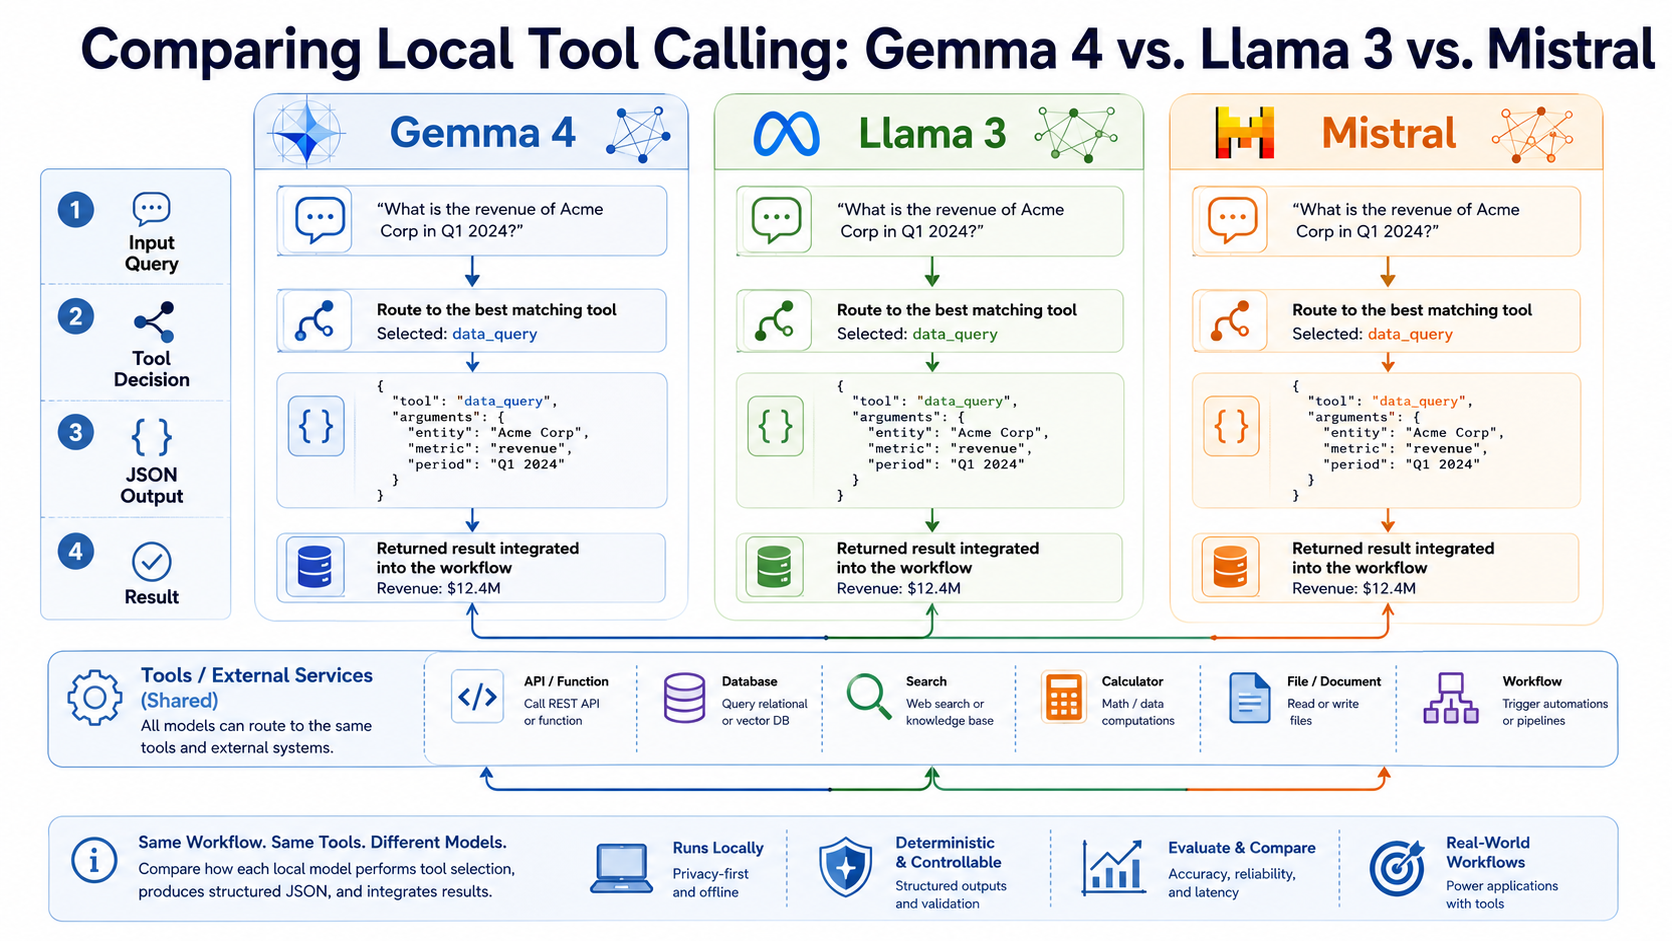
本文比较了Gemma 4、Llama 3和Mistral三种本地部署模型的工具调用功能。Gemma 4原生支持工具调用,适合边缘设备;Llama 3生态丰富,社区支持强;Mistral效率高,适合硬件受限场景。三者均通过JSON格式实现工具调用,但各有优劣,选择取决于硬件和部署需求。
本文汇总了Hacker News热门技术话题:KOReader开源阅读器改善旧Kindle体验;Swift/Metal推理引擎让Gemma 4 26B模型仅需2GB内存运行;OpenAI发布代码安全工具;Superlogical构建跨环境终端多路复用器;用户脚本在侧边栏加载HN讨论;演示场景工具界面回顾;越狱Kindle的Tailscale代理功能;AI蠕虫可经Copilot for Word传播;音乐人Kavinsky去世;《半条命》移植至Mac OS 9。
Gemma 4是谷歌DeepMind推出的文档解析工具,能够处理扫描和数字PDF,提取发票信息。它通过将PDF页面渲染为高分辨率图像,利用视觉语言模型读取内容,克服传统文本提取工具的局限性。该工具支持灵活的视觉令牌预算,以适应不同文档的复杂性,确保高效准确的提取。
谷歌在6月发布了一系列AI更新,包括本地运行的Gemma 4 12B模型、Android 17的浮动窗口和安全升级、新的财务应用以跟踪投资、Gemini 3.5的实时语音翻译,以及NotebookLM和教育工具的个性化学习支持。此外,AI在气候预测和公共服务中展现潜力。
本文介绍了在RTX4060上本地部署Gemma4-26B-A4B模型的过程与效果。通过Q8缓存量化和MTP加速,模型输出速度可达40 tokens/s。尽管在翻译和数学问题上表现一般,但在SQL测试中与其他模型相当。文章还讨论了模型的参数设置及其对性能的影响。
本文讨论了本地编码模型的进展,重点介绍了Qwen3.6、Gemma 4和DiffusionGemma等模型的优势。Qwen3.6适合各种编码任务,Gemma 4支持多模态输入,适合处理文档和界面问题,而DiffusionGemma以高效生成著称,适合快速编码。这些模型为开发者提供了强大的本地编码支持。
本文介绍了2026年值得关注的12个开源大型语言模型(LLMs),如Meta的Llama 4 Scout、阿里巴巴的Qwen3和谷歌的Gemma 4等。这些模型在性能、成本和应用场景上各具特色,适用于不同任务需求。文章还探讨了单代理与多代理架构的区别及使用中的权限模式。
本周AWS发布了多项新功能,包括AWS FinOps代理的预览版,旨在帮助团队优化成本和调查异常。同时,Amazon Bedrock上推出了Gemma 4和Claude Fable 5模型,具备多模态能力和高效性能。此外,AWS Summit将在纽约举行,讨论云和人工智能的最新动态。
谷歌DeepMind发布了DiffusionGemma,一个优化的文本生成模型,能够并行生成多个词,显著提高生成速度。该模型基于Gemma 4架构,性能比传统模型快4倍,适合低延迟的单用户应用,如互动聊天和智能助手,并支持本地生成,无需云计算。
Gemma 4是谷歌DeepMind最新的开源模型,性能更高且计算成本更低,支持多种设备,适用于内部工具和生产环境。文章介绍了如何安装Ollama和Gemma 4,以及配置Claude Code以实现高效的代码生成和调试。Gemma 4能够处理复杂的编程任务,如代码分析和测试生成,适合日常工程使用。
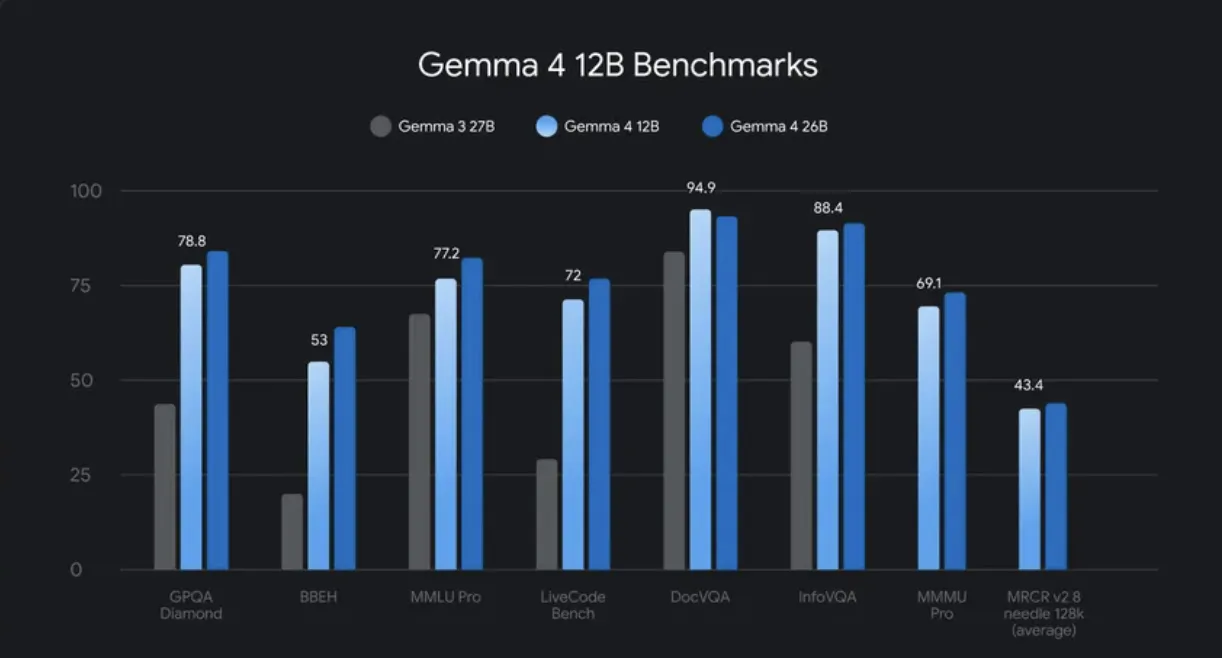
Google DeepMind 发布了新款多模态模型 Gemma 4 12B,参数为120亿,但在多项测试中表现接近260亿参数的模型。其无编码器架构显著降低了推理延迟和内存占用,支持音频输入,并可在普通笔记本上运行,降低了部署成本,为开发者提供了接近顶级性能的选择。
Gemma 4是最新的开源模型,已被下载超过1.5亿次。它支持低延迟的离线应用,如HubX的英语辅导平台BetterSpeak,利用量化模型实现私密学习。此外,Gemma 4具备视觉语言处理能力,能够进行物体识别和图像描述,适用于多种创意项目。
Google推出的Gemma 4 QAT模型通过量化感知训练技术,将AI模型从4GB压缩至1GB,使其能够在普通手机上本地运行。这项技术提升了隐私保护和响应速度,普通用户可以轻松下载和使用这些模型,未来将带来更多应用场景。
Gemma 4最近发布了优化的量化感知训练(QAT)检查点,提升了模型在移动设备上的效率,减少了压缩时的质量损失,显著降低了内存占用,适合在日常边缘设备上运行。新模型支持多种开发工具,用户可轻松下载和部署。
谷歌推出基于AI的应用Dreambeans,整合用户的Google服务信息,生成生活灵感内容,鼓励用户回归现实生活。该应用目前仅面向美国的Google AI Ultra订阅用户。同时,谷歌开源了Gemma 4 12B多模态模型,旨在降低AI模型的运行门槛,支持本地设备使用。此外,Google AI Edge Gallery已推出macOS版本,强调隐私保护和离线运行。
谷歌发布了Gemma 4 12B多模态模型,支持文本、图片、视频和音频输入,能够在仅16GB内存的消费级设备上运行。该模型采用无编码器架构,降低延迟并简化输入处理,智能化程度接近Gemma 26B版。开发者可在多个平台体验和下载该模型。
Google DeepMind 发布了 Gemma 4 12B,这是一个无编码器的多模态模型,支持文本、图像、音频和视频处理。该模型在消费级笔记本电脑上运行,性能接近 26B MoE 模型,但内存占用不到一半。它通过直接输入视觉和音频数据,简化了处理流程,提升了整体质量和指令遵循性。
本文介绍了为Gemma 4模型添加的两个新工具:沙盒文件系统浏览器和受限的Python解释器。这些工具使模型能够自主检查环境和执行代码,从而提升其代理性。文章详细阐述了工具的设计、安全性考虑及实际应用测试,展示了模型如何有效处理信息和进行计算。
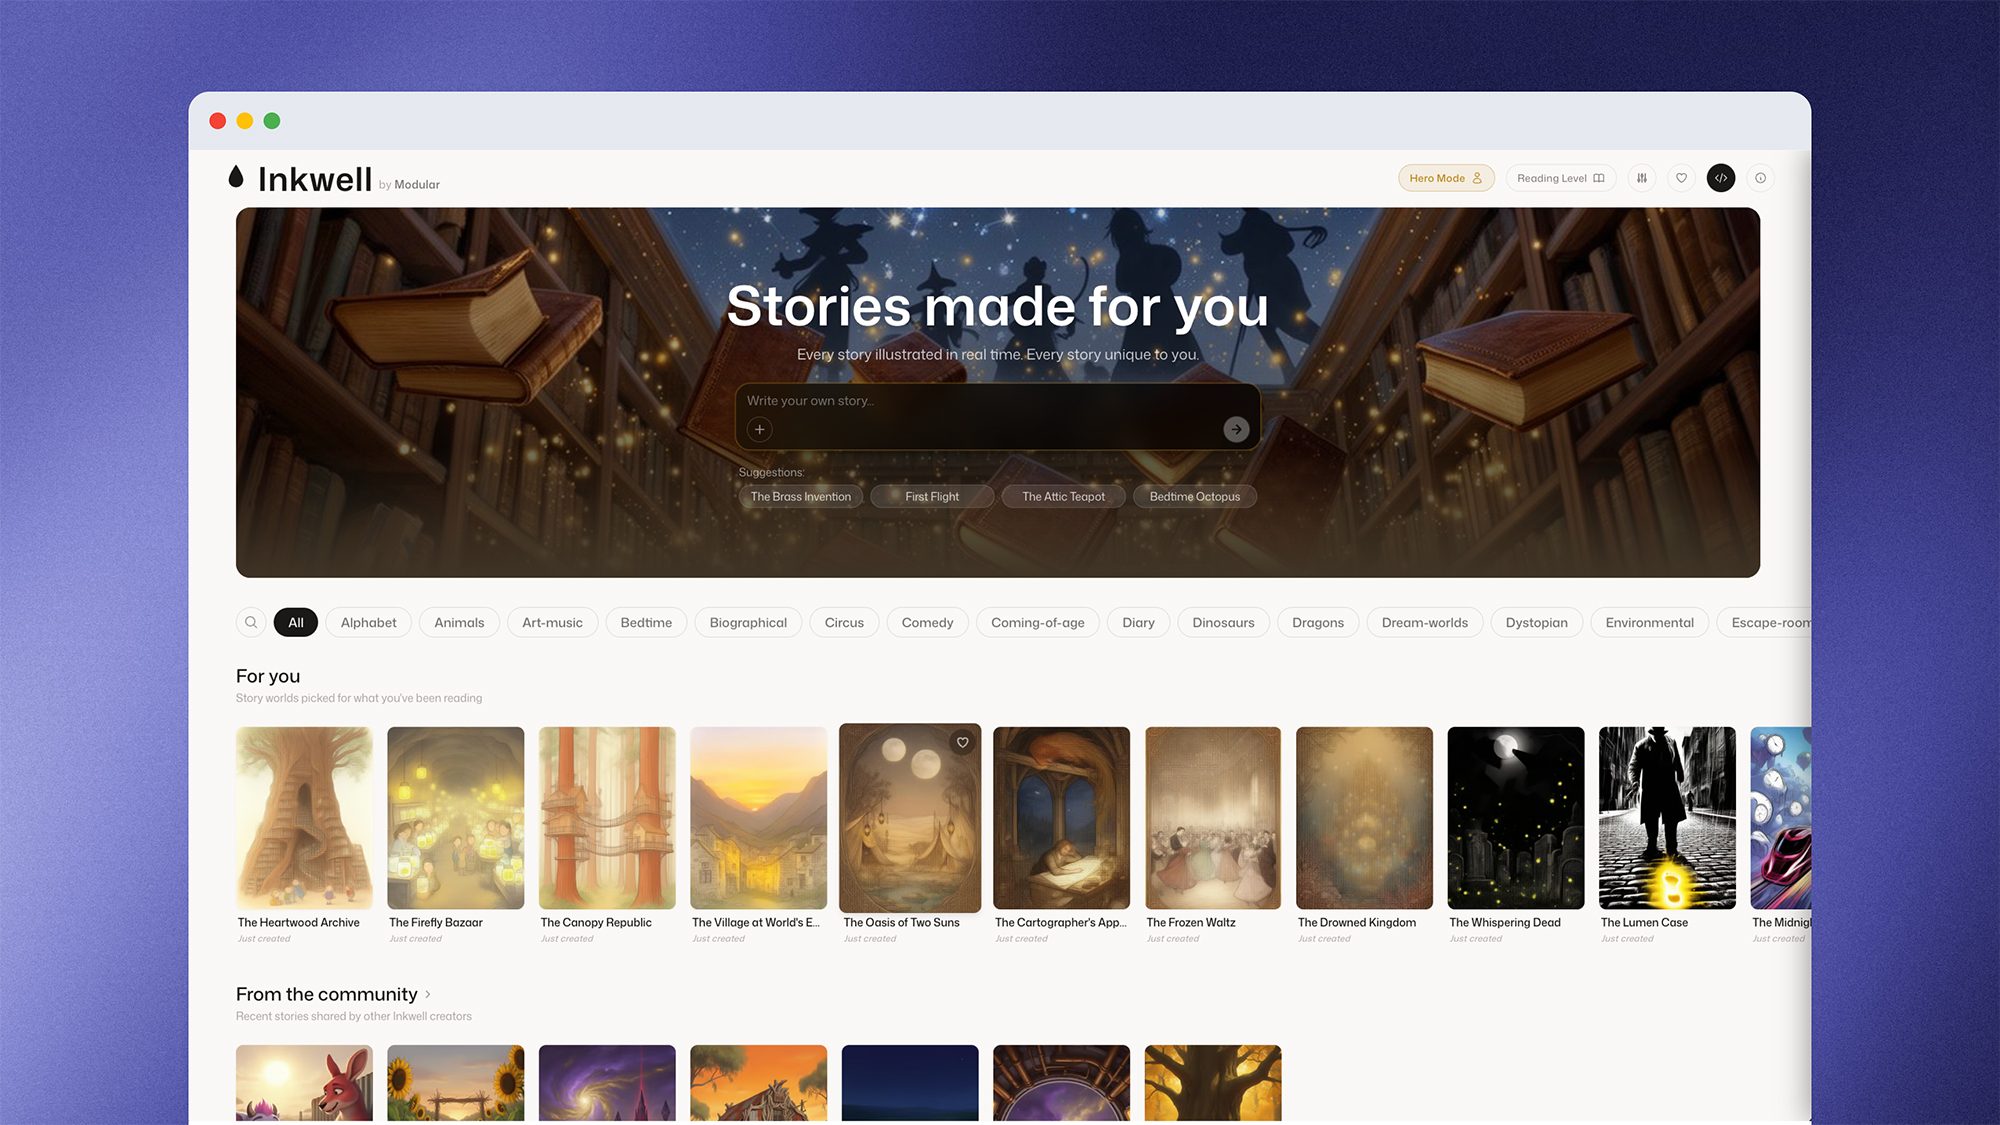
Modular推出了Gemma 4,旨在提升AI系统的响应速度。Tim Davis介绍了Inkwell,一个实时互动故事书应用,利用Modular Cloud实现快速文本和图像生成。通过优化推理层,Inkwell能在420毫秒内生成首个文本,并在6秒内完成插图,确保用户体验流畅,支持流式生成,减少等待时间,提升用户互动性。
Gemma 4推出了多令牌预测(MTP)模型,采用专门的推测解码架构,实现了三倍的速度提升,同时保持输出质量不变。MTP通过将重型目标模型与轻型草拟模型配对,减少延迟,提升AI应用在本地和边缘设备上的性能。MTP草拟器现已开源,开发者可在Hugging Face等平台下载和实验。
完成下面两步后,将自动完成登录并继续当前操作。