英伟达发布621.01版驱动,支持微软“高级着色器交付”技术,通过云端为不同硬件预编译着色器,消除游戏启动时的编译等待及游戏中的卡顿与CPU峰值。《战争机器:E-Day》和《使命召唤:现代战争4》已支持该技术,需安装Xbox PC应用,Steam购买的游戏同样受益。AMD和骁龙X2设备也有相应驱动支持。
TornadoVM, an open-source heterogeneous programming framework for Java, has reached version 7.0. It automatically accelerates Java programs on multi-core CPUs and GPUs and provides a rich GPU...
Elastic将Jina API和Elastic推理服务从NVIDIA L40迁移至RTX Pro 6000 Blackwell GPU,以加速智能体AI工作负载。实测显示:嵌入请求延迟最高降低约8倍,重排序提速4倍以上,OCR页面转换速度提升约3.7倍;混合负载下小请求延迟从708毫秒降至66毫秒。Jina小型模型在准确性和多语言、多模态覆盖上表现领先,迁移后客户无需改动即可受益。
Rust编译器团队新设两个小组:GPU目标通知组由AMD、英伟达、英特尔等厂商专家组成,旨在更好应对GPU相关问题;链接器小组源于MCP#964讨论,推动Wild等替代链接器集成,并作为链接器问题的联络点。两组各有Zulip频道,成员自愿关注并响应相关issue,主要协助维护。感兴趣者可向rust-lang/team仓库提交PR加入。
本文介绍OpenJDK Babylon项目的Java代码反射API及其异构加速器工具包HAT。HAT通过反射、转换、加速三阶段,将Java计算代码转为GPU友好表示并卸载至OpenCL或CUDA执行;演讲以张量核心编程和矩阵乘法为例演示,并用NVIDIA Nsight工具分析调优CUDA后端性能。
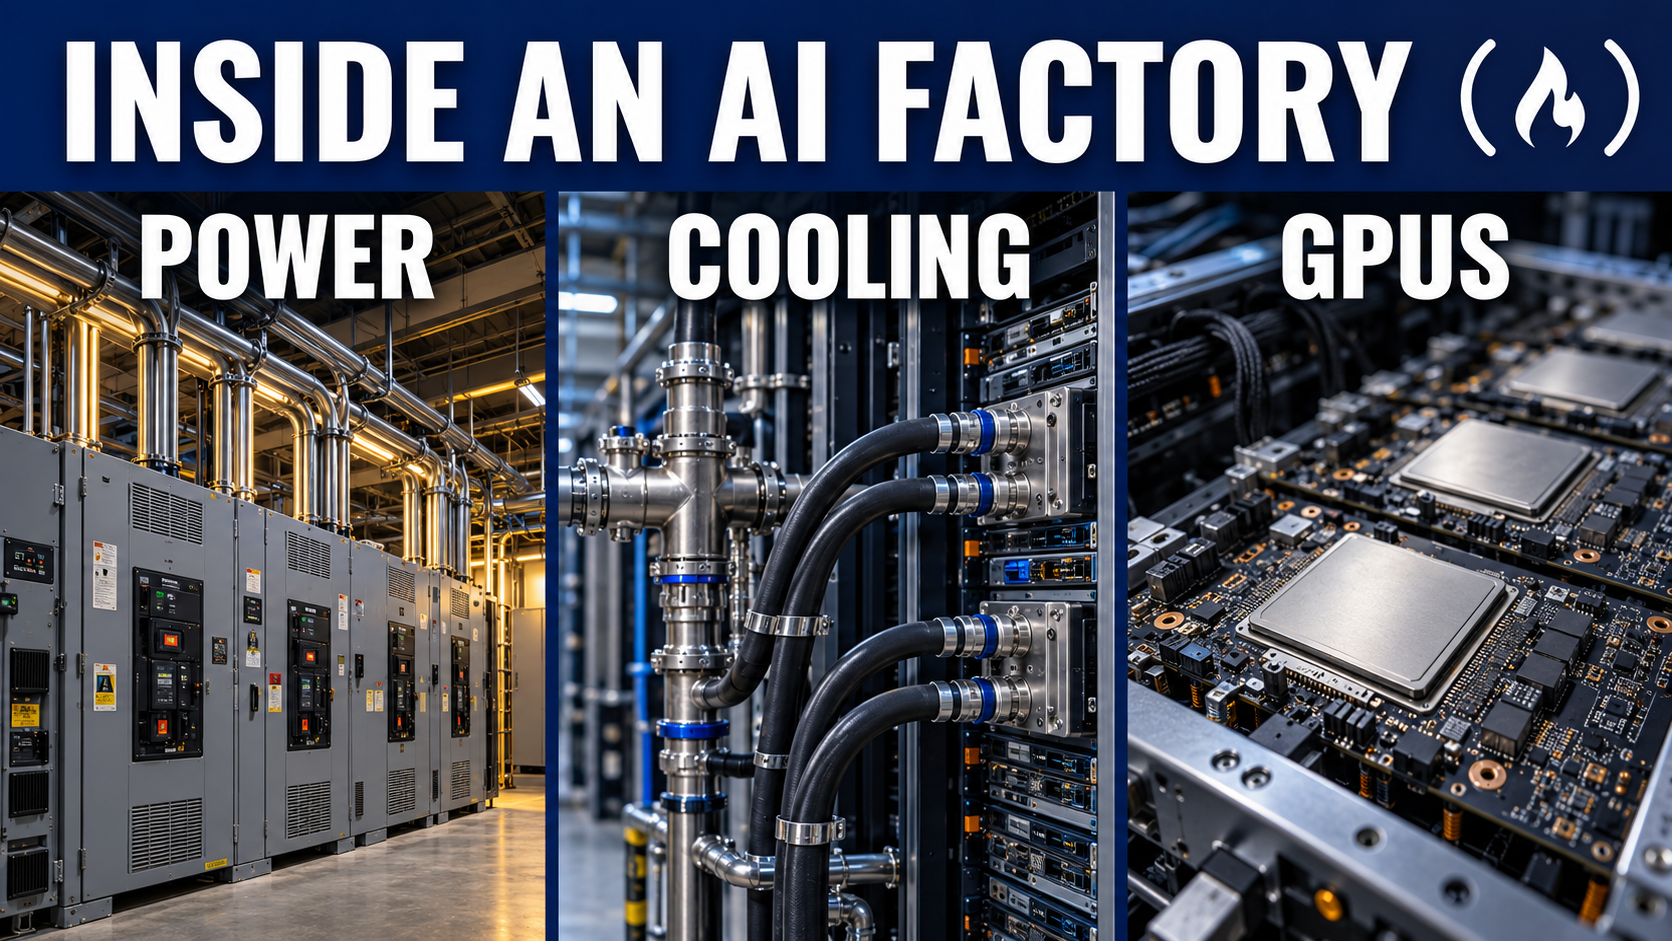
freeCodeCamp 发布 8 小时课程,详解支撑 GPT-4、Claude 等 AI 模型的数据中心基础设施,涵盖从电网到 GPU 的供电、高压配电与备份、液冷散热、光网络互联、多吉瓦级设施建设,以及 GPU 云托管和基础设施投资的经济学。
How we detect failing GPUs and network fabric, remediate machines automatically, and let long-running jobs survive hardware loss.Authors: Nick Rutigliano, Argha C, Samartha ChandrashekarOpen...
在Kubernetes中,GPU成本最高但最难按工作负载分摊。DCGM默认按物理设备上报,共享GPU时各Pod数据重复,无法准确归因。GPU按整数分配、不支持超卖,利用率指标也易误导。目前最可靠的是按显存计费,计算量仅作参考。共享方式包括时间切片、MPS、MIG和DRA,各有局限。
微软发布第三代自研AI芯片Maia 300,主打AI推理,能效比领先GPU系统40%,96加速器配置吞吐量达Maia 200的7倍。该芯片采用台积电N2P工艺与芯粒架构,2027年起大规模部署,将成为微软产品主要AI推理系统,减少对英伟达和AMD依赖,并支持自家AI模型研发。
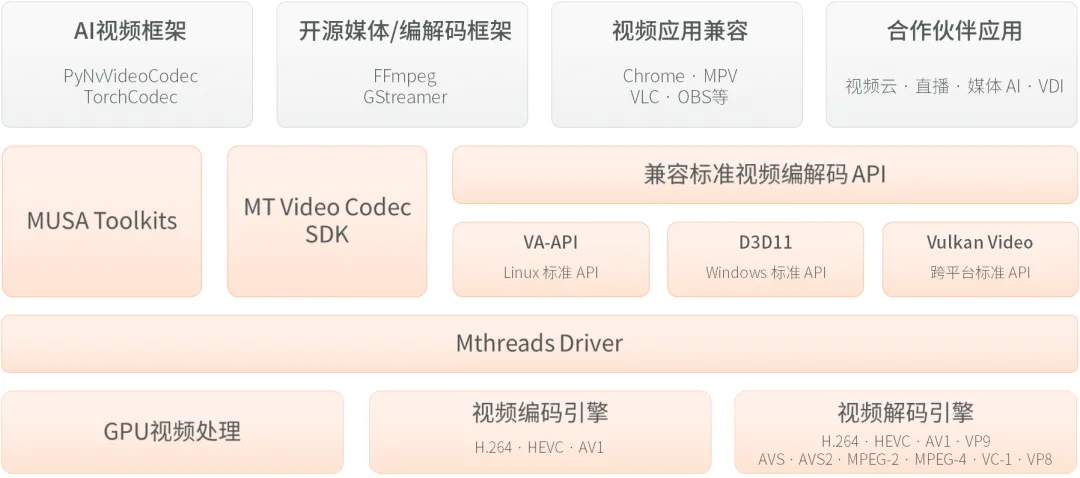
摩尔线程为FFmpeg、PyNvVideoCodec、TorchCodec三个开源项目完成MUSA平台原生支持,覆盖视频编解码、硬件加速与转码,为多媒体处理、Python视频开发和PyTorch视频AI提供国产GPU加速,降低迁移成本,项目已在GitHub开源。
论文提出Minions系统,将多台macOS设备中闲置的Apple Silicon GPU聚合成分布式虚拟GPU云,用于大规模机器学习推理,支持灵活任务执行、容错和高效资源利用,无需额外采购GPU,在集中式GPU资源受限时提供实用方案。
硅谷AI算力争夺加剧。Anthropic向SpaceX购买算力,马斯克成为GPU中间商;谷歌因算力不足流失顶尖研究员Shazeer至OpenAI;初创公司被迫签高价长约或全球寻找算力,顶级VC亲自囤积GPU。H100租赁价一年涨近40%,算力正成为AI时代准入门槛,强化大公司优势。
亚马逊ECS内置自动故障恢复机制:检测并修复GPU故障和实例失联,跨可用区均衡任务,容器崩溃时就地重启,日志默认非阻塞以避免拖垮应用。ECS负责常规恢复,同时保留用户控制权,并集成FIS用于故障测试。
开发者开源了Rust声明式绘图库Charton,填补了Rust生态中缺少类似Altair或ggplot2的图形语法高层库的空白,支持绘制常见图形,并可在nushell终端作图。
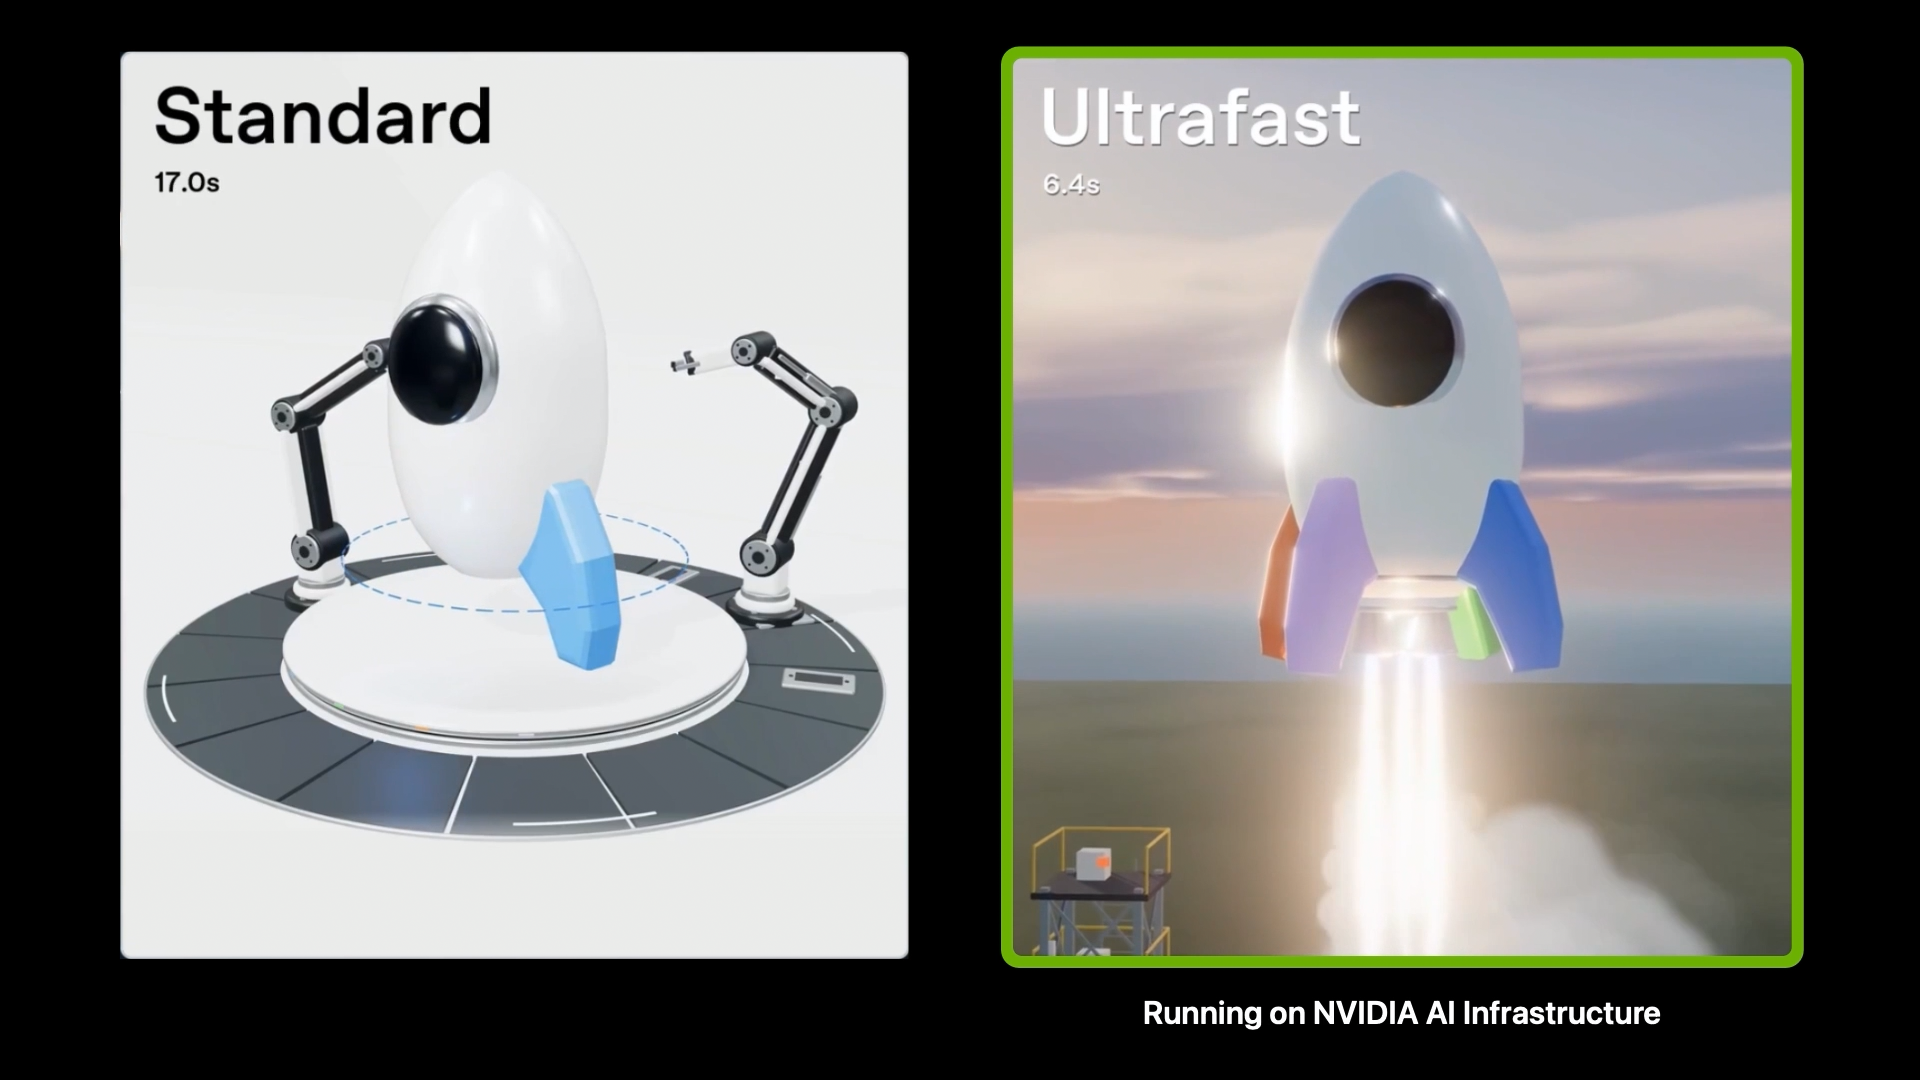
OpenAI推出GPT-6 Astra Ultrafast,运行于NVIDIA Blackwell GPU,通过持续推理优化,令牌生成速度比标准模式快8倍。该模型已上线OpenAI API,面向ChatGPT Work和Codex用户,可加速代码生成、工具调用和交互应用。OpenAI还利用自身模型优化GPU推理软件,提升性能与基础设施利用率。
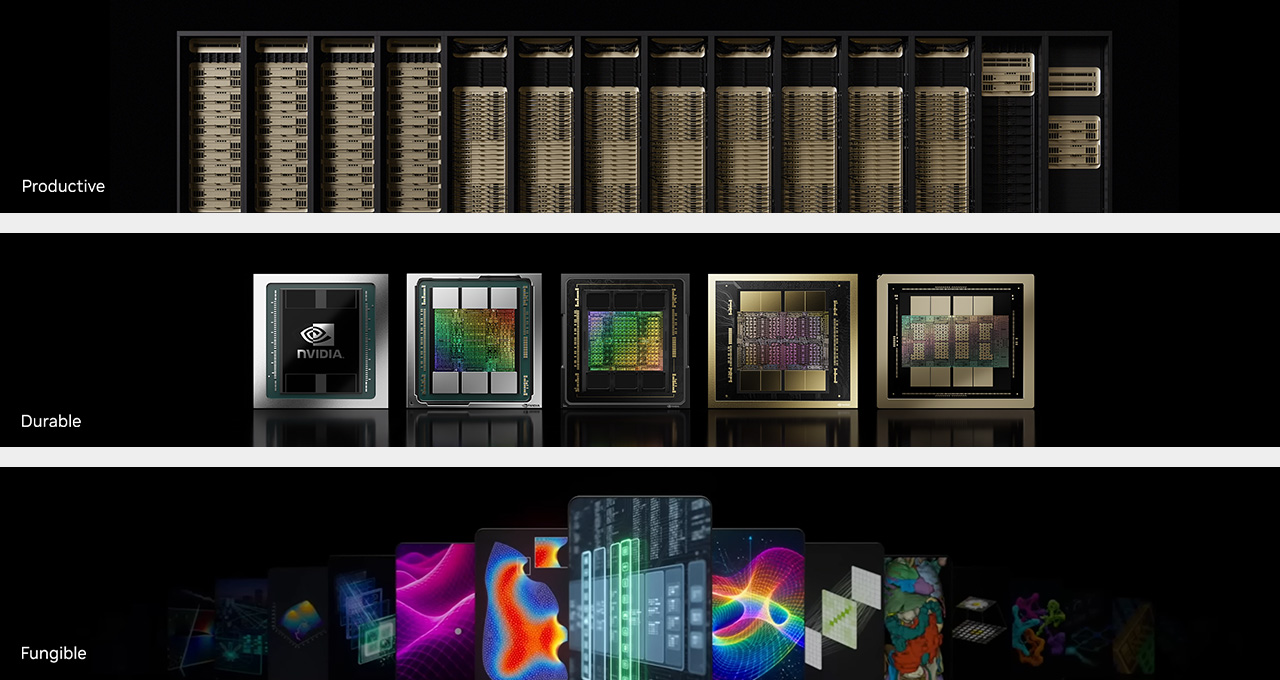
英伟达AI工厂每兆瓦建造成本约6000万美元,投资回报取决于产能、寿命和需求。其平台具备高产、耐用、通用三大特性:每兆瓦吞吐量最高、每token成本最低;GPU多年后仍可创收;可运行各类AI及非AI负载。全栈协同设计与CUDA软件持续优化,使旧硬件不闲置,从而最大化回报。
Adobe engineers have described an open-source approach for giving teams self-service access to their own Prometheus metrics in multi-tenant Kubernetes environments, without exposing the shared...
GitHub热门开源项目Colibrì是一个纯C实现的分层推理框架,通过将MoE模型不常用的专家权重存放在SSD、常用部分缓存在RAM/VRAM,使低配设备也能运行超大模型。它支持GLM-5.2、Kimi K3等9个模型,最低16GB内存即可运行744B模型,无需GPU,并采用LRU缓存与专家预测提升速度。
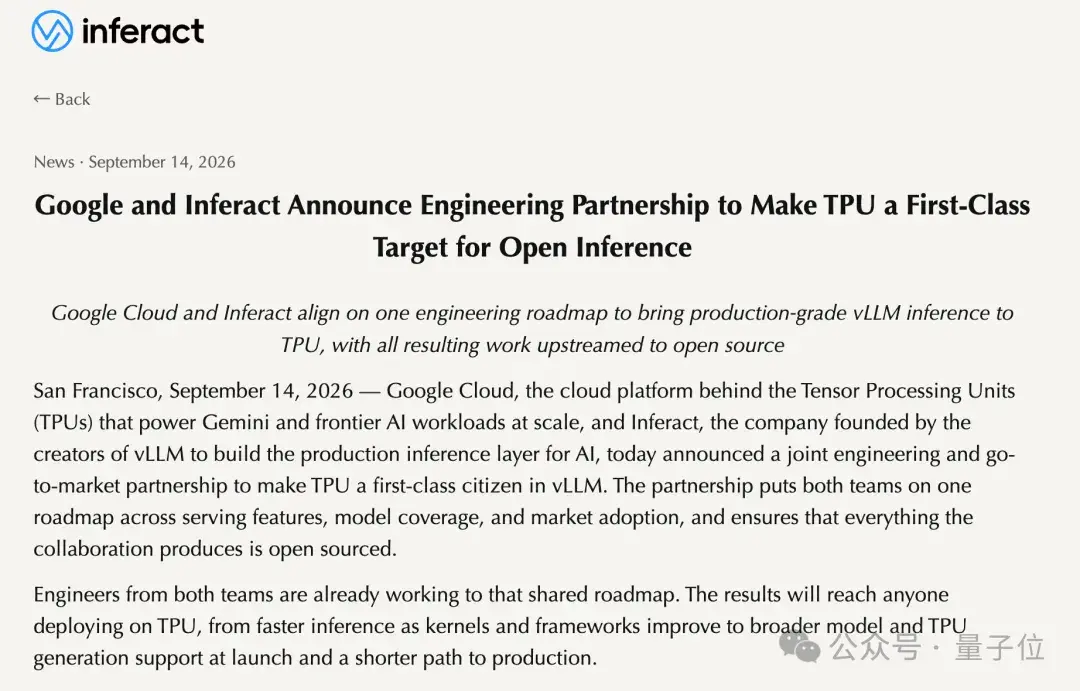
Inferact团队为谷歌TPU v7开发megakernel推理内核,将数百个小程序合并为一个大程序,消除调度间隙并实现跨层权重预取。16块TPU运行Kimi K3达每秒709 token,比GB200快57%,且精度无损。该团队源自vLLM,获a16z领投1.5亿美元融资,代码已开源。
按小时租用GPU算力已成主流。2026年一季度国内AI算力需求同比增长417%,供给仅增128%。算力平台分为国家超算、专业GPU云、大厂云和海外四类,T4实例约1.2元/小时起。模力方舟提供国产GPU按量计费,约4元/小时,支持预装镜像,适合信创合规场景。
完成下面两步后,将自动完成登录并继续当前操作。