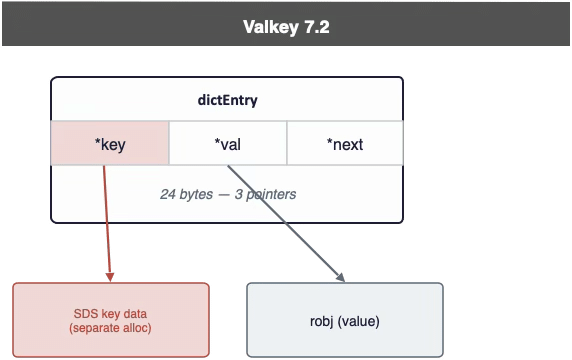
Valkey 7.2至9.1通过三项底层数据结构重构,将字符串密集型场景的每键内存从102.48字节降至64.02字节,减少37.5%。8.0将键内联进dictEntry节省8字节;8.1改用64字节缓存行对齐哈希表,嵌入键值并消除dictEntry,节省20-30字节;9.1将短字符串内联存储,节省最多20%。此外,用Hash存储同一数据比多个String键节省54%内存,但需权衡TTL与集群灵活性。
本文讨论了OLAP查询中Hash Join和Hash Aggregation的执行机制,重点介绍了Trino的内存管理、溢出机制及其对查询性能的影响。Hash Join分为Build和Probe阶段,采用小表广播或分区策略;Hash Aggregation通过Partial和Final阶段进行数据聚合。文章还探讨了内存溢出时的处理策略,并与DuckDB进行了对比实验,强调内存管理在查询优化中的重要性。
InnoDB的Change Buffer和自适应哈希索引(AHI)机制用于优化二级索引的写入性能。Change Buffer缓存非唯一二级索引的延迟写入,合并时机包括读页和后台处理。AHI通过哈希加速B+树查找,但在高并发下可能导致性能下降,因此在MySQL 8.0中默认关闭。调优时需根据具体工作负载进行验证。
BPF程序在内核中执行时无法访问全局变量和调用内核函数,唯一的持久化机制是BPF map。本文分析了BPF map的内核实现,包括hash表和数组的结构、并发模型及适用场景。hash map使用分桶链表和预分配策略,而array map则采用连续内存布局,支持零拷贝。per-CPU变体允许每个CPU独立操作,避免缓存行竞争。理解这些并发模型对优化BPF程序性能至关重要。
文章通过模拟器与源码对比连接算法:Grace哈希代价3(M+N)仅在内存刚够分区时成立,内存充足时Hybrid可降至M+N;哈希并非总快于排序归并,后者遇大量重复键会退化;radix分区收益取决于哈希表与末级缓存差距,实际系统中很少兑现。文章还剖析了PostgreSQL 17与MySQL 8.4在溢出和倾斜处理上的差异。
Kraken团队将Rust从实验性语言转变为核心基础设施,现已拥有数百万行Rust代码,显著提升了系统的性能和稳定性。通过逐步替换PHP,团队实现了高效的技术架构和文化,促进了知识共享与AI辅助开发,增强了金融系统的可靠性。
当 int/long/float/指针/std::string 作为 `std::unordered_map` 的 key 时,C++ 底层是如何计算 hash 值的? gcc/clang 作为使用最多的两种编译器和标准库,它们在这个问题的实现上略有差异。本文将基于二者的源码进行对比分析。 ## std::string 在深入讨论其他类型的 hash 实现之前,我们首先
本文分析了C++中std::unordered_map的键(如int、float、指针和std::string)如何计算哈希值。gcc和clang在实现上存在差异,gcc使用murmurhash,而clang在64位系统下使用cityhash64。对于浮点数和指针,gcc将其视为size_t,clang则使用hash_bytes操作。总结了两者在性能和精度上的不同。
RapidHash 是 wyhash 的 Rust 实现,具备快速、内存安全、跨平台和流式哈希处理的特点。Lilac 提供 GPU 资源管理、任务调度和实时监控功能。rust-analyzer 更新了新特性和修复。
When implementing an optimization for derived clause lookup myself, Amit Langote and David Rowley argued about the initial size of hash table (which would hold the clauses). See some discussions...
Go社区引入了标准化的Hash接口maphash.Hasher[T],有效解决了Hash洪水攻击等安全问题。该接口无状态设计,确保安全性和递归友好性,推动了Go泛型生态的发展。
在PostgreSQL中,HASH分区在数据量不均或高并发场景下比RANGE分区更有效。HASH分区通过哈希函数均匀分配数据,而RANGE分区适合处理时间序列数据,但可能导致数据倾斜和管理复杂。结合使用RANGE和HASH分区可以优化性能和维护。使用pg_partman可以自动管理分区,简化操作。选择合适的分区键和数量是成功的关键。
在SQL数据库中,索引优化查询速度。PostgreSQL等关系数据库提供多种索引类型:B-Tree适合常规查询,Hash用于快速等值查询,GiST处理复杂数据,GIN适合多元素值,BRIN适合大表。选择合适的索引能显著提升查询性能。
在 Reddit 的 r/Python 讨论中,有人提问 hash(-1) 是否等于 hash(-2),引发了对 Python 哈希函数特性及其影响的探讨。
数据库索引用于加速数据搜索,PostgreSQL支持多种索引类型:BTREE适合一般搜索,HASH用于精确匹配,GIST/SPGIST处理复杂数据,BRIN适合大数据集,GIN用于全文和数组搜索。选择索引类型需根据数据和查询需求。
Ruby提供多种访问Hash值的方法。dig方法安全地从嵌套结构中检索值,返回nil而非错误;直接链式访问可能导致错误。fetch方法可提供默认值,而each_with_object适用于复杂的深层搜索。选择合适的方法需考虑安全性、可读性和数据结构复杂性。
Lithe Hash模块使用Bcrypt算法安全地哈希密码,简化了密码的创建、验证和管理。安装后可导入Hash类,使用make方法创建哈希,check方法验证密码,needsRehash方法检查是否需要重新哈希。Bcrypt通过可配置的成本因子增强安全性,并通过异常处理提高代码的健壮性。
Lithe Hash是一个安全的密码哈希模块,基于Bcrypt算法,简化了密码哈希的创建、验证和管理,确保遵循安全最佳实践。通过Composer安装,使用Hash类进行哈希的创建和验证,并支持调整成本参数。Bcrypt设计为计算密集型,以抵御暴力攻击,推荐成本范围为10到12。
Hash-Hammer是一个多线程哈希破解工具,专为教育和安全测试设计。它支持MD5哈希,通过暴力破解和字典攻击评估密码安全性,并提供实时统计以优化CPU使用。使用时需遵循法律,强调密码安全的重要性。
#Jenkins-RCE #KeePass-Crack #Pass-the-Hash #(NTFS)ADS攻击
完成下面两步后,将自动完成登录并继续当前操作。