复盘OntoDB(单LSM引擎支持12种数据模型)中227万化合物指纹HNSW索引召回异常:Recall@50低于Recall@10。排查发现三类根因:多样性剪枝使用严格小于号,在离散Tanimoto距离下大量并列被误剪;删除集合与向量状态未持久化,产生44万“幽灵”节点;导入分页断流、抽样偏差、列清单缺fp、版本选择bug叠加导致指纹丢失。修复后id-recall@10由0.844升至0.9784,节点数与SQL精确对齐。
复盘OntoDB(Rust多模数据库)227万化合物指纹HNSW索引召回异常:Recall@50低于@10。排查发现三类根因:多样性剪枝使用严格小于号,离散Tanimoto距离大量并列导致新节点被误剪;删除集合等内存状态未持久化,产生44万“幽灵”节点;导入分页断流、抽样偏差、列清单缺fp、版本选择bug叠加导致指纹丢失。修复后id-recall@10由0.844升至0.9784,节点数与SQL精确对齐。
Pinterest Engineering has enhanced its Manas search platform to manage vast data, improving efficiency in search and discovery functions. By applying Scalar and Product Quantization, memory usage...
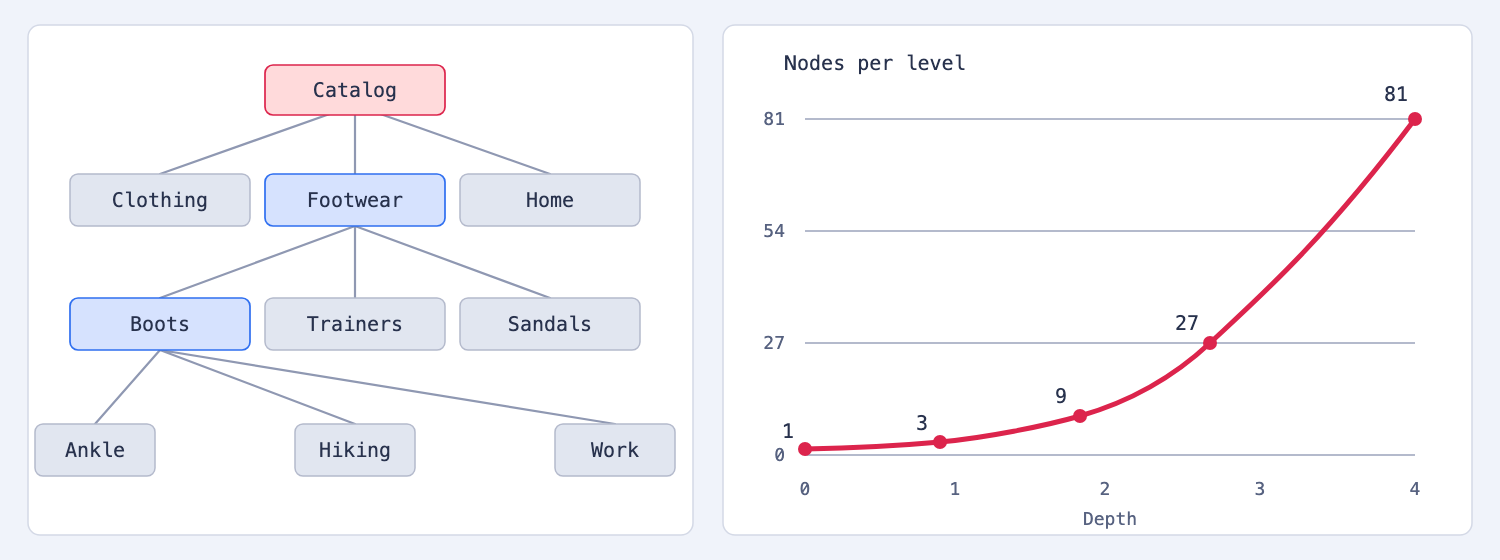
本文介绍双曲嵌入在Qdrant中的应用。双曲空间适合表示层级数据,比欧氏空间更高效:5维Poincaré嵌入在商品分类上达到0.905 MAP,优于50维欧氏嵌入的0.658。但直接使用HNSW索引会导致召回率下降,需先用HNSW预取候选,再通过Formula Query按真实双曲距离重排,召回率从0.266提升至0.920。
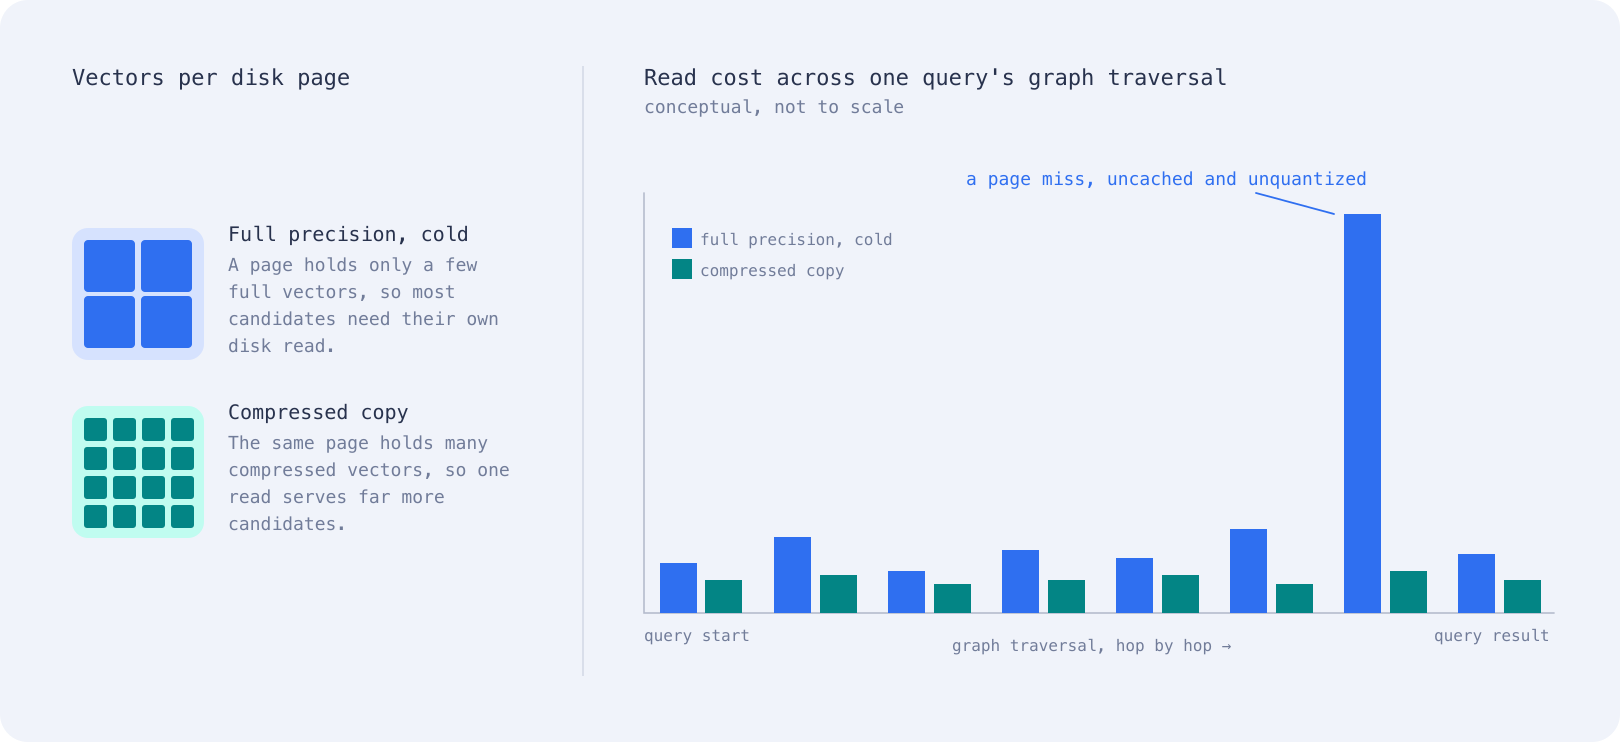
Qdrant支持将向量、HNSW图、量化向量等分配到不同内存层级(固定、缓存、冷存储),以平衡速度与成本。建议在RAM紧张时固定量化向量,冷存储时配合量化减少磁盘读取,避免缓存全精度与压缩副本共存。HNSW内联存储需测试,并随扩展持续检查RAM余量。
Qdrant 通过固定、缓存、冷存储三层管理内存,并结合量化压缩向量。小集合可全部缓存;内存瓶颈时固定量化向量副本以兼顾速度与低占用;磁盘受限时先量化再转冷存储。避免同时缓存全精度与压缩副本,谨慎使用 HNSW 内联存储。
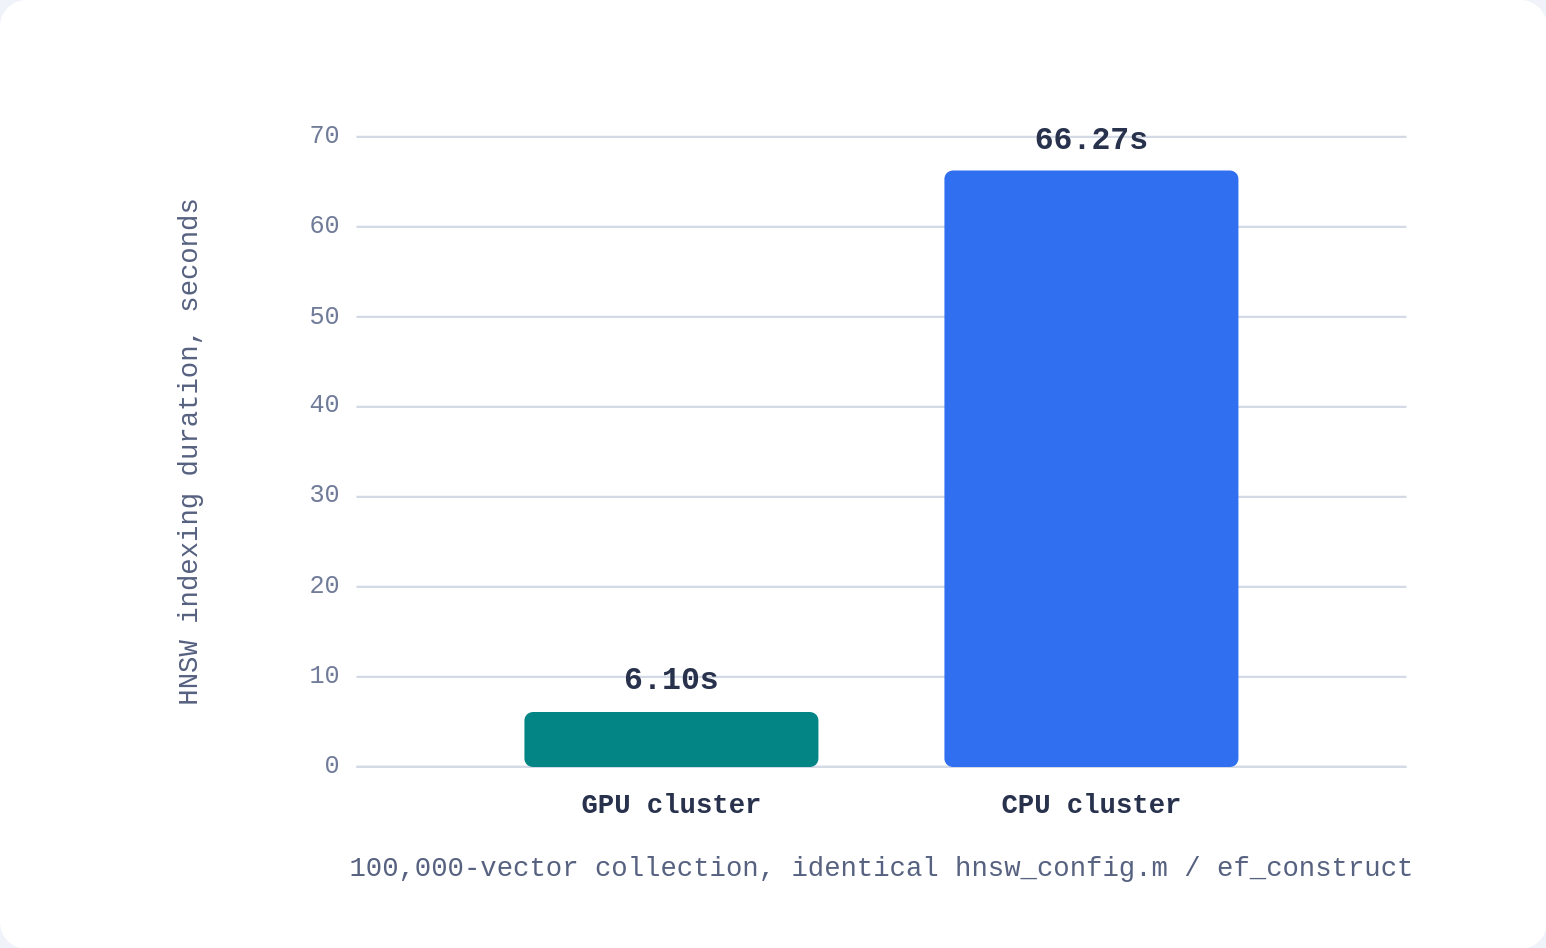
Qdrant 自 v1.13 起支持 GPU 加速 HNSW 索引,可显著缩短向量集合重建索引时间。以 10 万条向量对比:GPU 建索引约 6.1 秒,CPU 约 66.3 秒,约快 10 倍;查询吞吐相近,但 CPU 因索引与查询争抢资源,延迟峰值更高。GPU 适合频繁重建索引或常换嵌入模型的场景,否则闲置 GPU 成本不划算。
本文介绍向量嵌入如何将文本转化为高维空间中的点,使语义相近的内容距离更近,从而解决关键词搜索的语义匹配问题。文章回顾了从word2vec、GloVe到BERT等模型的发展,强调上下文建模和池化技术的重要性,并指出向量搜索需结合高效索引(如HNSW)和实时数据平台(如Redis)以支持生产应用。
Qdrant在向量搜索中采用过滤内置于搜索的方式,而非预过滤或后过滤。预过滤成本高,后过滤可能返回不足。Qdrant通过HNSW图遍历时检查过滤条件,并用Filterable HNSW和ACORN修复严格过滤导致的路径断裂。查询规划器按过滤匹配度选择路径,如过滤索引或全扫描,确保高效准确。
本文介绍近似最近邻搜索(ANN)在向量检索中的应用,涵盖暴力搜索、KD-Tree、LSH、HNSW及量化方法,并讨论FAISS索引选型、向量数据库架构及RAG场景实践。强调高维向量检索需平衡精度与速度,常用HNSW或IVF-PQ索引,并注意基准测试陷阱,以Recall@K评估质量。
本文介绍Postgres与pgvector实现混合搜索(向量相似度+标量过滤)的模式。核心问题是向量索引返回近似排序结果,无法直接与WHERE过滤结合。pgvector 0.8提供迭代索引扫描,但需权衡召回率与性能。其他方案包括:部分HNSW索引(适合低基数稳定过滤)、过采样后过滤(适合高基数)、缓存响应(适合重复查询)。文章还提供EXPLAIN诊断方法和选择指南。
pgvector v0.8.0将HNSW索引作为PostgreSQL索引访问方法实现,向量以varlena存储于8KB页中,与业务表共享WAL、缓冲区和VACUUM。相比Milvus,它支持同进程事务和SQL,但受限于页装箱、默认后过滤和资源争用。选型应基于隔离需求与生命周期管理,而非单纯比较ANN算法性能。
本文讨论了向量检索引擎Knowhere的架构与索引类型,包括HNSW、DiskANN和IVF-PQ等算法的应用。强调了在训练、构建、加载和查询四个阶段的参数管理,指出Flat索引是金标准但不应作为默认选择。文章还探讨了索引生命周期与段的关系,以及插件契约的实现步骤,提出了多索引参数组合的开放问题。
本文讨论了向量检索引擎Milvus的架构与功能,重点介绍了HNSW、DiskANN、IVF-PQ等算法的应用,以及向量库的选型与RAG召回机制。内容涵盖写路径、读路径和索引内核,适合RAG和AI平台工程师、数据平台工程师等专业人士阅读。
Elasticsearch使用HNSW算法在每秒15,000个查询下实现0.99的召回率@10。通过量化技术,DiskBBQ在55,000 QPS下达到0.97的召回率,内存占用减少8倍。HNSW通过多层图结构提高查询效率,适合高维数据的近似最近邻搜索。量化方法如标量量化和产品量化进一步压缩内存,提升性能。
HNSW是主流向量数据库默认的近似最近邻索引算法,通过分层图结构实现高效搜索。文章从NSW图出发,详细推导HNSW设计,给出C语言实现,讨论参数调优、距离计算优化,并对比Vamana等竞品。HNSW在精度、速度、内存间取得平衡,搜索复杂度为O(log N),但内存消耗大,动态更新和过滤搜索仍是挑战。
本文讨论了Postgres中的向量搜索及其索引设计,强调在不同工作负载下选择合适索引的重要性。介绍了HNSW、IVFFlat和DiskANN等算法,并分析了它们在内存、召回率和写入成本等方面的权衡。建议根据实际数据和查询模式进行基准测试,以优化检索质量和性能。
pgvector 0.8.2 fixes CVE-2026-3172, a heap buffer overflow in parallel HNSW index builds that can leak data or crash the server.
本文探讨了RAG(检索增强生成)中的存储与检索层,重点介绍向量索引算法的选择和量化方法,以及2024-2026年工业界的趋势。文章分为四部分:算法底层、产品选型、工程实操和图RAG与趋势,提供实用的参数和代码示例。向量检索主要使用近似最近邻(ANN)算法,推荐HNSW作为工业标准,并结合量化技术以降低内存占用。最后,GraphRAG结合知识图谱与向量检索,提升多跳推理能力。
本文介绍了MyVector插件的实现,包括向量搜索模式设计、嵌入工作流、混合搜索及性能权衡,重点在于嵌入的存储与索引、工作流设计,以及HNSW与暴力搜索的比较。MyVector支持SQL过滤,确保搜索的相关性与安全性,适用于多租户应用。
完成下面两步后,将自动完成登录并继续当前操作。