By Oleksii Tkachuk, Rajiv Shringi, Chris Lohfink, Abe Ratnofsky, Kartik SathyanarayananIntroductionIn an earlier post, we introduced the TimeSeries Abstraction, our high-throughput, low-latency...
本文对比三种 Kafka 入仓 Redshift 方案:一、MSK 托管配 IAM 认证与流式摄取物化视图,秒级时延、免运维,推荐首选;二、EC2 自建 Kafka 走 TLS 直摄,成本低但需自运维;三、经 S3 Tables 落地 Iceberg 再外部表查询,存算分离、多引擎共享,时延分钟级。文中给出部署步骤、成本与性能要点,并说明中国区适用性。
The article describes a custom implementation that provides a session-level ordering on top of Apache Kafka partitions, supporting strict message ordering across 1000s of independent channels. The...
文章介绍Kafka生产端实践:先概述架构与存储原理,分区为文件夹,由稀疏索引与日志文件组成。重点讲两个问题:一是加代理后因元数据返回真实broker地址,导致约1/3消息发送失败,需代理用多IP或改服务端配置;二是切换SASL+SSL加密集群时采用灰度方案,先测测试topic,再双写观察,最后切换,并需压测评估性能下降。
文章讨论Kafka消费端防止消息丢失。原方案用Zookeeper选主、单分片消费,offset存数据库,但选主慢,且两台服务器同时宕机重启时,offset可能因Kafka日志10分钟清理而过期,导致消费失败和数据丢失。改进方案改用consumer.assign指定分片,配合带过期时间的分布式锁和手动提交offset,异步处理后再提交,实现快速故障接管,并建议调大日志保留时间。
本文图解Kafka架构原理:Producer发送消息,Consumer按组消费;Broker为服务节点,Topic按业务划分并可细分为Partition,消息以offset标识且仅保证分区内有序。Replication副本保障高可用,主副本负责读写、从副本同步。Zookeeper存储元数据,负责Controller选举、集群与分区副本管理。Controller由Broker竞选产生,管理分区Leader选举、上下线及状态机。网络采用NIO的Reactor多线程模型。
Atlassian团队用Kafka、Flink和OpenTelemetry重建自动事件检测平台AutoHOT,将事件到指标延迟从40秒降至10秒内,月成本从2万美元降至650美元。检测召回率从60%升至86%后回落至64%,精确率仍不理想。关键教训:召回率反映检测器质量,覆盖率取决于埋点选择,二者不可混淆;客户端遥测无法发现数据库宕机等沉默故障。
IBM Confluent从实时数据流平台演进为面向AI的实时上下文与行动底座,提供感知、供数与行动三层能力,支持异常检测、个性化推荐和IT运维等场景。收购后,结合Kafka和Flink,帮助企业从被动分析转向主动实时行动,让AI融入业务过程。
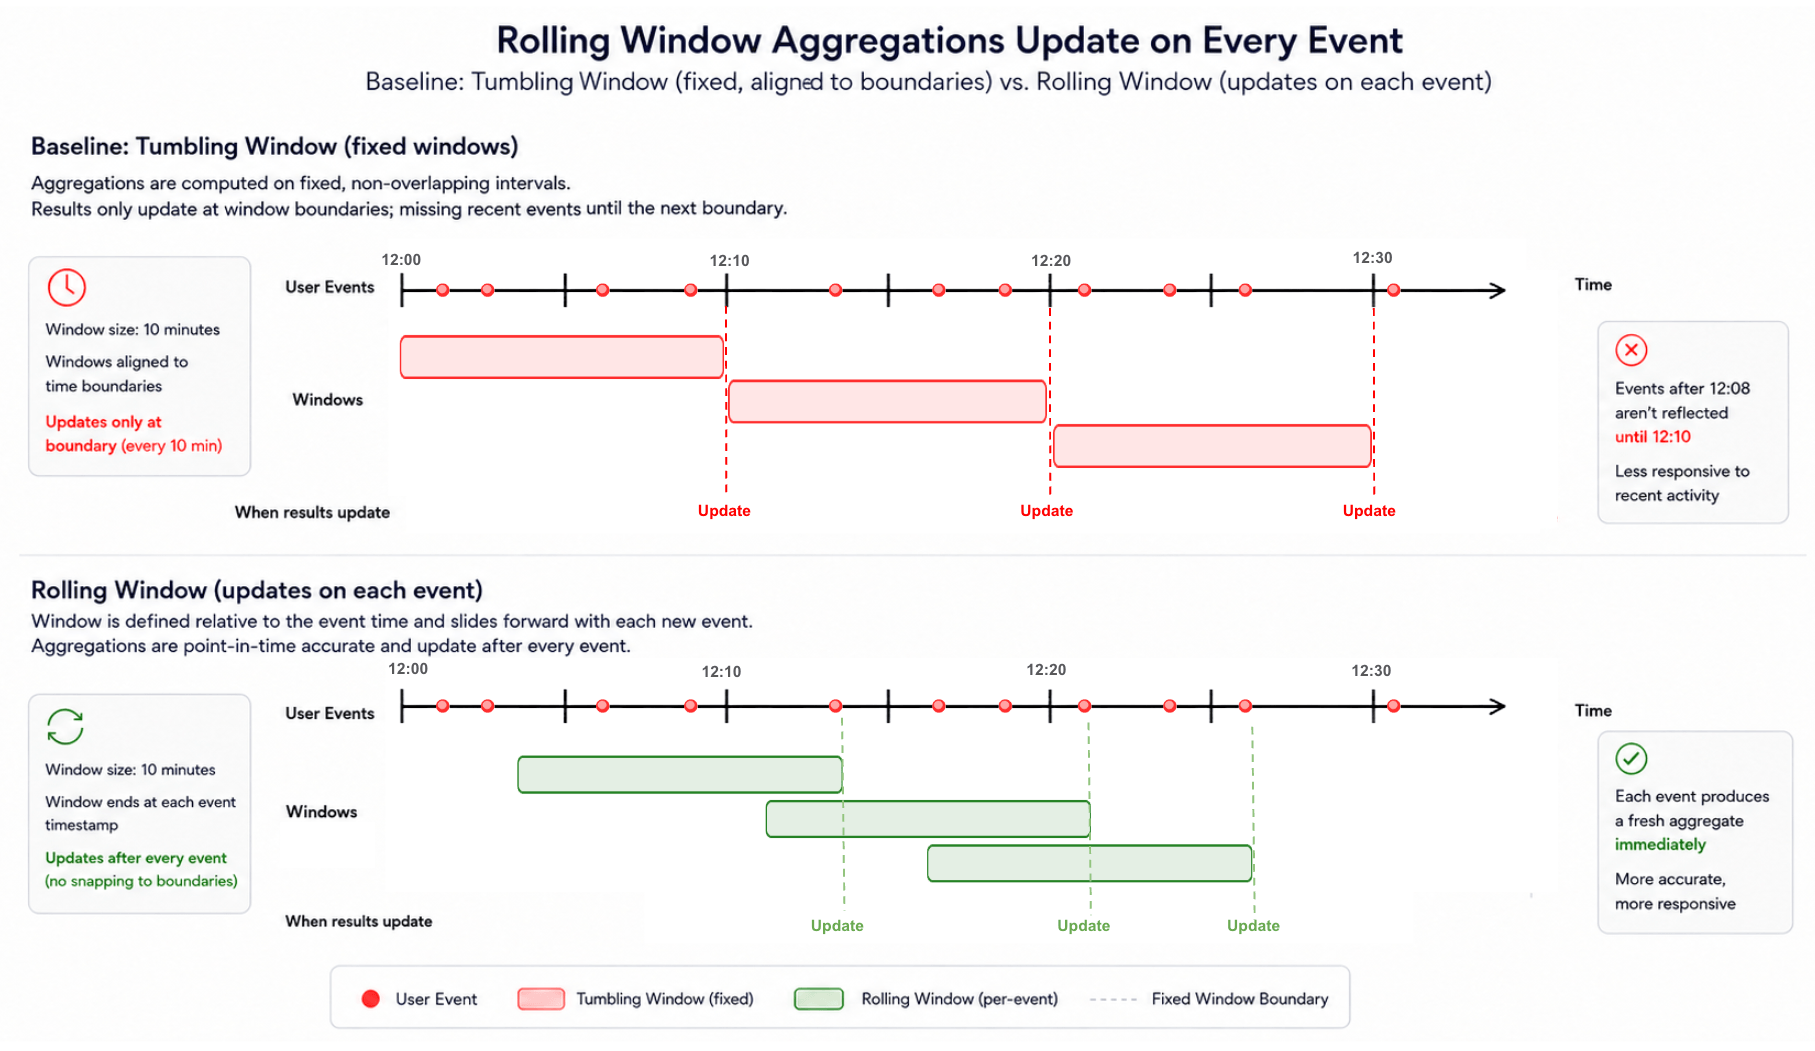
Databricks Feature Store通过Spark RTM、Lakebase和Model Serving实现亚秒级特征新鲜度,端到端延迟200毫秒。它支持滚动窗口聚合,实时处理Kafka事件,减少WAL放大,并自动检索特征供模型推理。该平台简化基础设施,提供治理和血缘追踪,适用于欺诈检测等实时ML场景。
Pigsty v4.5发布,扩展增至575个,新增pg_lake、pg_jieba等。MINIO模块换为自研Silo分支,REDIS新增Valkey引擎,并推出Kafka与MySQL试点模块。同时加固编排安全、升级监控与仓库工具,为5.0铺路。
本文介绍Debezium PostgreSQL连接器的关键配置:通过设置REPLICA IDENTITY FULL获取更新/删除前的数据;使用table.include/exclude.list过滤表;用publication.autocreate.mode控制发布模式;通过ByLogicalTableRouter将多表事件路由到单一Kafka主题;并提及快照模式、墓碑记录及生产配置示例,以优化CDC事件捕获。
Debezium 是分布式 CDC 平台,通过追踪 PostgreSQL 的 WAL 日志,将行变更实时发布到 Kafka。本文介绍如何用 Docker 搭建 PostgreSQL、Kafka 和 Kafka Connect 环境,注册 Debezium 连接器,并演示初始快照和实时增删改事件。事件包含 before、after、source 和 op 字段,主键作为消息键保证顺序。Debezium 读取 WAL 而非表,对应用查询无影响,仅增加 WAL 保留开销。
文章探讨了在Kafka异步系统中测试消费者变更的挑战,并提出一种解决方案:通过路由键(如k7)标记测试消息,在生产者端将键写入消息头,消费者根据键过滤处理。测试消费者使用独立消费组,避免干扰稳定版本,并通过映射服务管理键状态。该方法支持并行测试,无需复制整个基础设施,仅需部署变更服务,适用于大多数场景,但严格排序或合规隔离时仍需复制环境。
RobustMQ Kafka 是基于 RobustMQ 内核的 Kafka 协议兼容层,允许标准 Kafka 客户端直接连接。其设计理念为“一份数据、多协议视图”,实现了 Kafka 与 MQTT 共享同一存储和元数据。系统通过 Raft Leader 进行协调,不使用 ZooKeeper,存储引擎采用文件段方式,支持高效读写。
本文讨论了使用Kafka 3.x(KRaft)和Flink 1.20+进行流处理实验的复现步骤,包括环境设置、事件时间与处理时间窗口、Kafka日志解读、事务处理和检查点间隔等内容。实验结果将记录在output/目录中,以确保实验的准确性。
本文讨论流式数据处理的规划,重点在于Kafka与Flink的结合。内容涵盖流处理基础、Kafka内核、Flink运行时、状态管理及交付语义,旨在解决实时数据链路中的关键问题,如事件时间、窗口处理、状态管理及故障模式。目标读者为数据平台工程师,帮助他们理解流式计算与批处理的差异,以及如何有效运维Kafka和Flink管道。
本文讨论了Flink中EmbeddedRocksDBStateBackend的机制,重点在于KeyGroup前缀、增量checkpoint的实现及其与RocksDB的关系。增量checkpoint依赖于不可变SST文件和MANIFEST,以确保数据一致性。文章还比较了Flink、TiKV和Kafka Streams在状态管理和容错机制上的差异,强调了设计与参数调优的重要性。
本文探讨了流式数据处理中的交付语义,重点分析了Flink的checkpoint机制与Kafka的offset管理。建立了三层模型:Source、引擎和Sink,讨论了at-most-once、at-least-once和exactly-once的定义及修复手段。强调端到端语义由最弱环决定,指出即使使用exactly-once,Sink仍需支持2PC或幂等操作,以避免重复写入。
本文探讨流式数据处理的核心概念,包括流处理、批处理和微批的区别,以及如何通过Kafka和Flink实现有状态计算。强调流处理在无界输入和乱序情况下的容错机制,比较流表对偶与Lambda/Kappa架构,指出流处理的关键在于定义输出时机、状态存储和容错策略。
本文探讨流式数据处理中的关键问题,包括事件时间、窗口、Kafka与Flink的状态管理、checkpoint机制及其在乱序事件中的应用,重点分析如何实现端到端的exactly-once语义,以及背压和数据倾斜等故障的诊断与处理。
完成下面两步后,将自动完成登录并继续当前操作。