Kubernetes 已弃用 cgroup v1:v1.35 起 kubelet 默认拒绝在 cgroup v1 节点启动,v1.38 将彻底移除支持。cgroup v2 提供统一层级和更强隔离,支持内存 QoS 分层保护、OOM 整组终止及原地 Pod 扩缩容。建议尽快将所有 Linux 节点迁移至 cgroup v2,并配置 systemd cgroup 驱动。
Kubelet 仅在 inode 剩余 5% 时触发硬驱逐,而镜像 GC 只关注字节使用率(85%),导致小文件多的镜像耗尽 inode 却不触发清理。案例中 containerd 快照重复解包 node_modules,占用数百万 inode。修复方案:采用多阶段构建精简镜像,并增加 inode 使用率 80% 的告警。
The Cloud Native Computing Foundation (CNCF) announced the release of Kubernetes 1.37, named "Garhwal", emphasizing its focus on stability, security, and AI/ML workload optimization. By Mostafa Radwan
Kubernetes v1.37 将 Pod 级资源管理器升级为 Beta(默认禁用)。该功能使 Kubelet 的拓扑、CPU 和内存管理器直接依据 Pod 级资源声明进行硬件放置,支持混合分配:为主容器保留独占 NUMA 对齐资源,同时将非 Guaranteed 边车容器放入 Pod 隔离共享池,避免为辅助容器浪费物理核心。
本文介绍了如何部署 Events Etcd 集群,建议使用 3 个节点,采用 SSD 磁盘,数据目录与主 Etcd 分开。通过静态 Pod 部署,kubelet 管理 Etcd 进程。配置环境变量后,创建静态 Pod 并验证集群状态,包括检查 Pod 状态和 Etcd 成员列表。最后,修改 kube-apiserver 配置以适应新的 Etcd 集群。
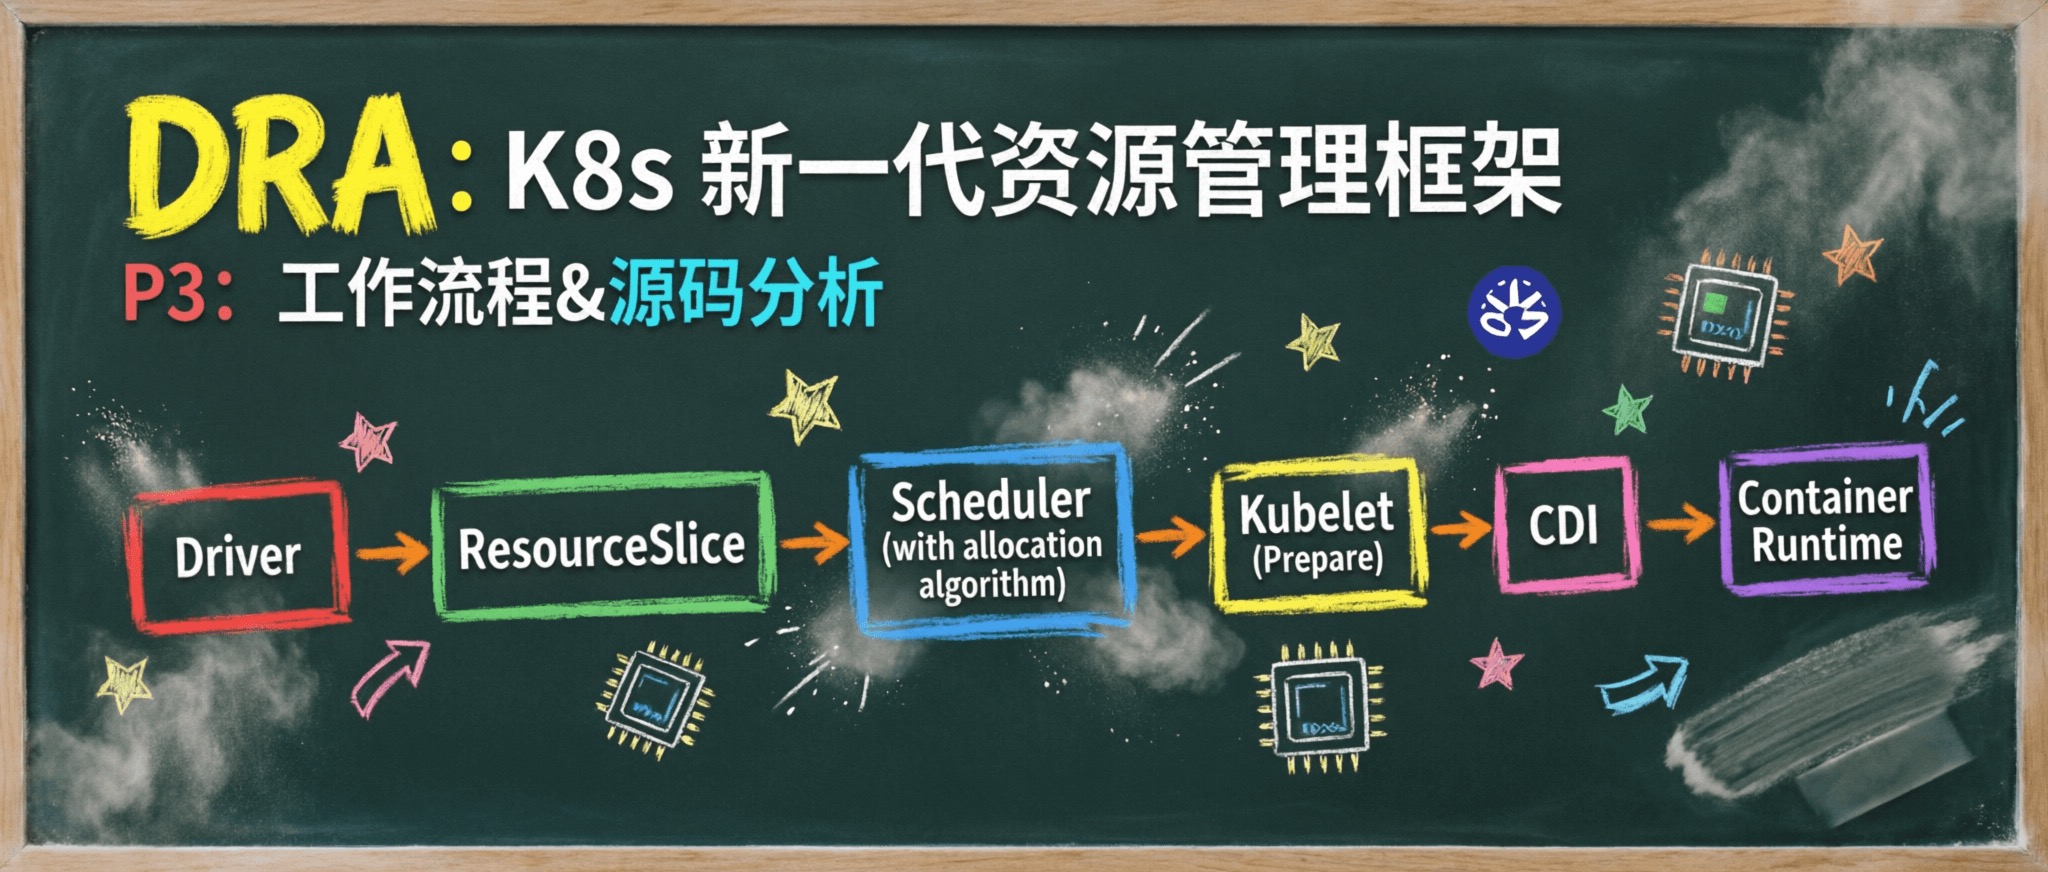
DRA工作流程包括六个阶段:设备注册、分类定义、用户需求声明、调度器分配、设备准备与注入、Pod运行与清理。DRA Driver通过NVML扫描GPU并注册到Kubelet,用户创建Pod和ResourceClaim,调度器选择并分配设备。Kubelet负责准备设备并注入到容器,Pod终止后进行清理。DRA简化了设备管理流程,调度器负责分配决策。
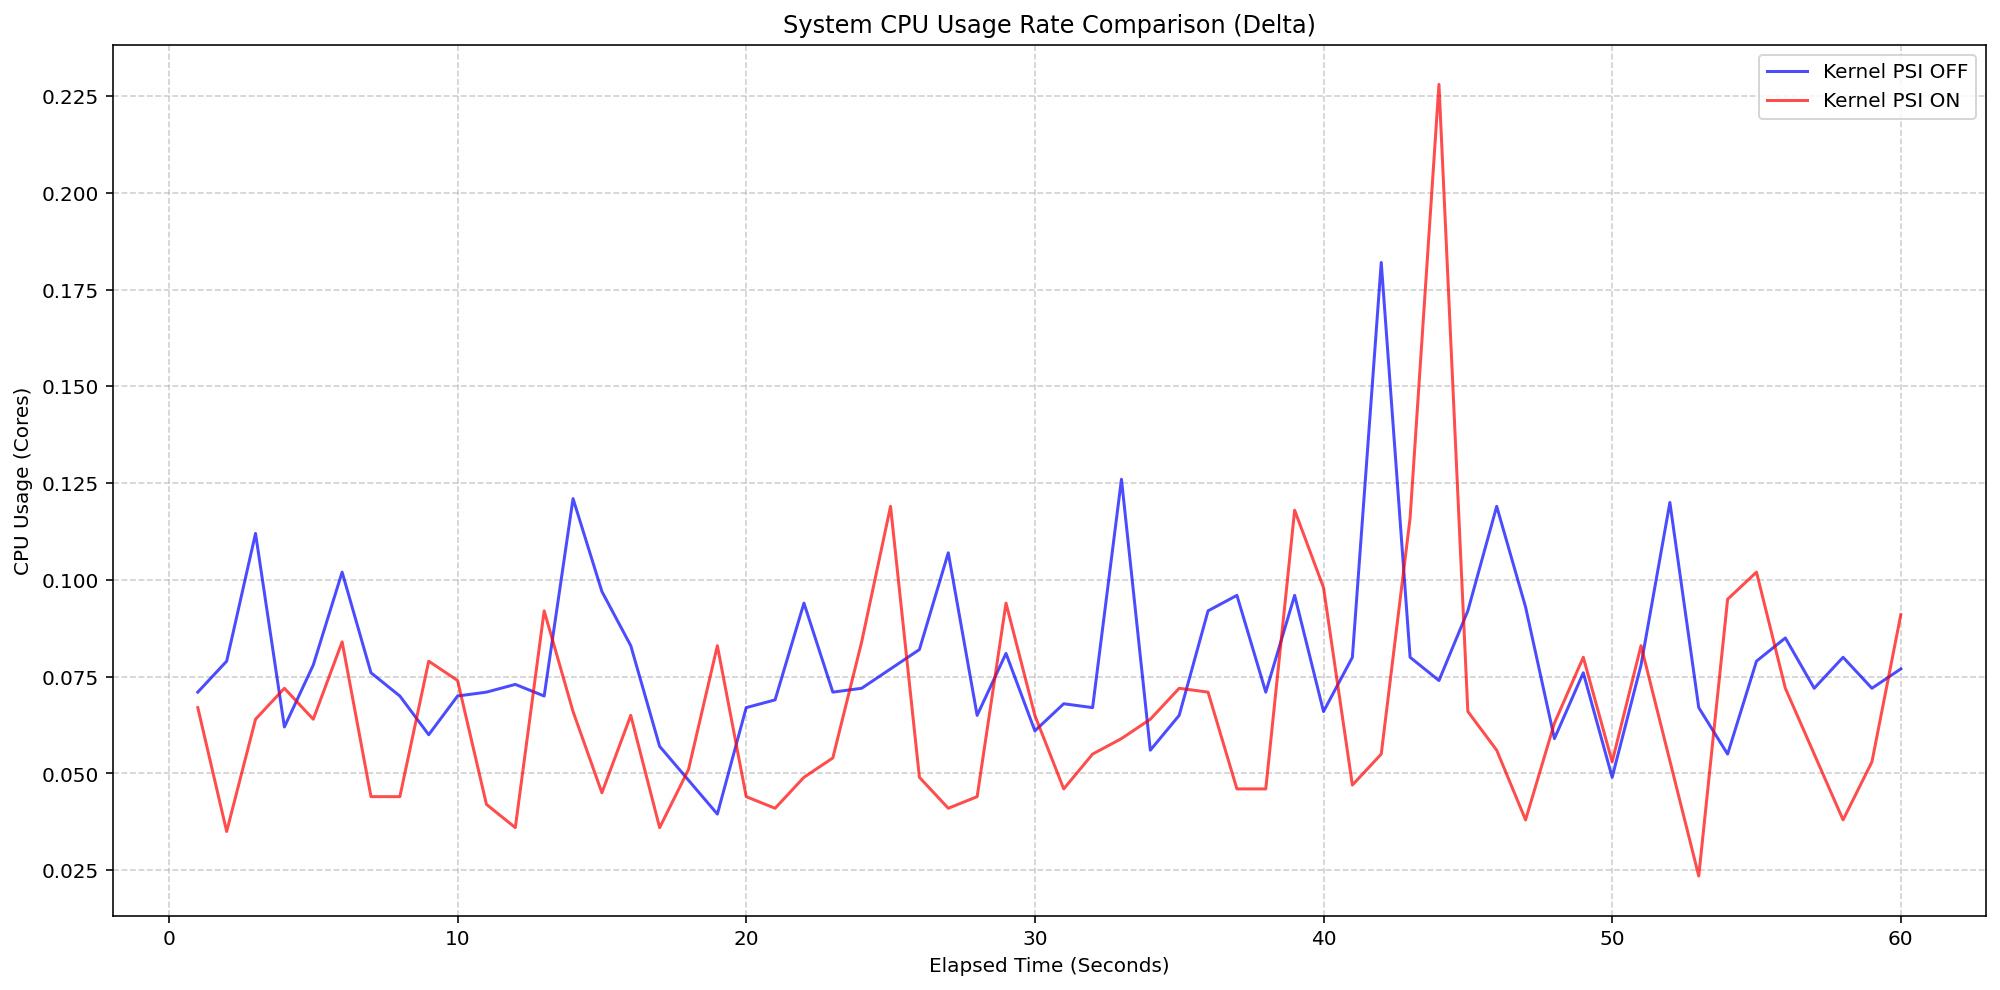
自2018年在Linux内核中实施以来,压力停滞信息(PSI)帮助用户在资源饱和前识别问题。Kubernetes v1.36发布后,用户可以在节点、Pod和容器级别观察资源竞争。测试表明,Kubelet的PSI功能对资源使用影响微小,适合生产环境。PSI指标可通过Prometheus监控,需满足特定内核配置。
Kubernetes v1.36正式推出细粒度kubelet API授权功能,增强了对kubelet HTTPS API的访问控制,替代了过于宽泛的节点/代理权限。此功能通过细化权限,降低了监控工具等工作负载执行任意命令的能力,从而提升了安全性。
Kubernetes存在一个漏洞,允许具有读取权限的用户通过特定服务账户访问Kubelet,执行任意命令。安全研究员Graham Helton建议审查RBAC策略并实施网络政策以防止攻击。
Kubernetes v1.35引入了kubelet配置的drop-in目录,简化了大规模集群的配置管理,支持不同节点组的定制配置,解决了配置漂移和管理复杂性,提高了集群管理员的效率。
Kubernetes v1.34引入了自动配置节点cgroup驱动的功能,简化了新集群中cgroup驱动的配置。kubelet能够自动询问CRI实现所用的驱动,要求CRI实现版本较新。
Kubernetes v1.33中,镜像卷功能从Alpha升级为Beta,支持subPath和subPathExpr挂载。尽管默认禁用,CRI-O和containerd已开始支持此功能。新增的kubelet指标可监控镜像卷的请求和挂载情况。
在设置EKS节点组时,遇到“NodeCreationFailure”错误,Kubelet无法启动。通过连接BottleRocket Linux EC2实例并查看日志,发现使用了不允许的标签。移除这些标签后,Kubelet成功启动。
在Kubernetes中,静态Pod由kubelet直接从'/etc/kubernetes/manifests/'中的YAML文件启动,不通过API服务器和调度器。它们绑定到特定节点,并在API服务器中显示为镜像Pod,删除时需移除YAML文件。静态Pod在启动时没有网络,需等待CNI插件激活后才能获得IP。
在 Kubernetes 中,无法查看 Pod 日志和执行命令可能是由于 Kubelet 健康状态或 Metrics Server 问题。解决方法包括添加 node-ip、删除有问题的 Metrics Server 或降级其版本。
六个月前,我作为DevSecOps工程师入职,学习Kubernetes并搭建了三节点集群,掌握了集群配置和管理,包括Containerd和kubelet的安装,深入理解了Kubernetes的工作原理。
本文介绍了如何利用Kubernetes的Kubelet组件进行信息收集和权限提升。通过masscan和nmap工具扫描特定IP的开放端口,并使用kubectl命令在容器内执行操作,以获取敏感信息和提升权限。
Kubernetes节点NotReady状态可能由资源不足、kubelet故障、网络问题或控制平面连接问题引起。调试时应检查节点状态、kubelet日志和网络连接。可使用kubectl命令进行节点标记、驱逐和更新。
更新etcd.yaml文件是为了确保etcd恢复后kubelet能正确管理静态pod。若不更新hostPath,可能导致pod使用旧路径,造成数据不一致。恢复后需修改manifest中的hostPath,并验证etcd的状态和健康。
本文讨论了Kubernetes中节点状态为NotReady的故障排除方法,包括检查kubelet、CNI插件、etcd状态和容器运行时。通过重启kubelet服务,节点恢复正常。此外,文章还提到视频应用的部署问题,最终通过修正命令错误使其成功运行。
完成下面两步后,将自动完成登录并继续当前操作。