文章比较了LangChain、LlamaIndex与从零自建三种LLM应用开发路径。LangChain覆盖广、集成多,适合快速原型和多工具智能体,但抽象层深、版本变动快,调试困难;LlamaIndex专注检索增强生成,索引与评估工具完善,适合文档问答,但不擅长复杂智能体;自建直接调用模型API,控制力强、易调试,适合需求明确、工程能力强的团队,但前期投入大。选择应依据项目阶段、团队经验和应用类型,可先原型后重构。
DXC Technology与LangChain合作,在企业关键任务IT环境中应用具备治理机制的智能体AI。DXC已在智能编排平台OASIS中采用LangGraph,并以许可方式使用LangSmith,支持智能体的开发、评估与可观测性。
LangChain 是一个集成多种功能的工具,旨在简化 AI 应用程序的开发,涉及模型、提示和解析器等概念,通过 OpenAI 接口实现方言到正式表达的转换。
TypeSafe AI 推出决策小模型 Jev,专用于选择题、打分和是非判断,每百万输入 token 仅 0.042 美元,输出免费,比大模型快 200 倍、便宜 400 倍。文章介绍其三种题型与十步集成方法,并展示浏览器操作、邮件分类、安全护栏、模型路由、上下文压缩五大场景,指出智能体约八成调用实为选择题,应交给 Jev 处理。
TypeSafe AI 推出 Jev“系统一”模型,专注结构化决策,不生成文本,通过 RLCD 训练提升概率输出准确性。在分类任务中,其推理速度比传统方法快 20 至 200 倍,成本低 40 至 400 倍。LangChain 已官方集成,可用于模型路由和工具调用风险拦截。早期用户反馈高频决策场景成本大幅降低。Jev 不取代大模型,而是分层协作,但效果仍需第三方验证。
该文介绍了一个多智能体交易研究系统,使用LangChain Deep Agents和EODHD数据,通过确定性评估层控制策略开发。系统包含协调员、策略工程师和研究评论员三个角色,执行三个版本策略,并应用固定选择规则。最终v1成为冠军,在保留数据集上表现优于基准,但审计发现评论员误解策略等弱点,强调控制证据评估的重要性。
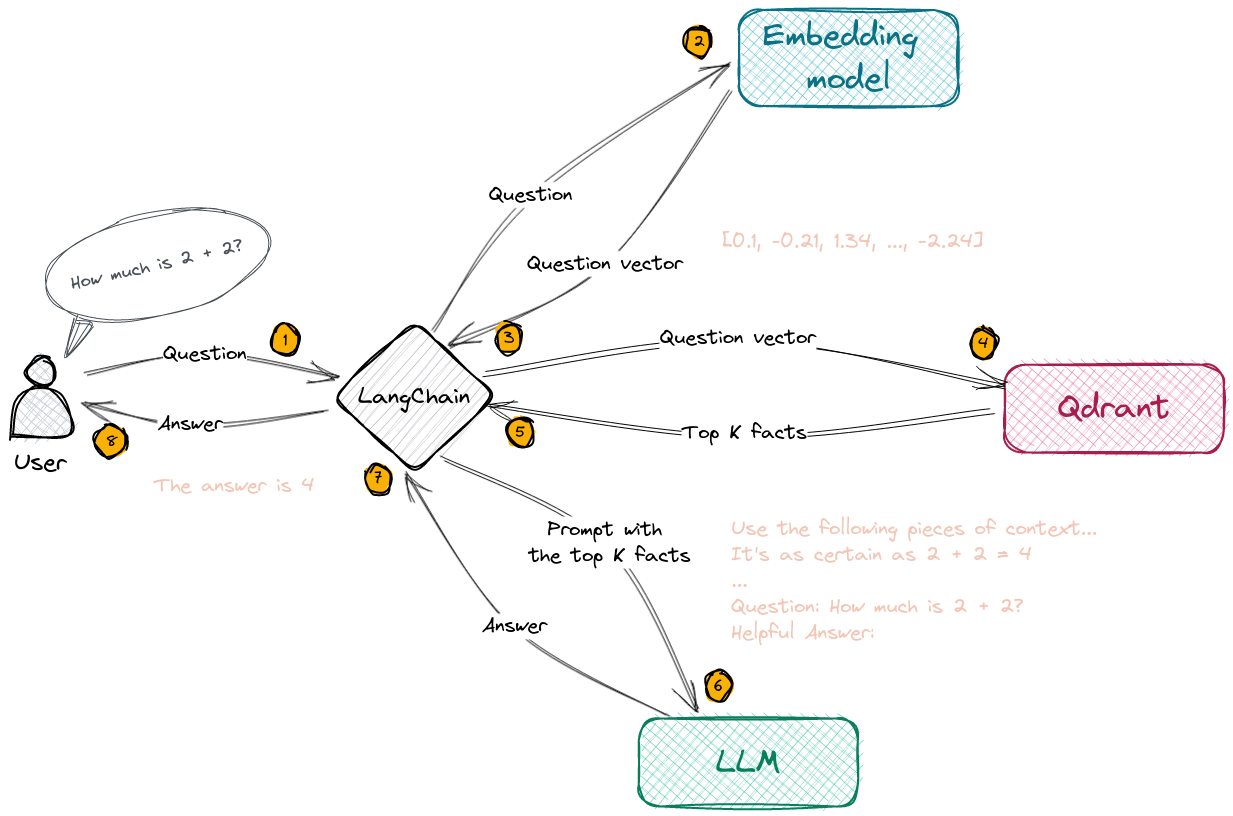
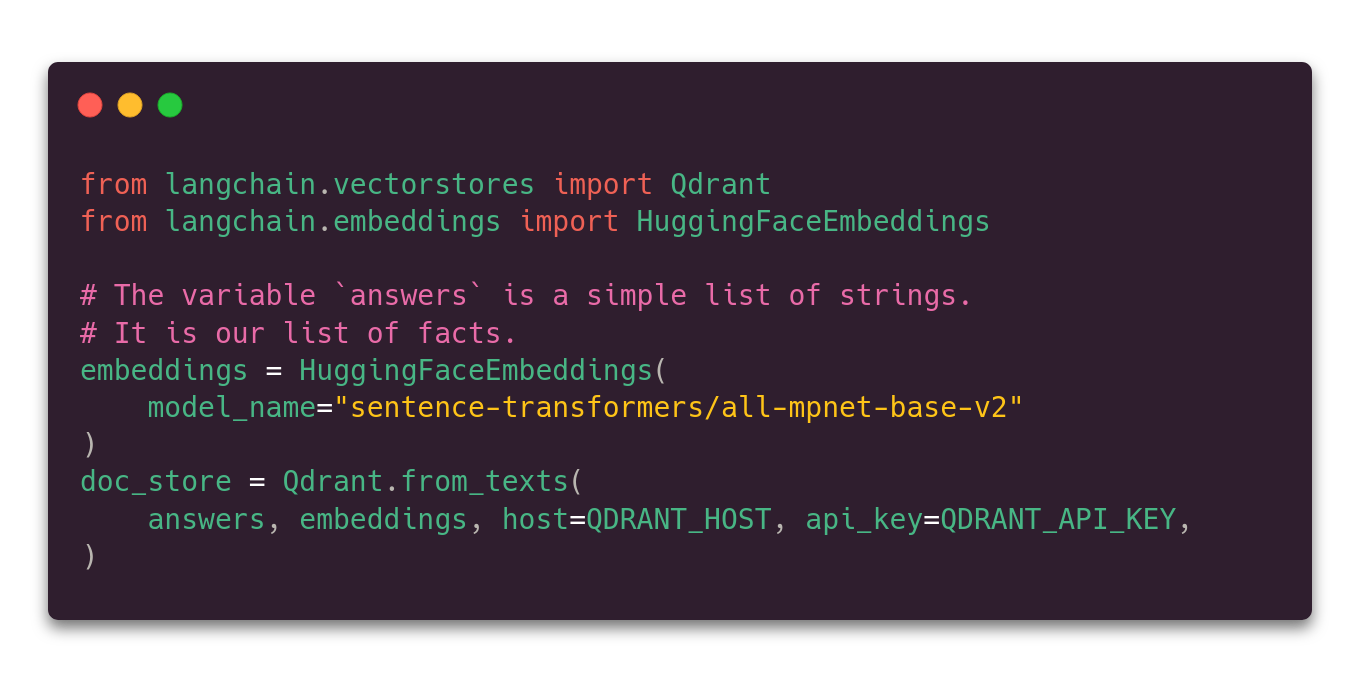
本文介绍用LangChain和Qdrant构建问答系统。针对大模型缺乏事实依据的问题,采用向量检索增强生成:先用FastEmbed将知识库文本向量化存入Qdrant,查询时检索最相关文档,与问题组成提示词交给Claude或GPT生成答案。以Natural Questions数据集为例,演示配置、建库、LCEL组合检索链及测试的完整流程。
本文介绍了如何使用LangChain和Qdrant构建问答应用。通过将事实转化为向量并存储在Qdrant中,系统能够进行语义搜索并提取相关文档。使用两个模型,一个用于特征提取,另一个用于文本生成。配置知识库后,用户可以通过简单代码实现问答功能,LangChain会自动处理大部分流程。
本文比较了三种大型语言模型(LLM)框架:LangChain、LlamaIndex和原始API调用。LangChain适合复杂应用的多步骤操作,LlamaIndex专注于高效的数据检索,而原始API调用则提供最低延迟和最高透明度。选择合适的框架应根据项目需求,简单任务使用原始API,文档检索使用LlamaIndex,状态管理和多步骤推理适合LangChain。建议根据实际需求逐步引入框架。
NVIDIA Nemotron 3 Ultra通过优化LangChain深度代理,实现领先性能和更低成本,帮助企业完成更多任务。该系统无需重新训练模型,企业可定制和控制AI代理,从而提升工作效率。NemoClaw为企业提供开放的AI构建蓝图,支持在多种平台上运行,助力构建专属代理。
本文介绍LangChain学习第十篇,将本地博客问答封装为CLI工具。通过argparse实现search和ask两个子命令:search仅检索文章,ask检索后调用模型回答。CLI便于调试,验证RAG、Agent等核心链路。第一阶段已完成LLM调用、PromptTemplate、工具调用、RAG、记忆等基础实践,后续可扩展向量数据库、Web服务等。
本文介绍LangChain多轮RAG问答实现。通过MessagesPlaceholder将历史对话插入Prompt,每轮仍检索当前问题上下文,结合历史消息生成回答。用内存list保存HumanMessage和AIMessage,支持追问。限制是程序结束历史丢失、长对话占用上下文,无摘要压缩。核心公式:多轮对话=历史消息+当前问题+当前检索上下文。
本文介绍如何将Agent与RAG结合,构建博客问答Agent。它提供三个工具:检索文章、列出分类、读取来源,让Agent自主决定调用工具获取信息。通过工具抽象,Agent无需关心内部实现,并强调工具边界安全。最终,Agent负责决策,RAG工具查资料,LLM总结回答,实现更灵活的问答系统。
本文介绍RAG检索质量调优,重点实验三个参数:分类过滤(category)限定检索范围,top_k控制返回片段数量,chunk_size和chunk_overlap影响文档切分。通过标题加权和来源去重提升相关性,并输出调试信息帮助排查。建议先检查检索结果、chunk完整性,再调整top_k和prompt,而非直接归咎模型。
本文介绍LangChain第六篇,将RAG流程拆为构建索引和问答两阶段。构建索引时读取文章、切分、生成向量,保存为JSON文件;问答时加载索引,用余弦相似度检索并调用模型回答。该实现适合教学,但非生产级,真实项目需用向量数据库。
本文是LangChain系列第五篇教程,介绍使用教学版HashEmbeddings实现向量检索RAG。流程包括切分Markdown文档、生成向量、存入InMemoryVectorStore,并通过Retriever检索后交给模型回答。HashEmbeddings虽非语义模型,但演示了Embeddings、VectorStore和Retriever接口的使用。真实项目中可替换为OpenAIEmbeddings。下一篇将解决索引持久化问题。
本文介绍了一个基于本地Markdown文件的最小RAG(检索增强生成)问答系统实现。系统通过读取Hugo博客文章、去除front matter、切分文本,利用关键词检索相关片段,并组装Prompt让模型基于上下文回答。代码结构包括配置、模型、文档加载和检索问答模块。该方法不依赖向量数据库,逻辑透明,适合理解RAG基本流程,但存在关键词匹配敏感、无索引持久化等限制,后续将逐步优化。
本文介绍LangChain工具调用与Agent入门。通过@tool定义工具,bind_tools让模型返回tool_calls,手动执行工具并用ToolMessage回传结果;create_agent则自动完成调用循环。示例演示计算与字符统计,强调工具用于确定性任务,模型负责意图理解。
本教程介绍LangChain中PromptTemplate和结构化输出的用法。通过ChatPromptTemplate管理提示词模板,使用LCEL管道组合流程,并用PydanticOutputParser将模型输出解析为Python对象。文章包含代码示例、运行方法和常见问题,帮助读者掌握提示词模板化及结构化数据提取技巧。
本文介绍LangChain入门第一步:用uv创建Python 3.12虚拟环境,安装LangChain相关依赖,通过.env配置OpenAI兼容接口,并编写最小ChatOpenAI调用demo。代码包含配置读取和消息调用,运行`uv run python -m chapter01.chat_basic`即可测试模型响应,为后续Prompt、Agent和RAG学习打基础。
完成下面两步后,将自动完成登录并继续当前操作。