PrismML发布Ternary Bonsai 2 27B三元量化多模态模型,27.36B参数压缩至5.9GB,保留基座98.2%分数。但权重存于旋转基底,运行时需执行Walsh-Hadamard变换,原版llama.cpp与Ollama无法运行。TensorSharp通过显式校验变换契约、转码自定义格式接入该模型,拒绝静默跑错,代价是内存增加6%至29%,性能略慢于官方基线。
Hugging Face宣布Transformers可直接加载并高效运行GGUF量化模型,官方示例使用Qwen3.5-4B的Q4_K_M文件,在Apple Silicon上复用ggml的Metal内核。这解决了本地模型推理与分析工具链割裂的问题,使同一份GGUF进入Python生态,便于评测和自定义解码。但llama.cpp仍是高效推理首选,首批仅覆盖MPS,基准对比需区分预填充与纯解码。
OpenSourceJev 通过 llama.cpp 直接读取大模型 logits,跳过文本生成,将 LLM 改造成结构化决策引擎,在消费级显卡上实现亚百毫秒输出,消除 JSON 解析错误。它提供 Noul、Choice、Score、Text 四个原语,并用温度缩放校准降低过度自信,已在客服工单分类和 ViZDoom 游戏中验证。
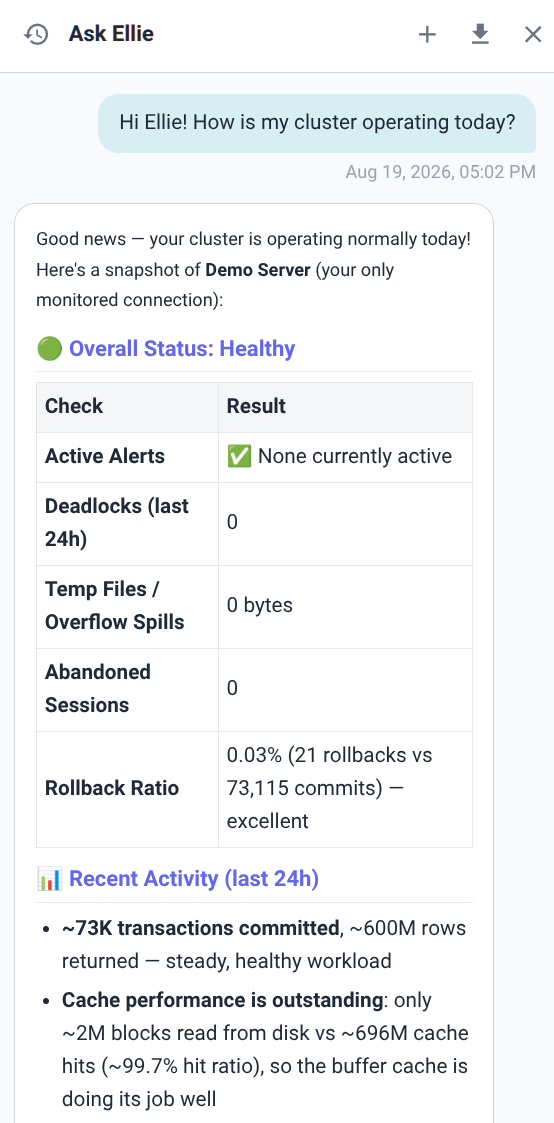
本文介绍如何用 Docker 搭建 pgEdge AI DBA Workbench 全本地化技术栈,共七个容器:Postgres、负载生成器、llama.cpp 模型服务、工作台服务器、采集器、告警器和客户端。使用 Qwen3.8-27B 推理模型与 nomic-embed-text 嵌入模型,通过 OpenAI 兼容接口调用,无需外部 AI 服务,适合气隙或敏感环境,可低成本实现 Postgres 智能监控与诊断。
DSpark是一种投机解码技术,通过并行草稿与轻量级顺序组件结合,提升LLM生成速度。在llama.cpp中测试Qwen3-8B,启用DSpark后生成速度从95.0提升至124.9 tokens/s,约31.5%加速。尽管MTP更通用,DSpark在草稿质量上占优,但模型支持有限,适合实验。
vLLM的并行限制源于注意力头数需被TP大小整除,而非固定1/2/4/8卡;llama.cpp采用层切分,通信量小,卡数影响不大,关键在互联类型。TensorSharp引擎同时支持层切分和张量并行,3卡跑744B模型性能超llama.cpp,但TP对互联敏感,2卡仅提升1.4倍。核心结论:层切分对卡数免疫,TP对互联敏感。
Muse Glimmer是Meta推出的本地AI编码模型,性能优于Qwen 27B类模型。本文指导用户通过llama.cpp和DFlash加速运行,并连接Pi代理实现本地编码。测试显示速度达127 tokens/秒,能自主构建、测试和调试项目,但HTML生成略逊于Qwen。推荐RTX 3090/4090/5090用户尝试,本地AI编码已接近付费模型体验。
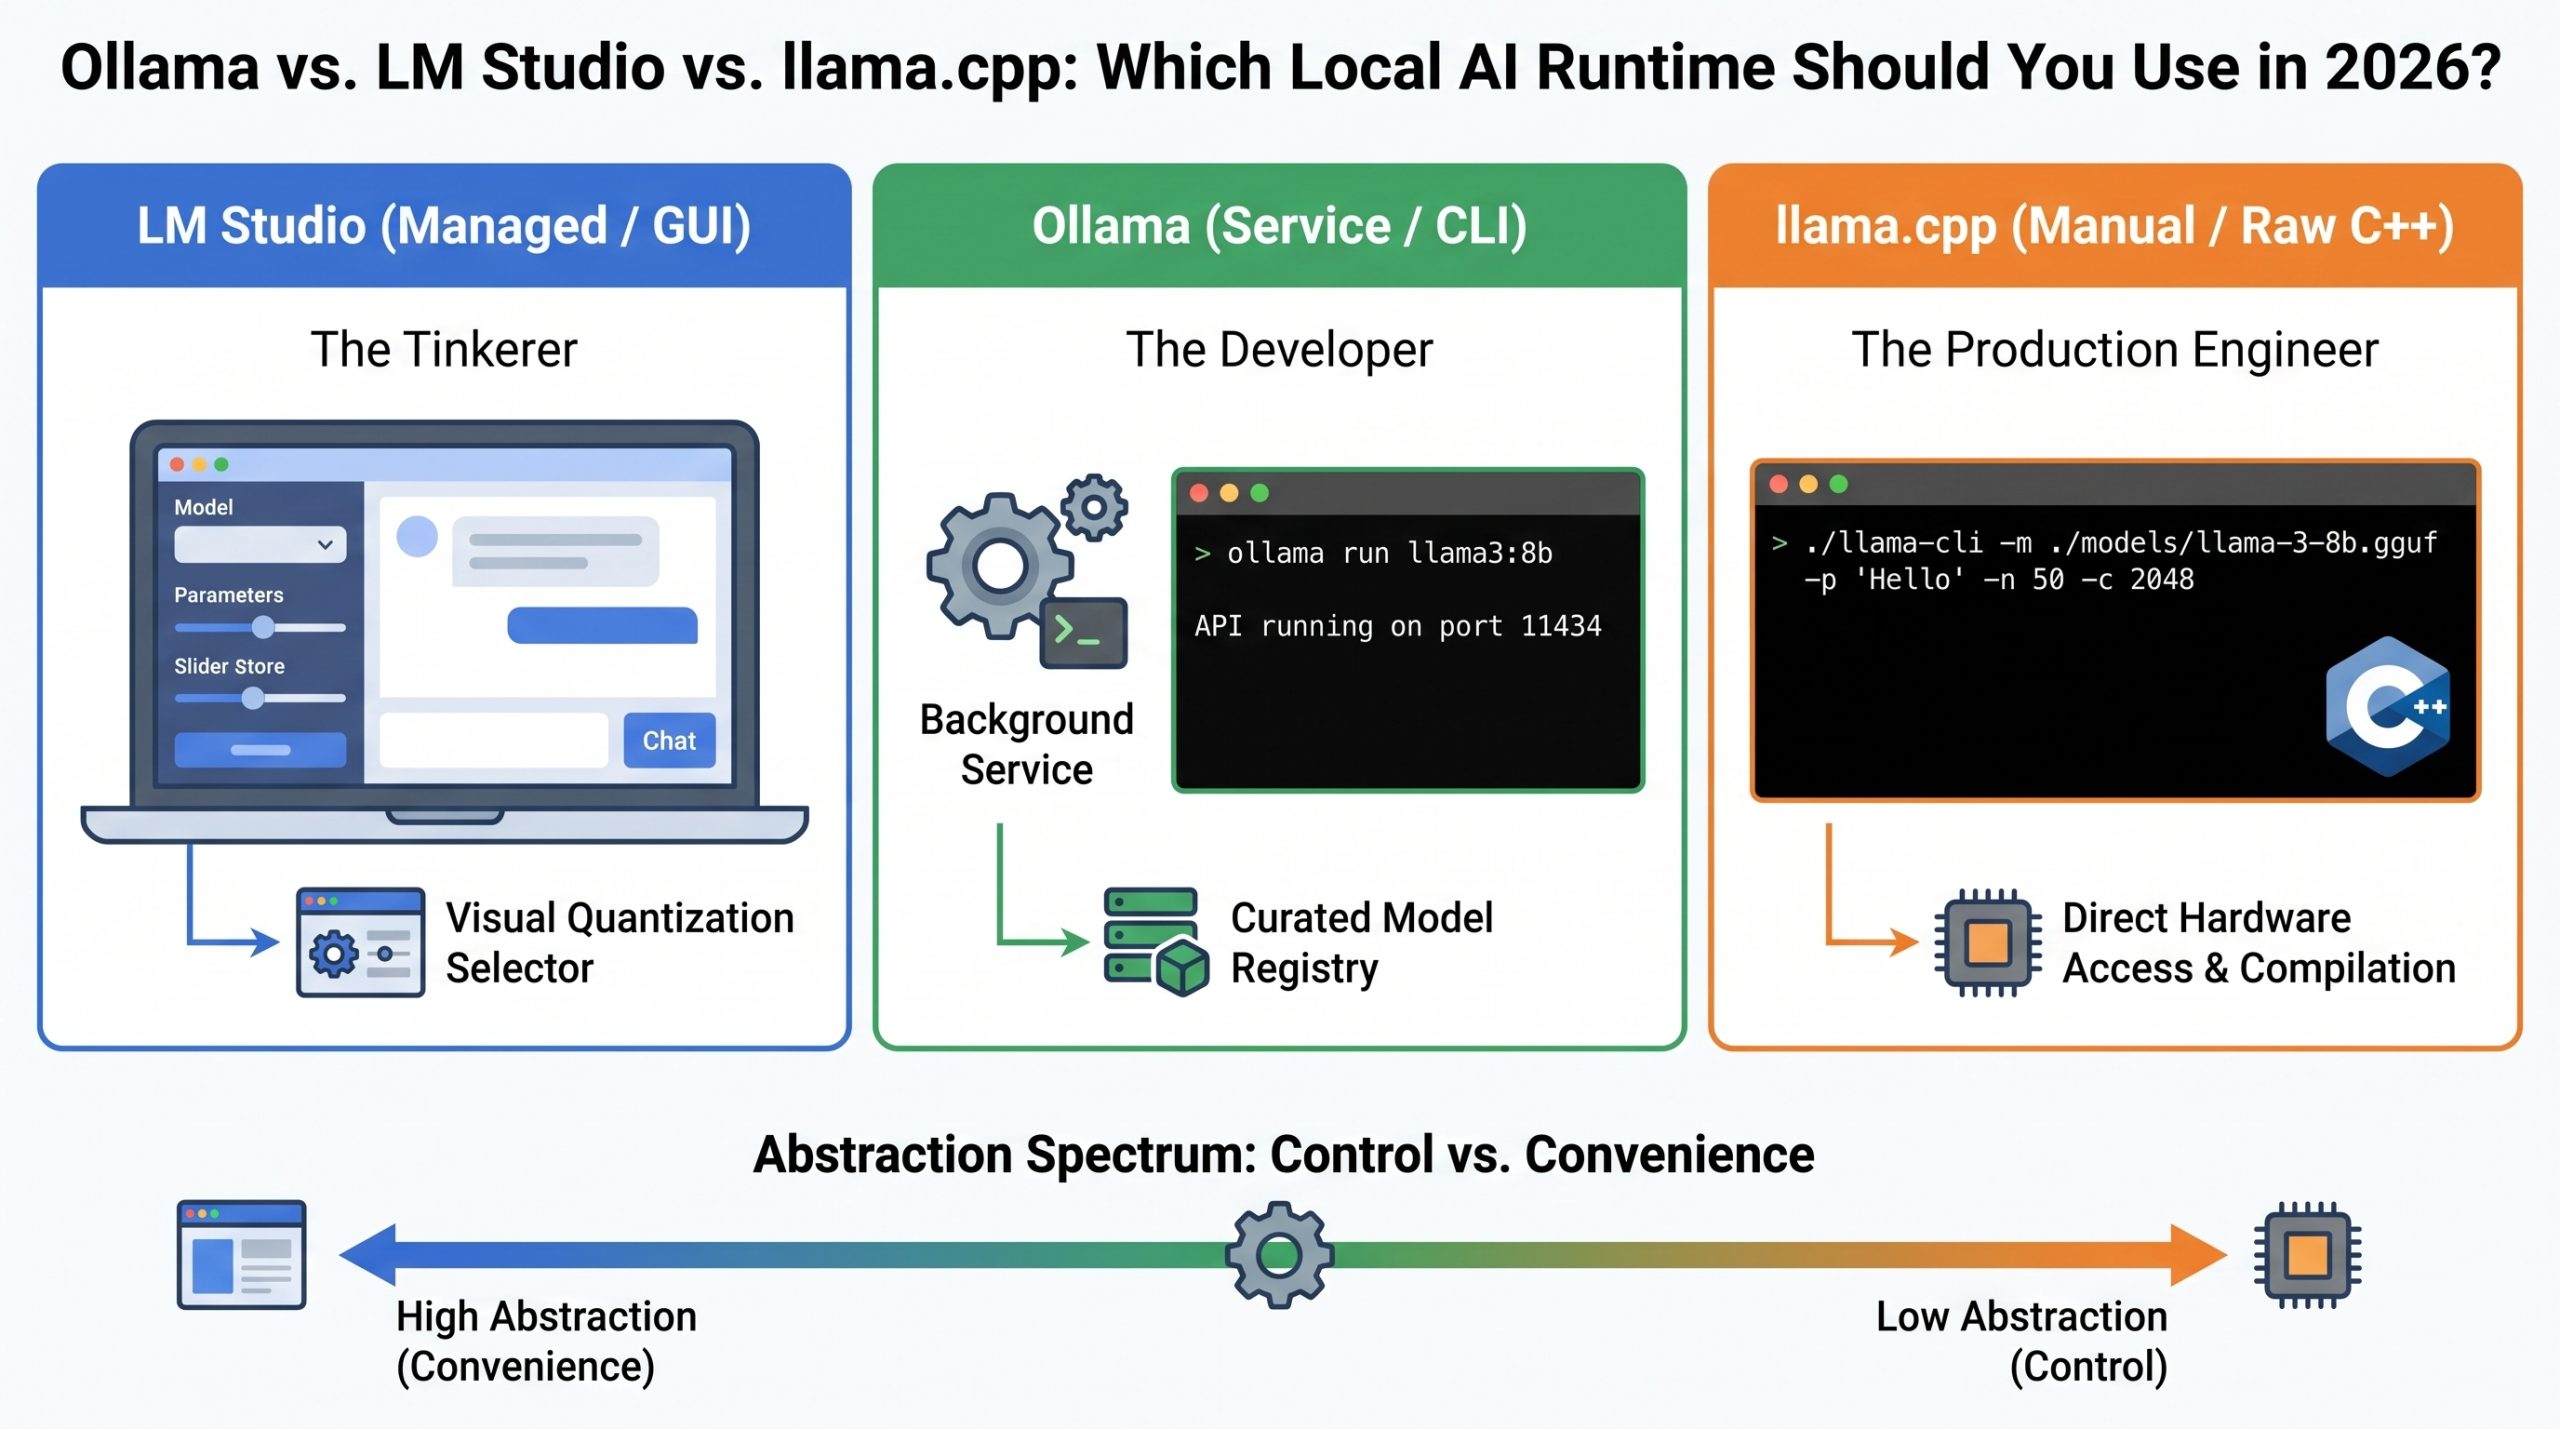
本文比较了Ollama、LM Studio和llama.cpp三种本地AI运行时。LM Studio适合初学者,提供图形界面和可视化量化控制;Ollama适合开发者,提供简洁CLI和API集成;llama.cpp适合追求极致控制的生产工程师,支持手动量化。三者共享同一推理引擎,用户可按需从LM Studio迁移至Ollama再至llama.cpp。
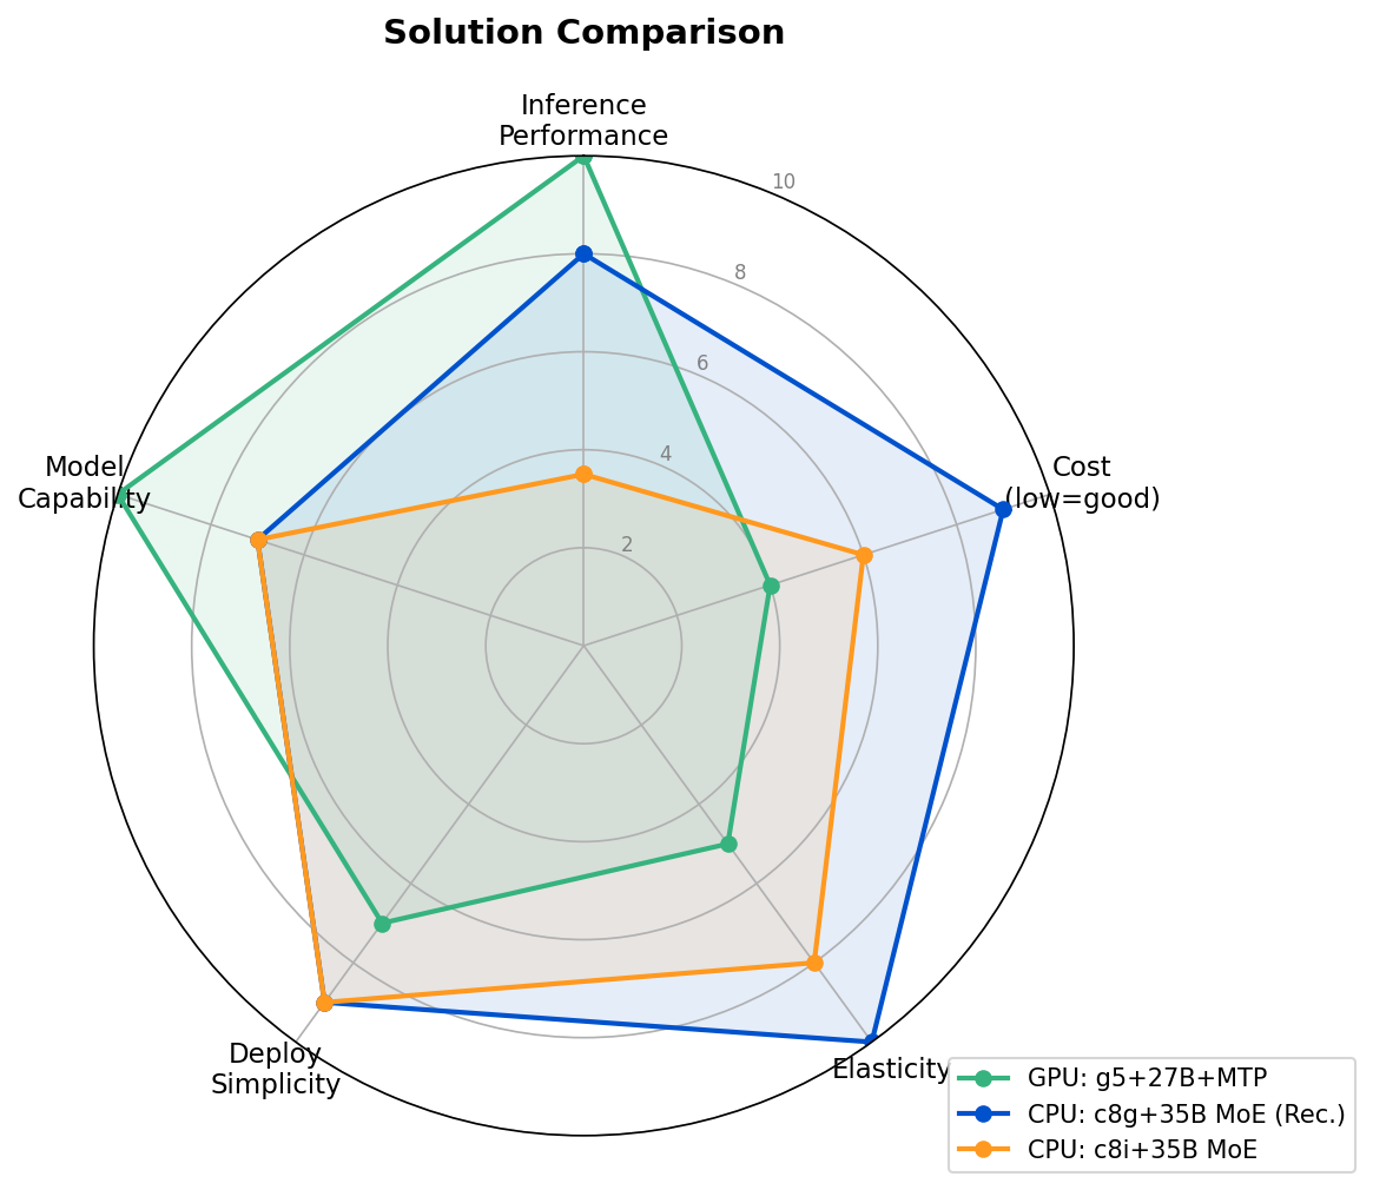
本文在AWS中国区实测llama.cpp部署Qwen3.6模型,对比Graviton4、Intel CPU和A10G GPU的MTP加速效果。GPU上MTP提升83%性能,CPU上反而降低18-40%。最佳实践:GPU用27B Dense+MTP,CPU用35B MoE关闭MTP,后者成本仅为GPU的26%,性能达82%。
本文介绍如何在本地运行Qwythos-9B-Claude-Mythos-5-1M模型,该模型为9B参数推理编码模型,适合消费级硬件。通过llama.cpp安装并启动服务,设置100K上下文和MTP推测解码,在RTX 4070 Ti Super上达到81.74 tokens/秒。随后安装Pi及llama插件,连接本地服务器作为编码代理。测试显示模型能成功构建浏览器游戏和CSV转Excel CLI工具,表现快速准确,无需外部API,适合日常编码任务。
文章揭示了Blackwell架构原生支持INT4满血算力,通过修改cutlass代码或CUBIN后处理,可解锁SM100/SM110及RTX 5090的INT4/E0M3算力,吞吐与FP4 E2M1相当,支持混乘,未来可提升本地llama.cpp推理性能。
本文讨论了在Mac上使用llama.cpp时下载GitHub仓库速度慢的问题,建议使用gh-proxy服务加速下载,并通过转换链接提高效率。直接下载压缩包比使用git clone更快,因为压缩包减少了小文件传输时间。此外,作者提到在本地运行27B模型时遇到性能问题,考虑购买更高配置的Mac Studio。
文章讨论了在本地运行小型开源模型的可行性,特别是使用llama.cpp项目。作者分享了在Windows上使用3060显卡运行Qwen3.6 9B模型的设置,包括CUDA版本和参数配置。尽管显存有限,这些模型在简单任务中仍能有效使用。
llama.cpp 是一个高性能的 C/C++ LLM 推理项目,优化了 Apple Silicon 和 x86 架构,支持多种量化选项。Awesome-LLM-3D 汇总了多模态语言模型在三维世界中的应用资源。evcc 是电动汽车充电控制器,支持多种通信协议。生成 AI 文档提供 Google Gemini API 的信息和示例。
jina-embeddings-v4推出了先进的多模态嵌入,支持文本、图像和复杂文档的向量搜索。通过修改llama.cpp,实现了多模态嵌入的生成,解决了图像处理和注意力机制的问题。调试后,llama.cpp模型的嵌入结果与参考模型相近,未来可优化视觉编码器和支持多向量嵌入。
本文介绍了如何在本地高效运行GPT-OSS 20B模型,使用llama.cpp和Open WebUI。通过简单的命令设置Python环境、安装必要的包、下载量化模型并启动服务器,用户可轻松获得现代聊天界面,实现本地推理。
本文介绍了如何在本地设置和运行 llama.cpp 服务器,构建并测试 AI 代理。教程包括安装、配置和编译 llama.cpp,集成 Langchain,以及创建支持网络搜索和 Python REPL 的 ReAct 代理。尽管设置过程复杂,但其高效性和灵活性使本地 AI 成为可能。
本文介绍了如何在Python中使用llama.cpp构建检索增强生成(RAG)管道。用户需安装必要库并下载LLaMA模型,创建文档库,处理多种格式的文档并分割成可管理的块。接着,使用Chroma构建向量存储,结合检索和生成方法,最终实现高效的RAG系统,能够根据用户查询生成准确回答并提供相关文档来源。
本文介绍了开源大模型的最新进展,特别是DeepSeek-R1的推出,标志着开源模型逐渐追赶闭源模型。文章讨论了本地大模型的推理框架、应用及生态,强调了llama.cpp项目的硬件支持和量化策略。通过Ollama和Open WebUI,用户可以更方便地使用大模型,进行联网搜索和本地知识库增强,提升应用体验。
Ollama 允许用户在本地运行大型语言模型,提供模型托管服务。核心技术为 llama.cpp,支持 GGUF 模型格式。指南介绍如何在 Jetson Orin Nano 上编译 llama.cpp、转换 GGUF 模型并进行量化,以提高推理速度和减少内存占用。完成模型准备后即可进行推理。
完成下面两步后,将自动完成登录并继续当前操作。