Databricks与NVIDIA扩大合作,AI Runtime(AIR)正式可用。开发者可在无服务器NVIDIA GPU上使用NeMo、NGC容器和Nemotron工具包训练、微调并评估开源模型,无需管理GPU基础设施。AIR支持多节点分布式训练、自定义容器环境、MLflow实验追踪和Unity Catalog数据治理,并可通过Genie Code辅助调试。微调后的模型可经Databricks Model Serving部署用于实时推理,实现从企业数据到定制模型再到生产应用的完整流程。
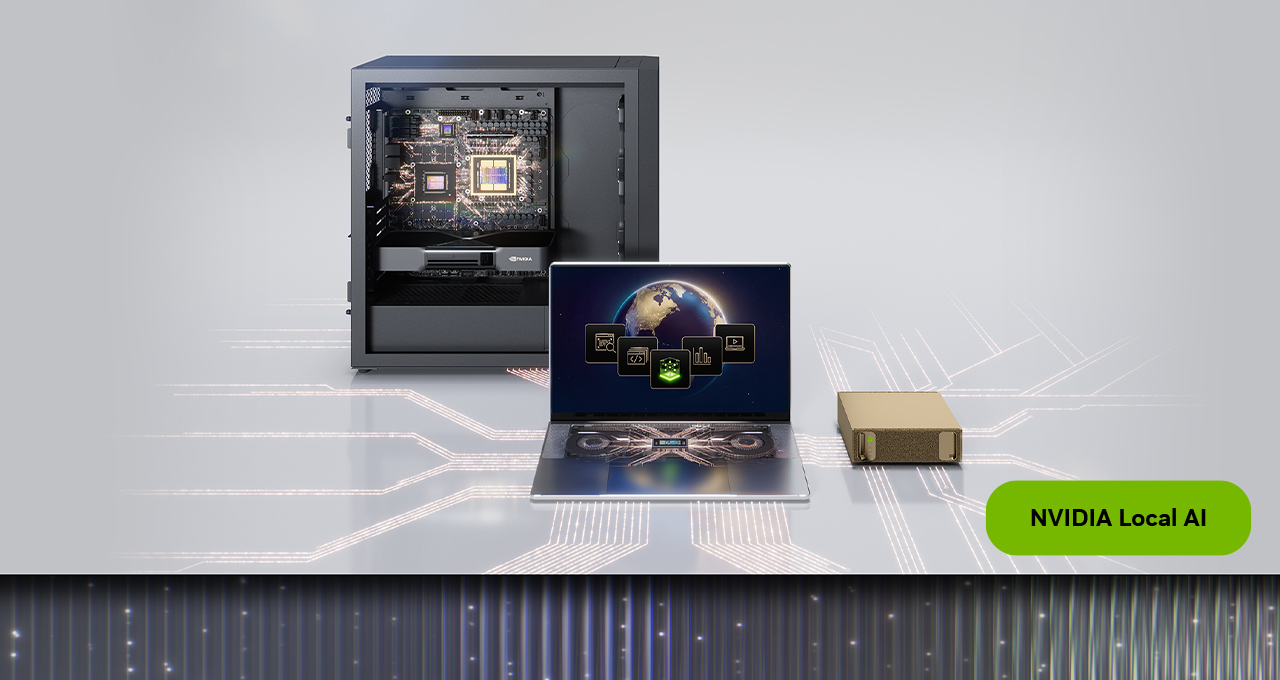
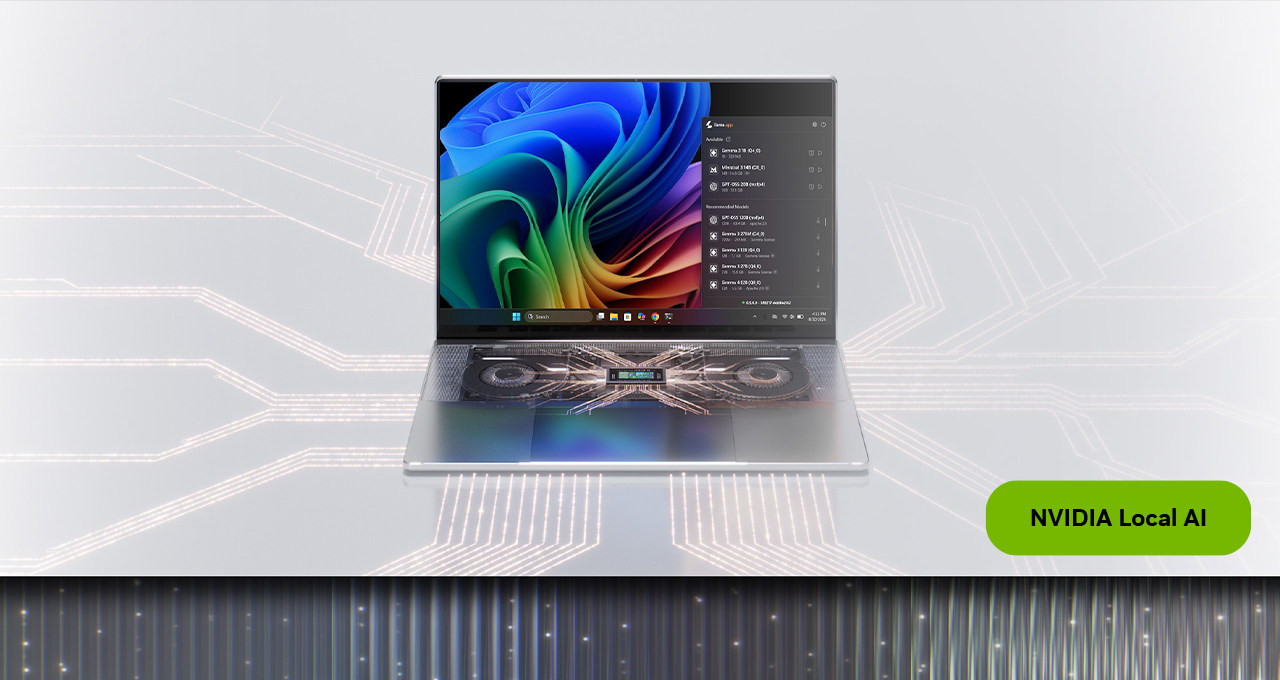
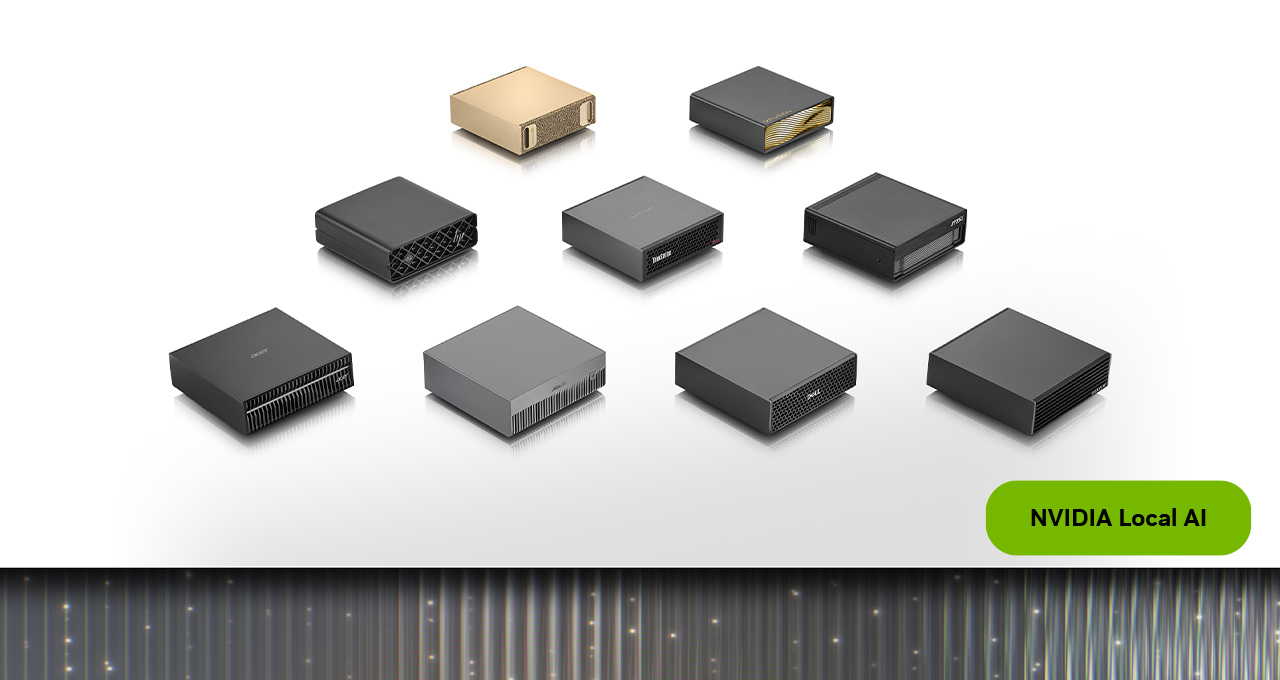
在GTC柏林大会上,NVIDIA展示了RTX Spark、DGX Spark和DGX Station三款本地AI硬件,用于加速编程、工程、机器人与AI工厂开发。RTX Spark面向Windows个人智能体;DGX Spark支持Linux开发者,可组建八机集群;DGX Station面向企业前沿负载,Windows版将于12月推出。此外,NVIDIA发布了本地编程模型Recursive Flint,并新增多款模型支持及推理加速。
谷歌云与英伟达宣布,基于Vera Rubin NVL72系统的A5X实例将于下月正式可用,并计划扩展至欧洲,为智能体推理和大规模强化学习提供集成的训练与推理平台。谷歌云计划在多站点部署多达96万块Rubin GPU。伦敦初创公司Ineffable Intelligence成为首个客户,用于推进“超级学习者”研究;WPP也展示了创意智能体架构。此外,谷歌云将率先在裸金属实例上提供机架级机密计算,并探索DSX MaxLPS以优化能效。
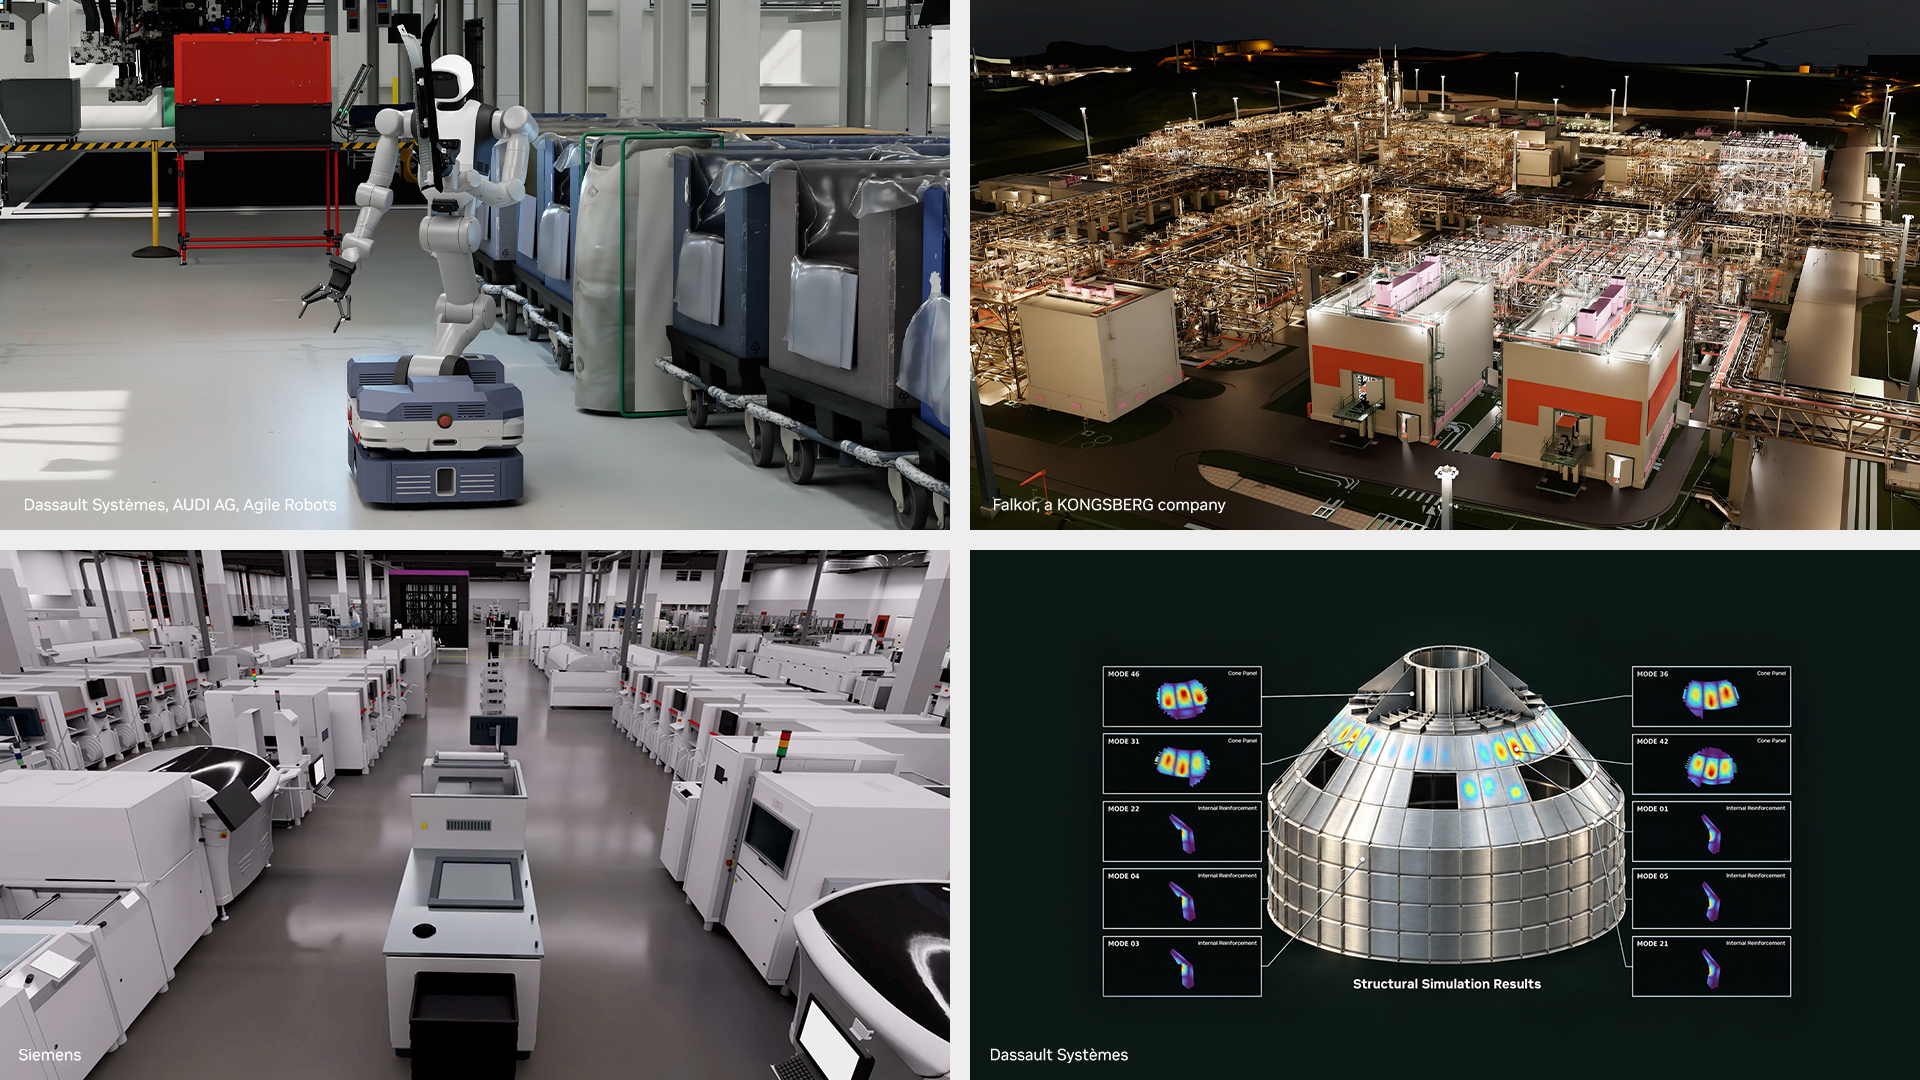
欧洲工业领袖利用NVIDIA CUDA-X、Omniverse、Cosmos及Nemotron模型加速工程与制造。NVIDIA推出工厂运营蓝图FOX早期版,支持构建协调机器与专项任务的工厂智能体。西门子将其集成于X中心,预计节省20%成本,并将检测校准时间缩短40%。奔驰、奥迪、舍弗勒等借助GPU仿真、数字孪生和机器人模拟加快设计与验证;imec、英飞凌等实现半导体仿真最高40倍加速。
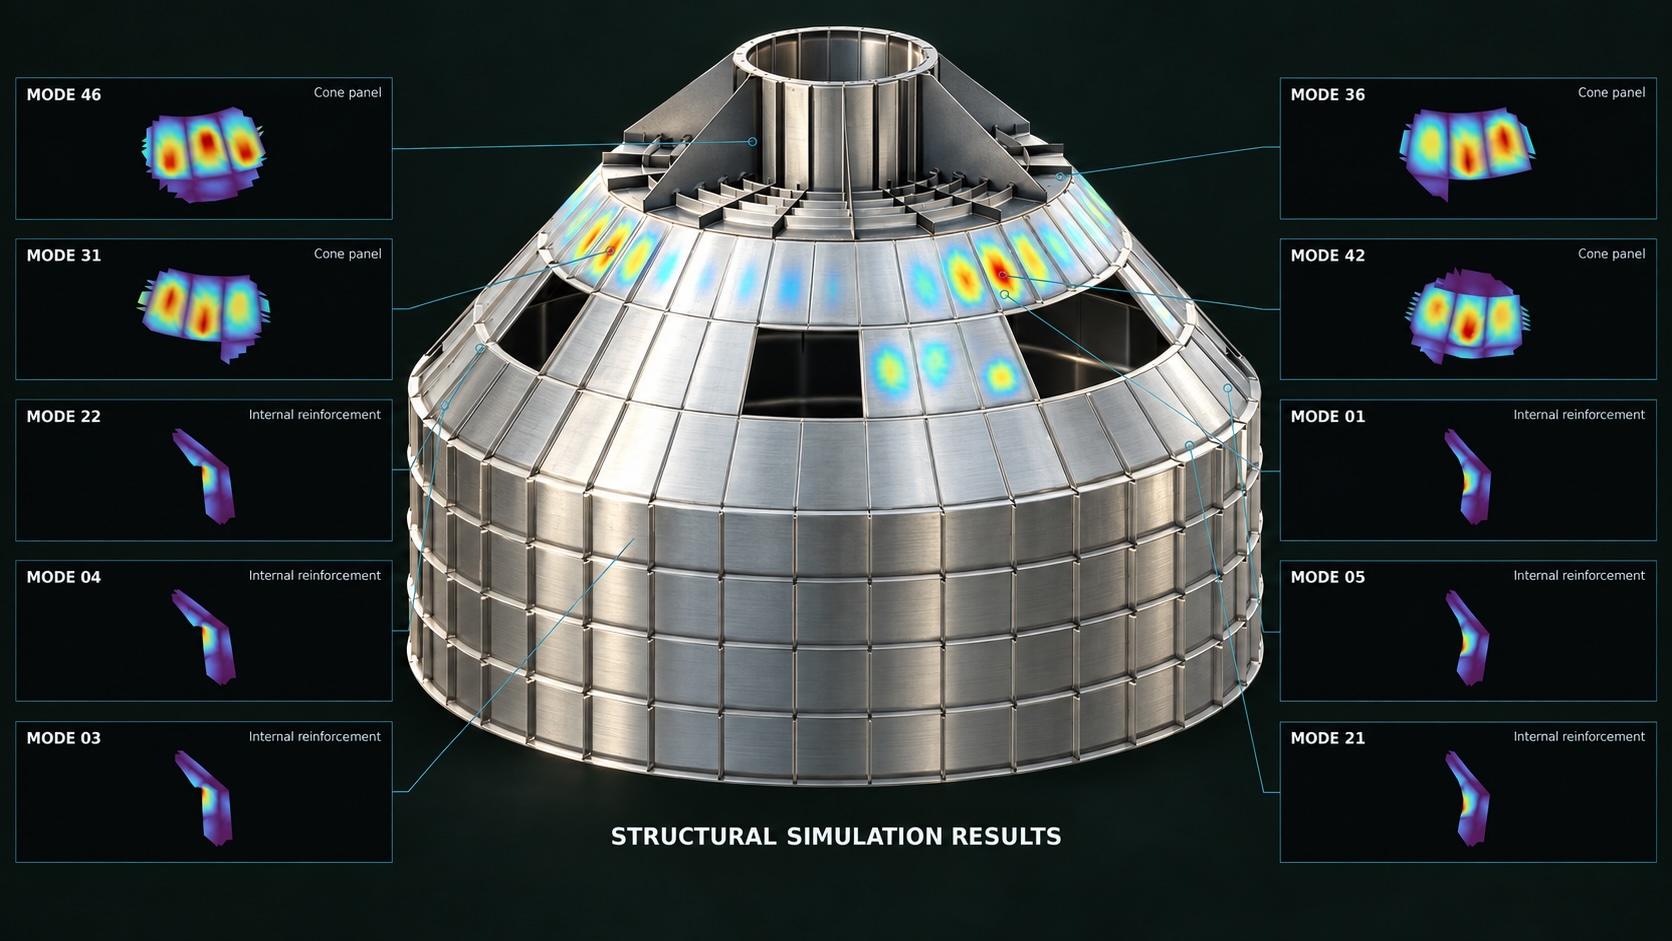
NVIDIA 正式发布 CUDA-X 库 cuDSS,可将工程与科学仿真中的大规模稀疏系统求解迁移至 GPU,缩短计算时间并提升仿真吞吐量。应用材料、COMSOL、Cadence、达索系统、西门子、新思科技等已将其集成到各自工具中,实现最高约10倍加速。cuDSS 支持从工作站到集群的扩展,并提供 C、C++、Python 和 Fortran 接口。
Elastic将Jina API和Elastic推理服务从NVIDIA L40迁移至RTX Pro 6000 Blackwell GPU,以加速智能体AI工作负载。实测显示:嵌入请求延迟最高降低约8倍,重排序提速4倍以上,OCR页面转换速度提升约3.7倍;混合负载下小请求延迟从708毫秒降至66毫秒。Jina小型模型在准确性和多语言、多模态覆盖上表现领先,迁移后客户无需改动即可受益。
Spotify将生成式AI用于播客推荐,采用基于语义ID的生成式检索与beam search生成候选。因vLLM的beam search效率有限,Spotify与NVIDIA合作改进TensorRT LLM,补齐多序列返回、评分API和软令牌注入等功能,并探索用用户嵌入投影实现个性化。优化后beam search成本降低最高54%,评分成本降低7%。
JetBrains 宣布 Junie Local 本地 AI 编程助手正式支持 NVIDIA RTX Spark,Windows 支持从实验转为稳定。在 RTX Spark 上生成速度可达每秒 55 个 token,自动适配显存调整上下文,并采用 FP8 与推测解码加速。配备 24GB 以上显存的 RTX 显卡即可运行,免费使用,无需注册。
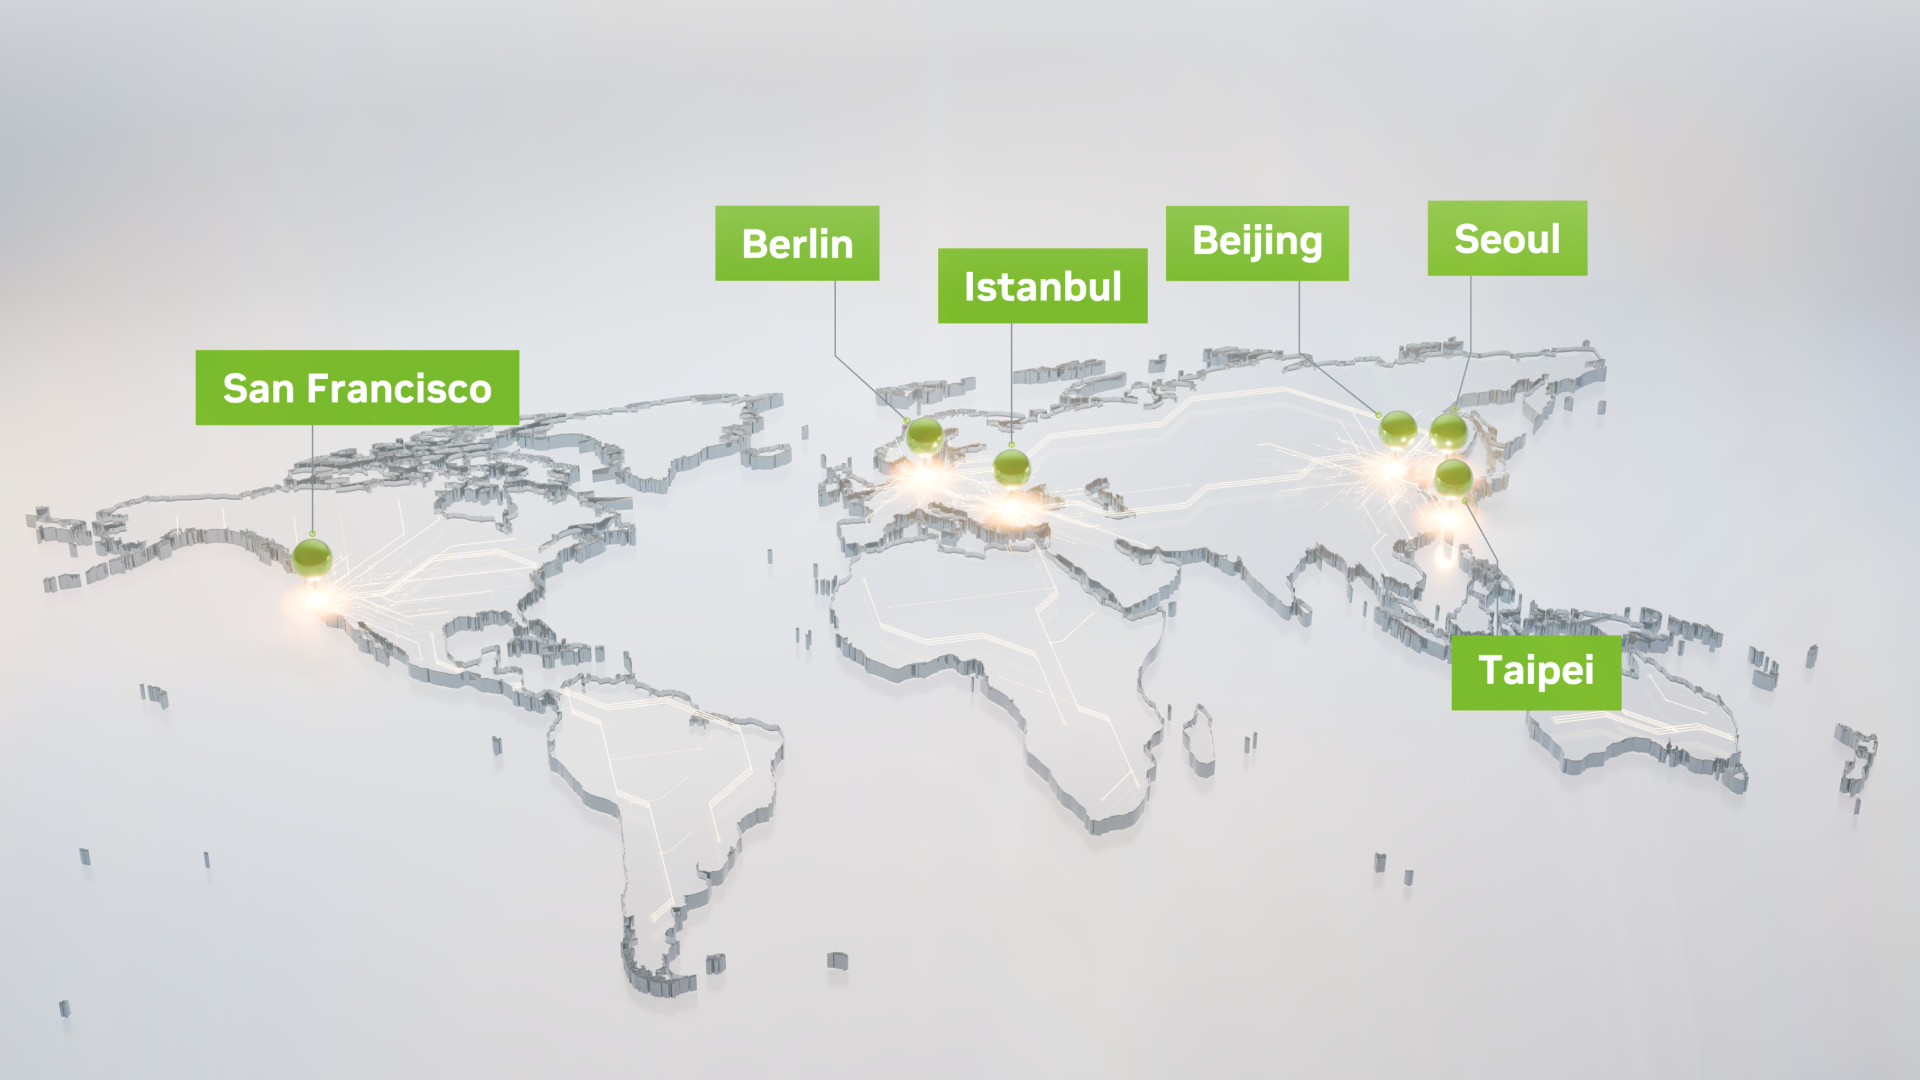
英伟达发布RTX Spark,一款面向创作者、玩家和AI智能体的Windows PC,主打本地AI。媒体评测称其AI、游戏和创作性能出色。10月16日起在旧金山、柏林、台北、北京等地举办发布活动,提供动手演示。线上可用#ShareYourSpark分享故事,有机会赢取黄仁勋签名笔记本。
英伟达发布Nemotron 3.5系列开源模型。旗舰Super VL为1200亿参数多模态模型,准确率媲美最大推理模型,吞吐量快5倍,支持企业定制后训练。同时推出边缘模型Bolt 74B-A9B(24GB)和Bolt E4B(4GB),可在本地RTX设备运行智能体任务。模型覆盖从数据中心到桌面的全场景部署,强调开放权重、数据隐私与定制能力。
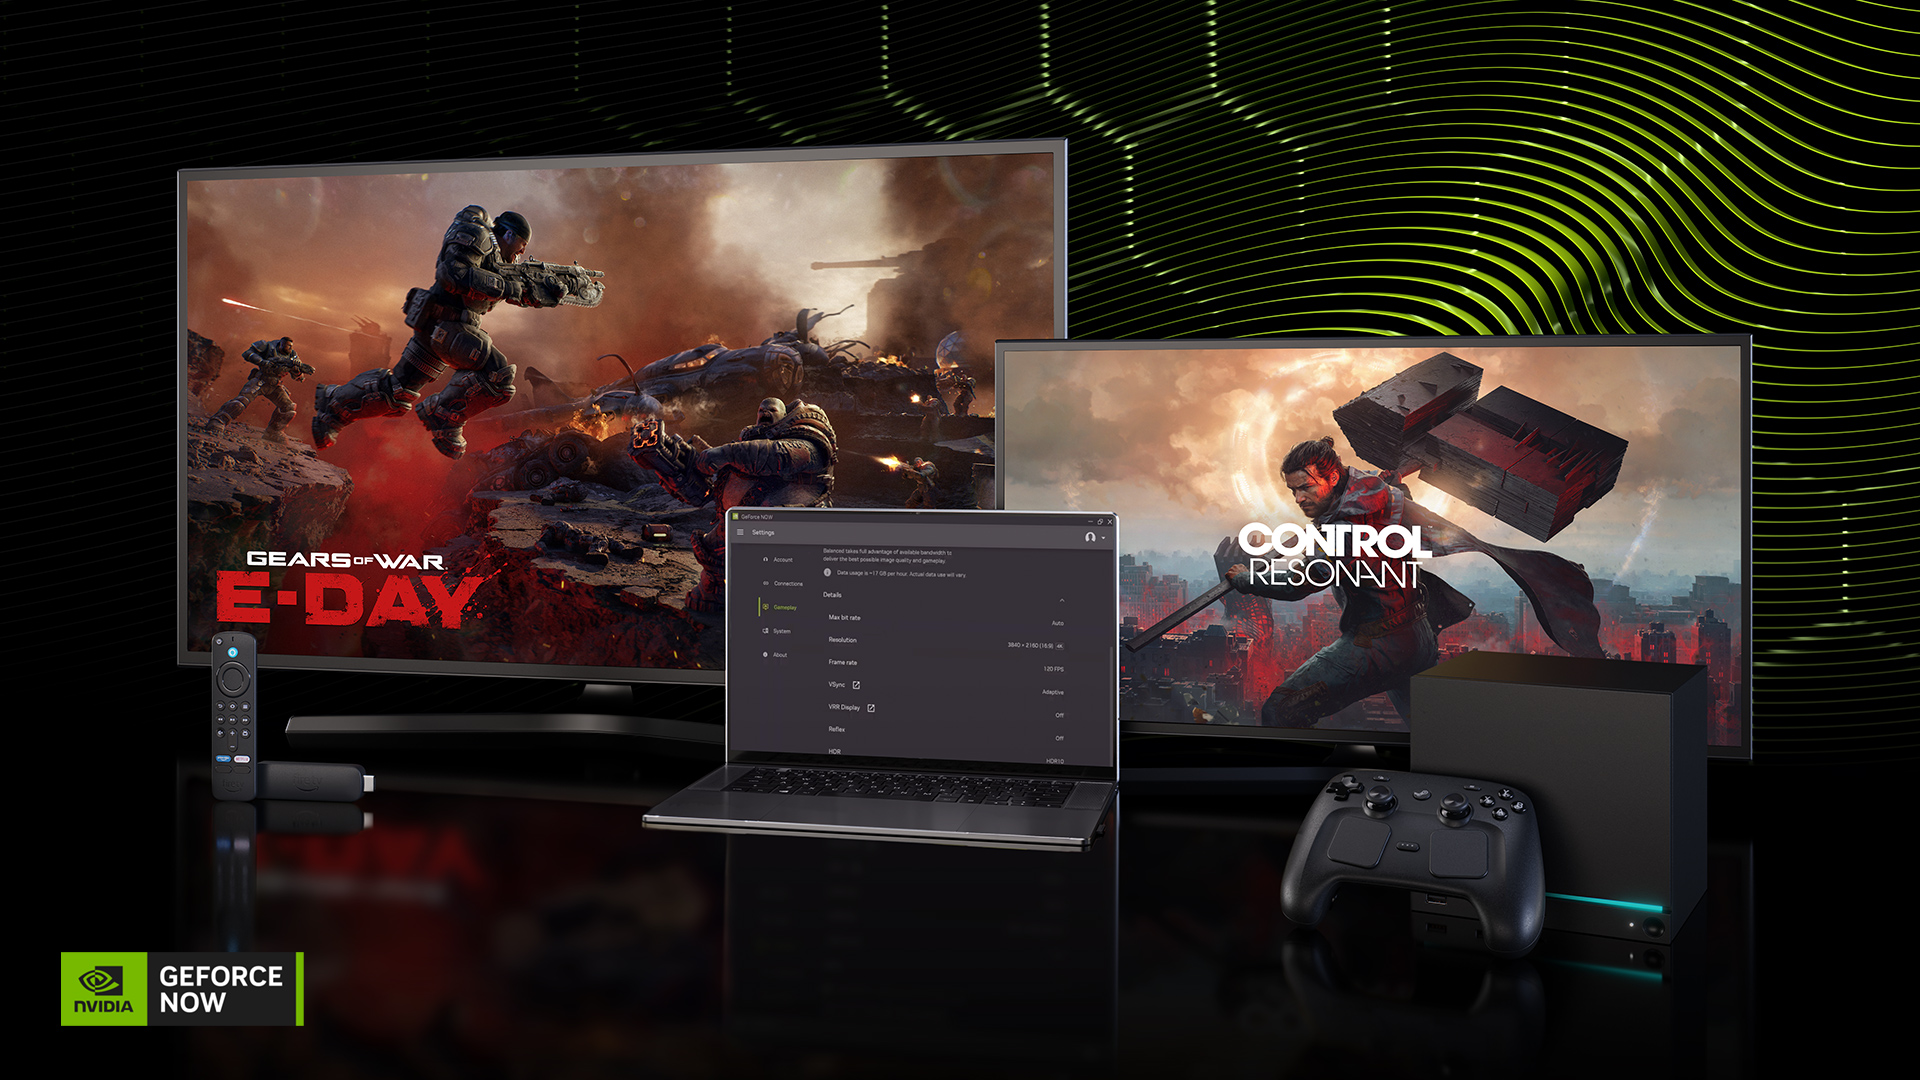
GeForce NOW本周上线DLSS 4.5控制功能,会员无需最新硬件即可调节画质与性能,Ultimate会员在RTX 5080云主机上可享最高4倍动态多帧生成。《Enshrouded》1.0正式版与《战锤40K:爆弹枪2》同步首发云游戏,另有10款新游加入,包括《动物园之星2》《巫师3》等。
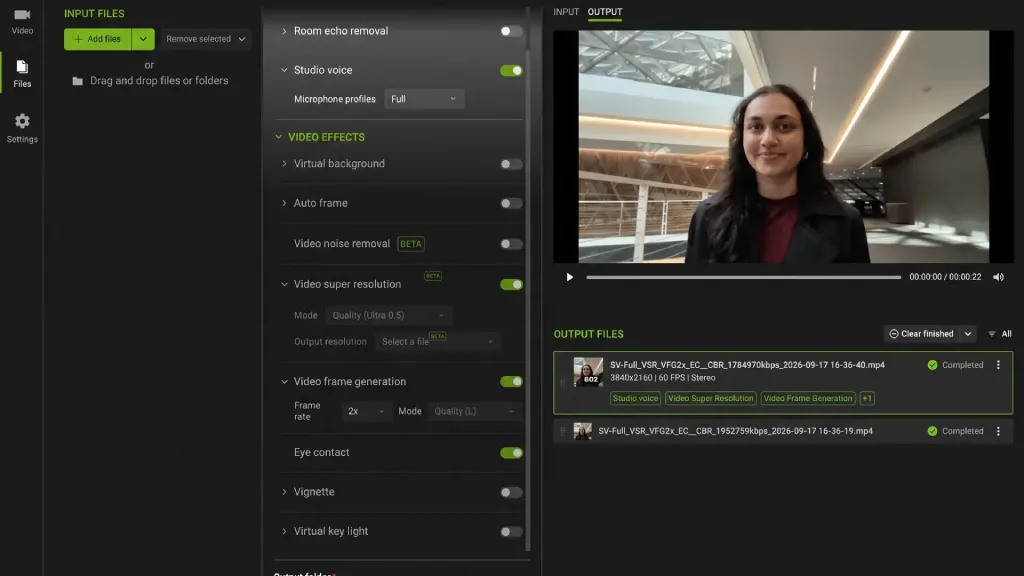
NVIDIA Broadcast 2.3.0发布,新增RTX视频超分辨率与帧生成测试版,可将摄像头画面提升至4K、60帧,并支持视频文件帧率倍增。同时加入独立文件处理模式、Studio Voice麦克风四种预设及本地MCP服务器AI集成。最低需RTX 2060和8GB内存,超分需RTX 3060,帧生成仅限RTX 40系,兼容Win10/11。
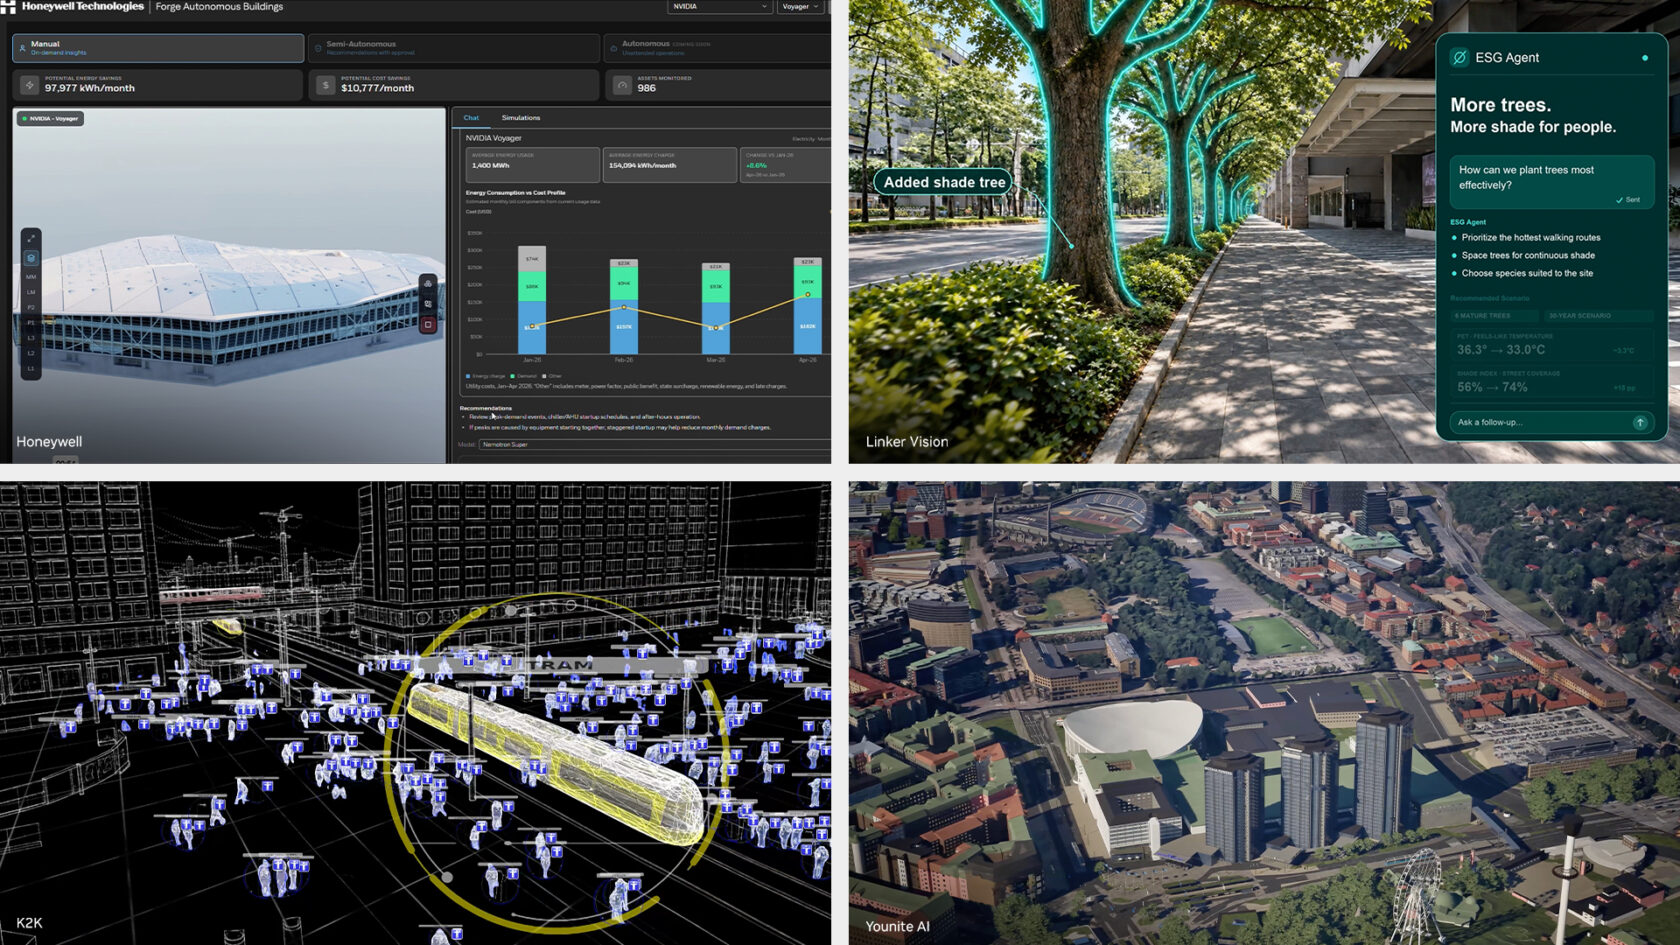
欧洲多城市采用NVIDIA加速计算与AI代理提升城市运营和公共服务。合作伙伴利用Cosmos、Nemotron和Omniverse构建数字孪生,应用于交通、能源、安全等领域。法国科多尔省500多栋建筑降低运营成本10%,意大利米兰提供实时翻译与市民聊天机器人。项目覆盖英国、法国、意大利、比利时、瑞典等地。
英伟达RTX Spark超级芯片将于10月16日随笔记本上市,整合游戏、创作与本地AI,最高128GB统一内存、1 petaflop算力。届时数千款应用、游戏和模型就绪,包括Nemotron 3.5 Bolt 74B本地智能体模型、PAIR正式版、Broadcast 2.3、DLSS 5及Adobe、Blender等优化。
联想YOGA Pro 15 RTX Spark于10月8日开启盲约,是全球首批搭载NVIDIA RTX Spark N1X超级芯片的本地智能体AIPC。它集成Blackwell RTX GPU与Grace CPU,端侧AI算力达1 Petaflop FP4,配128GB统一内存和2TB存储,支持本地运行超千亿参数大模型。搭载天禧AI超能模式,实现断网可用、零Token成本与隐私安全,面向AI创作、开发和科研人群。
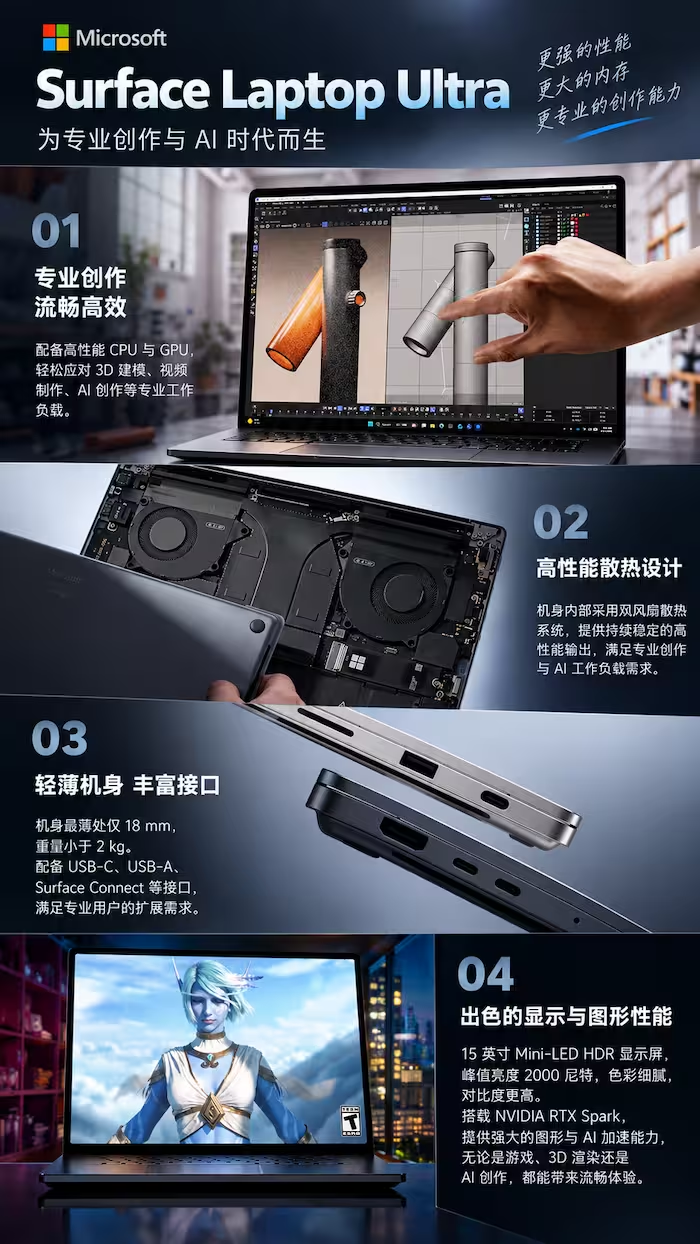
微软发布Surface Laptop Ultra,搭载NVIDIA RTX Spark芯片,最高20核Grace CPU、6144 CUDA核心、128GB统一内存、1 PFLOPS AI算力,配备15英寸Mini-LED触控屏,厚不到18mm,重约2kg,售价2599.99美元起,10月16日发货。微软称其AI性能最高比M5 Pro版MacBook Pro快6.2倍,但仅首Token响应2.1倍为真机测试,其余为其他设备数据。
电信运营商正基于开源模型构建AI战略,以兼顾成本、可控性与定制化。NVIDIA报告显示,89%受访者认为开源模型对AI战略重要。开源模型可降低成本、支持电信专属微调、增强可信度与灵活部署,并助力本地化AI服务。SoftBank、AT&T、Indosat等运营商已用Nemotron等开源模型开发电信专用AI,推动自主网络与客户服务落地。
英伟达推出DGX Spark 64GB版,10月23日起由宏碁、华硕、戴尔等厂商发售,起价4999美元。该设备搭载GB10超级芯片与统一内存,支持本地运行最高千亿参数模型,预装完整AI软件栈。两台设备可通过Sync Cluster Assistant互联,内存池化至128GB,性能提升最高1.7倍,支持两千亿参数模型。
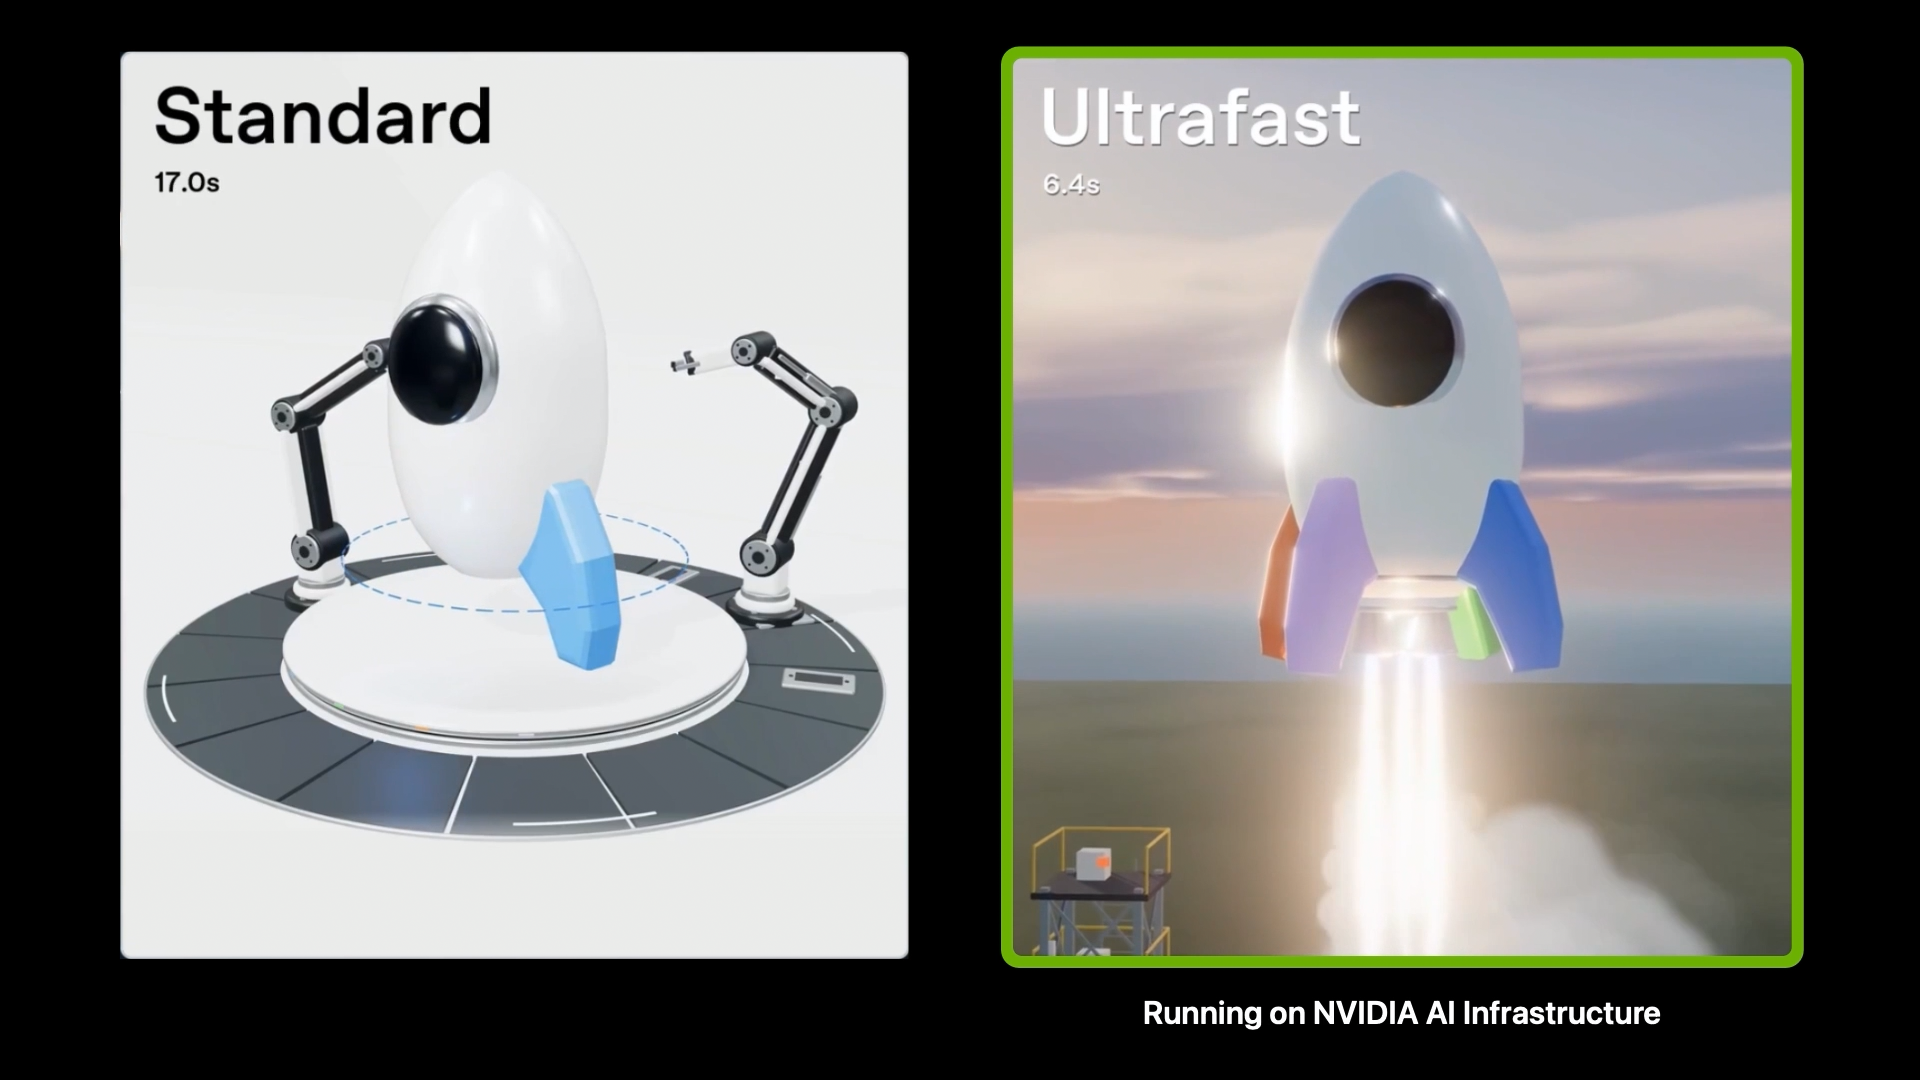
OpenAI推出GPT-6 Astra Ultrafast,运行于NVIDIA Blackwell GPU,通过持续推理优化,令牌生成速度比标准模式快8倍。该模型已上线OpenAI API,面向ChatGPT Work和Codex用户,可加速代码生成、工具调用和交互应用。OpenAI还利用自身模型优化GPU推理软件,提升性能与基础设施利用率。
Supermicro正式供应NVIDIA Vera Rubin NVL72机柜,采用DCBBS模块化方案与DLC-2液冷技术。机柜搭载72个Rubin GPU和36个Vera CPU,配备18个1U计算托盘,通过NVLink互连,提供20.7TB HBM4内存。DCBBS覆盖全部关键计算基础设施,液冷方案包括冷板、CDU与冷却塔,可扩展至GW级规模,并提供端到端部署服务。
完成下面两步后,将自动完成登录并继续当前操作。