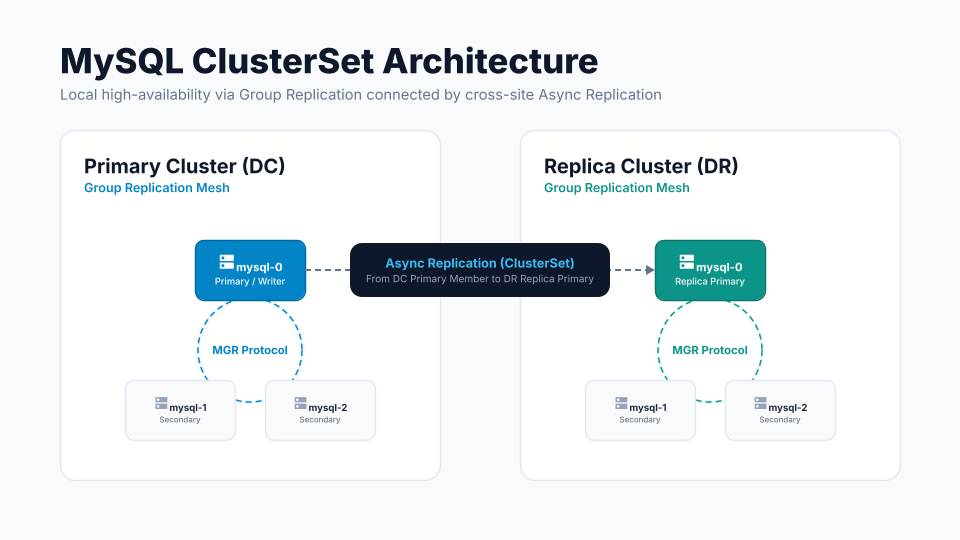
Percona工具动态:pt-online-schema-change的where条件在Galera集群中涉及分块自动调整与流控;Percona Operator支持跨集群组复制实现DC-DR;Mongorewind可无需恢复备份直接回退MongoDB测试数据。
该文讨论MySQL数据目录中出现过多GCache页面文件的问题,分析其成因及对数据库的影响,并给出排查与清理建议。
Lyft has moved hundreds of production Flink jobs from a 2020 in-house Kubernetes operator to the Apache Flink Kubernetes Operator, unlocking last-state upgrades, in-place autoscaling and resource...
本系列从源码角度解析 KubeRay 与 Volcano。先介绍 Ray、Kubernetes、KubeRay 与 Volcano 的职责与架构;KubeRay 部分涵盖组件分工、Reconcile 协调、并发管理、Operator 重启恢复与高可用;Volcano 部分涵盖 Job、PodGroup、Queue 架构、Gang 调度、队列资源竞争与抢占,以及 KubeRay 接入和生命周期协作;最后总结 Operator 设计。
KubeRay Operator 通过工作队列和协调协程管理大量 RayCluster。并发数限制同时执行的 Reconcile 轮数,默认 1,设为 2 则两个协程轮流处理不同对象。同一对象按键锁定,不会被并发处理。由于缓存滞后,需用 scale expectations 避免重复创建 Pod。版本冲突靠 resourceVersion 乐观并发检查处理。是否提高并发应依据队列积压、协调耗时和错误率等指标判断。
KubeRay Operator 重启后不依赖内存状态,而是通过 Kubernetes 中持久化的 spec、status 及已有资源恢复协调。RayJob 使用 jobDeploymentStatus 记录管理阶段,jobStatus 记录 Ray 作业状态。重启不会被记为失败或开启新执行轮次;若资源已创建但状态未写回,新 Operator 会根据 status 中的集群名和 submission ID 查找并复用已有资源。Ray 服务端以 submission ID 防止重复提交,但无法保证业务层面的 exactly-once。
本文总结KubeRay与Volcano源码阅读:用户提交RayJob后,KubeRay创建RayCluster及head、worker Pod,集群就绪后由submitter经Ray Jobs API提交程序。启用Volcano时,先写PodGroup,再在Pod上标注调度器与组信息,由Volcano负责Pod绑定。KubeRay协调、Volcano调度与Ray运行时三套循环通过Kubernetes对象和Ray API衔接,各自独立重试。恢复依赖可重建状态链,高可用需分层看待。
This week's Java roundup for August 31st, 2026, features news highlighting: the GA release of TornadoVM 6.0; point releases of JReleaser, LangChain4j, Java Operator SDK, JHipster, Kotlin Toolchain...
CYBERTEC PG Operator 实现 PostgreSQL 在 Kubernetes 上的无停机运维。修改清单即可调整内存、参数、副本数或小版本升级,Operator 以滚动方式先更新副本再切换主节点,全程可用。扩缩容自动克隆或排空节点,主节点移除前先故障转移,确保数据不丢失。其核心是声明式模型:用户修改期望状态,Operator 负责无停机协调。
Rook是Ceph的Kubernetes Operator,通过CRD声明期望状态并调和出守护进程。核心CRD包括CephCluster、CephBlockPool等,v1.20起CSI调谐由Ceph-CSI Operator负责。Rook不管理RADOS内核语义,数据面问题需转向Ceph自身。排障时需明确对象归属、权威控制器及变更来源,避免误判。
Rook v1.20 强制引入 Ceph-CSI Operator,CSI 设置从旧 ConfigMap 迁至 OperatorConfig 与 Driver CR。OperatorConfig 管理共享默认,Driver 管理各驱动覆盖,Driver 名即 provisioner 名。Helm 必须安装 ceph-csi-drivers chart,清单安装需含 csi-operator.yaml。升级前需导出 CR,避免定制被覆盖。所有权明确:管理员通过 CR 调谐 CSI,Rook Operator 只管 Ceph 生命周期。
本文讨论Rook/Ceph/CSI升级纪律,强调升级需遵循一次一个主版本、避免HEALTH_ERR强推、注意CSI Operator迁移和快照CRD错位。列出升级前检查清单和反模式,主张数据面升级人工审批,确保版本兼容和健康检查,防止跳版本导致故障。
CYBERTEC推出开源PostgreSQL Kubernetes Operator,支持多站点集群管理,提供跨站点复制、自动故障转移及部署架构指导,解决PostgreSQL跨多个Kubernetes环境运行的难题。
Percona MongoDB Operator 1.23.0发布,新增ClusterSync组件,支持克隆并持续同步实时数据库,实现短时切换迁移。该版本还支持语义向量搜索,无需额外系统,并利用PVC快照备份从存储层快速完成,减少网络瓶颈。此外,支持RKE2和ARM64,提升运维便利性。
迁移生产环境中的PostgreSQL数据库到Kubernetes需要考虑数据转移、停机时间和操作复杂性等因素。文章介绍了从Crunchy Data PostgreSQL Operator迁移到Percona Operator的几种方法,强调每种方法适用于不同的操作场景。选择合适的迁移策略需平衡停机时间、复杂性和业务连续性,建议在测试环境中验证以确保安全高效的过渡。
etcd-operator项目已捐赠给Cozystack,并发布了新版本etcd-operator.cozystack.io/v1alpha2。新版本直接使用etcd的Membership API,改进了集群成员管理,采用独立的EtcdMember资源,支持按需备份和TLS通信,旨在满足多租户需求,具备零规模和内存存储等新特性。
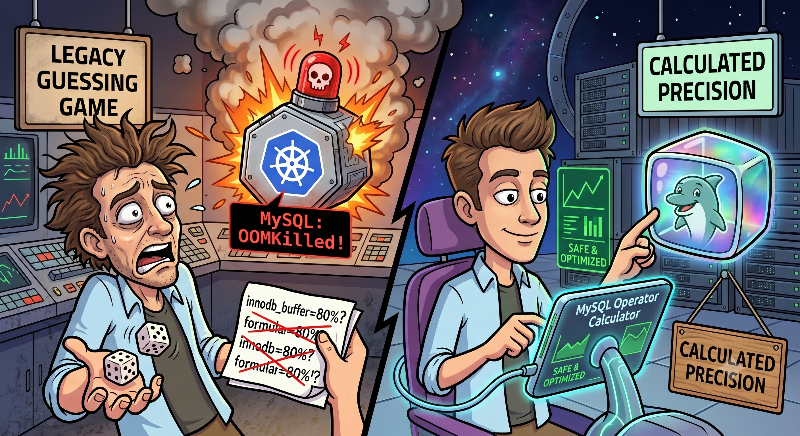
MySQL Operator Calculator 是一款工具,旨在简化 MySQL 数据库迁移到 Kubernetes 的配置过程。它通过输入实际资源和负载类型,自动计算安全的配置参数,避免手动调整带来的风险,提高数据库性能和稳定性。
在Kubernetes中,管理共享凭证的挑战通过采用External Secrets Operator(ESO)和Bitwarden Secrets Manager得以解决,实现了跨隔离环境的秘密同步。集中管理使凭证旋转在一个位置完成,并自动传播到所有环境,简化了操作并提高了安全性。此方法适用于多种云服务,降低了运维复杂性。
在Amazon EKS上,使用NVIDIA GPU Operator可以有效管理自定义GPU驱动和CUDA工作负载。EKS通过EC2节点支持GPU工作负载,GPU Operator简化了驱动的安装和管理,确保容器的稳定运行。选择EKS托管节点组可以降低运维负担。同时,结合Kiro和AWS MCP,平台团队能够通过自然语言进行集群巡检和问题排查,从而提升运维效率。
cpu_tuple_cost, cpu_index_tuple_cost, and cpu_operator_cost are three of the constants the planner uses to price a query, and the single most useful thing to know about all three is that you...
完成下面两步后,将自动完成登录并继续当前操作。