分享 DeepSeek V4 Flash TP2 模型的并发调优经验:多并发时第二个 Prefill 等待过久,原因是 vLLM 的 --long-prefill-token-threshold 参数默认值 2048 过大,导致首个 Prefill 独占调度。调小该值可增加多 Prefill 调度机会。实测 1024 最佳,8 并发下后续 Prefill 等待从 90 秒降至约 7 秒,总吞吐仅降 2.5%;降至 512 则吞吐损失超 15%。
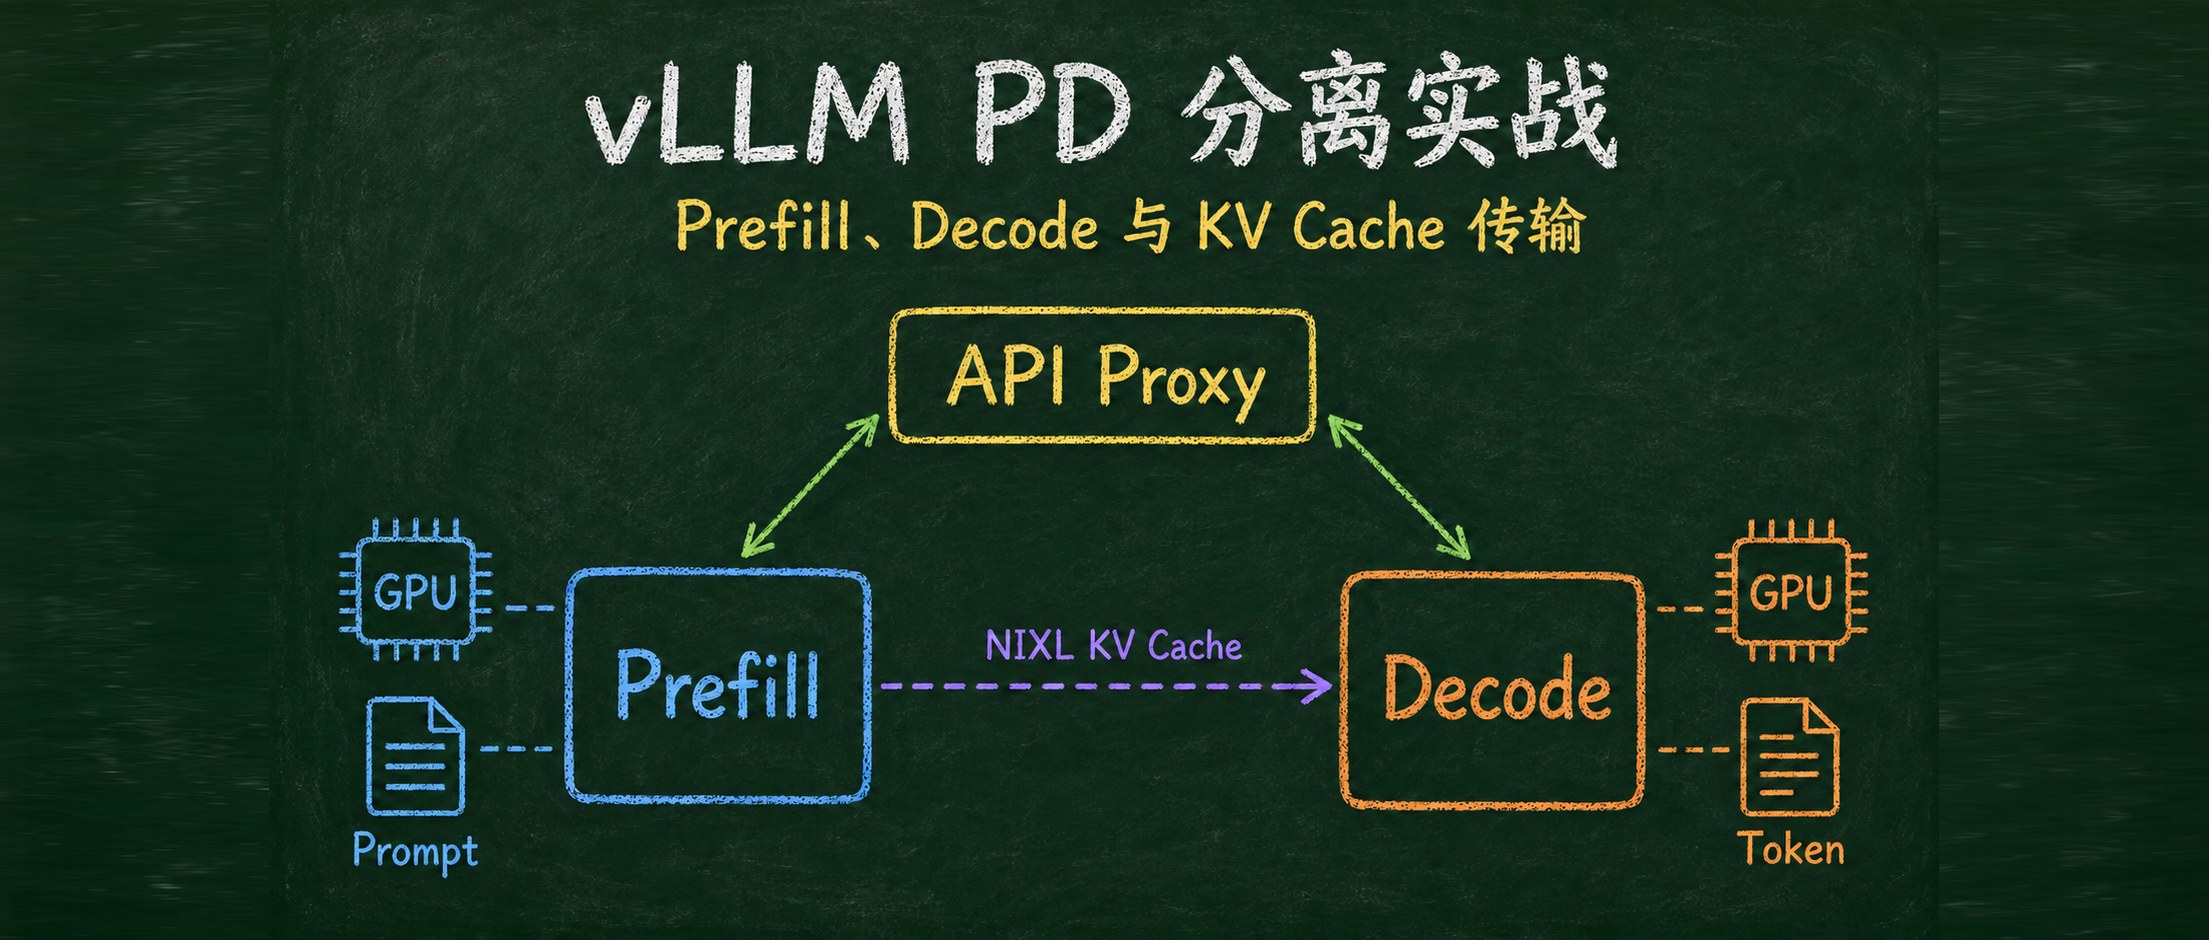
本文介绍如何用 vLLM、NixlConnector 和 toy Proxy 搭建单容器 PD 分离 Demo:Proxy 将请求改写为 max_tokens=1 发给 Prefill,Prefill 计算 Prompt 并生成 KV Cache,返回临时 Token 和传输元数据;Proxy 丢弃 Token,携带 kv_transfer_params 转发给 Decode;Decode 通过 NIXL 从 Prefill 拉取 KV Cache 并继续生成,结果经 Proxy 返回客户端。日志中 Num successful transfers=1 可确认传输成功。
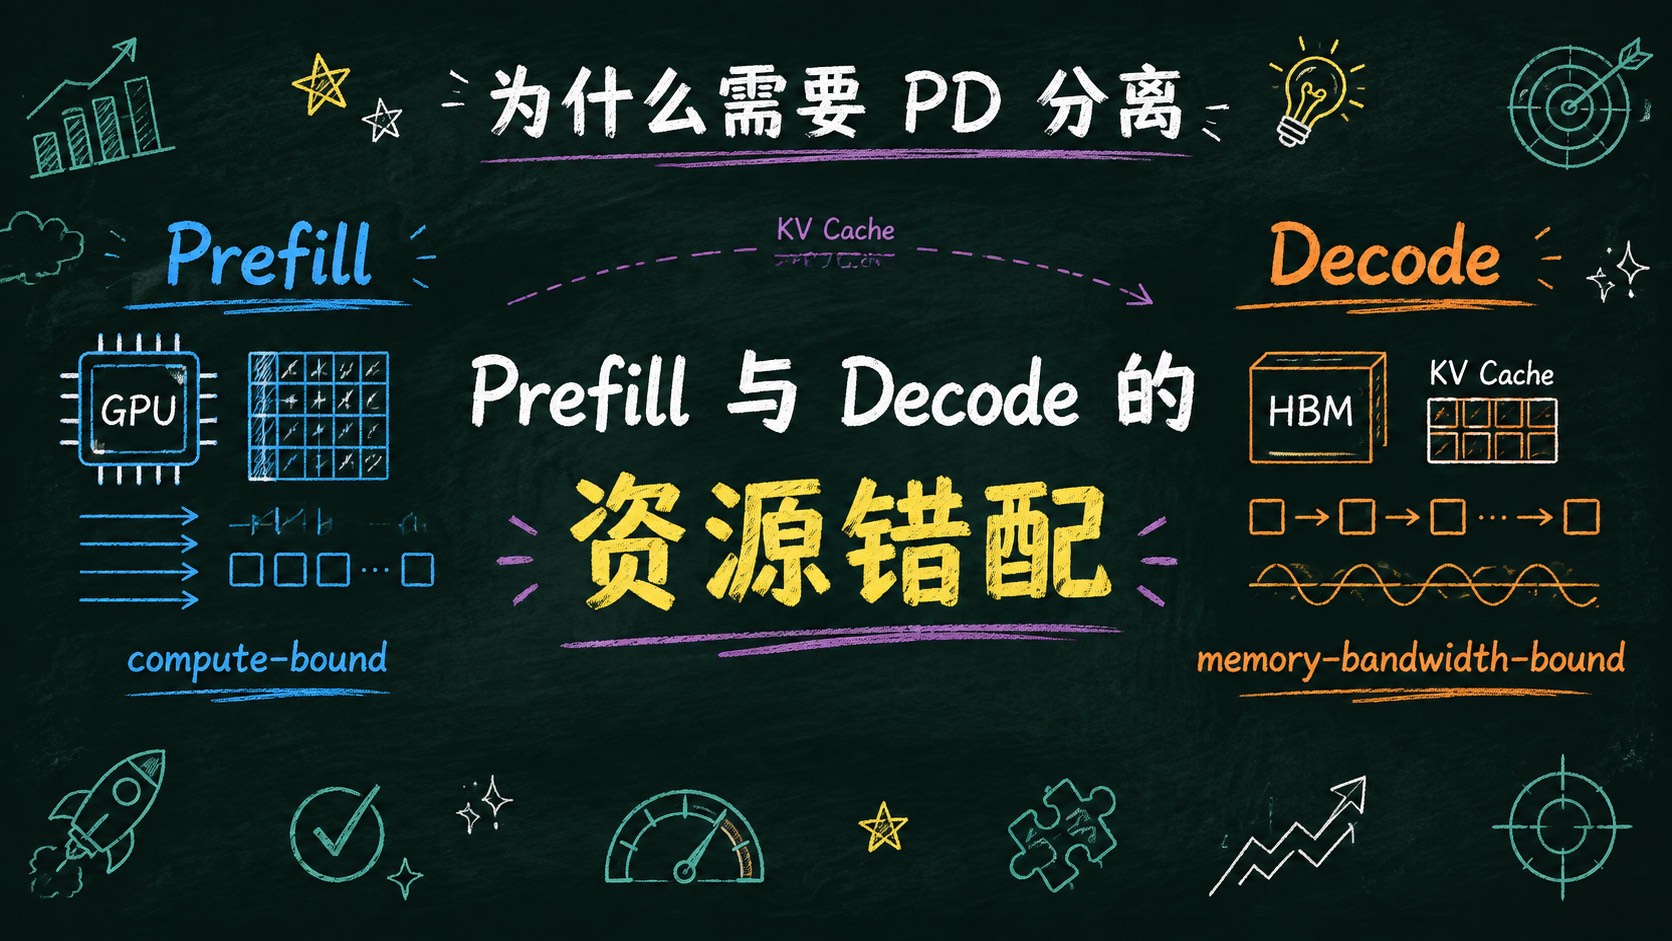
PD分离将LLM推理的Prefill(计算密集)与Decode(显存带宽密集)阶段拆分至独立资源池,以隔离干扰、优化TTFT和ITL,并允许按需配置硬件。它通过KV Cache传输衔接两阶段,但增加调度、网络和资源开销。仅当共置优化(如Chunked Prefill)无法满足SLO或资源需求不对称时,才值得采用。
vLLM 是加速大语言模型推理的框架,通过高效KV缓存管理减少内存浪费。文章提供Helm图表部署配置,并演示解耦预填充示例:启动预填充和解码两个实例,通过代理服务器传输KV缓存,实现请求处理,包含安装依赖、启动服务及测试请求的完整流程。
本文探讨了大模型推理的工程差异,强调训练与推理的不同需求。推理分为Prefill和Decode两个阶段,前者关注计算吞吐,后者关注延迟。KV Cache的使用显著提高了推理效率,减少了计算复杂度。文章还介绍了Continuous Batching和Prefill/Decode分离的优势,强调了高并发场景下的显存管理和性能优化策略。
本文探讨了大模型应用中PD分离部署的必要性,分析了Prefill与Decode阶段的资源需求差异,建议将两者部署在不同设备上以优化性能。同时介绍了vLLM的连接器和部署过程,强调了缓存共享与负载均衡的重要性。
vLLM 是一款加速大语言模型推理的框架,解决了内存管理瓶颈,实现了 KV 缓存内存的高效利用。文章介绍了如何使用 vLLM 进行预填充和解码,并利用两个 GPU 实例进行 KV 缓存传输,以提升模型性能。
vLLM 是一款加速大语言模型推理的框架,解决了内存管理瓶颈,并支持 KV 缓存。文章介绍了如何使用 vLLM 和 LMCache 进行预填充和解码,包括环境变量设置和示例代码。
本研究提出了一种名为SpecPrefill的无训练框架,通过轻量级模型预测重要令牌,显著提高大型语言模型的首次令牌时间(TTFT)。结果表明,SpecPrefill在多种任务中可将最大端到端QPS提升7倍,TTFT改进达到7.66倍。
本研究提出了XY-Serve系统,针对生产级大语言模型服务系统中的动态性问题,通过混合预填充/解码/验证调度机制,显著提高了AI加速器上的效率,端到端吞吐量提升高达89%。
LLM推理过程分为Prefill阶段和Decode阶段,Prefill阶段计算密集,Decode阶段生成token。评估指标为TTFT和TPOT,要求90%的请求的TTFT和TPOT值都小于等于0.4s和0.04s。PD分离优化了TTFT和TPOT指标,Prefill阶段限制Batch Size,Decode阶段增大Batch Size。
完成下面两步后,将自动完成登录并继续当前操作。