文章介绍在16GB显存的RTX 5060 Ti上运行16.46GB的Qwen3.8-27B Q4_K_M模型:仅将682MB词嵌入表留在内存,其余主干权重与输出头全部驻留显存以避免换页;对757个解码算子逐一定时,实施RMSNorm寄存器预取、Q6_K/IQ3_S零共享内存算子、硬件FP16转换、Gated DeltaNet双行流水线、精简冗余节点并启用轮询同步五项CUDA优化。最终解码达24.94 tok/s,反超llama.cpp约3.4%,生成Token与Logits逐位一致。
Strata 能在普通电脑上运行 Qwen3.8-Flash-Next。这是一个又大又聪明的 AI 模型,通常 […]
作者在RTX 4090 24GB上以Strata替代Ollama推理Qwen3.8-Flash-Next(512专家MoE),专家权重驻留内存、GPU仅缓存热专家,配256K上下文与int8 KV。解码中位约100–110 tok/s,冷预填充约2500–2800 tok/s。官方GSQ-RCO IQ3_S量化优于Unsloth,整体探索时间从12分钟降至8分钟。服务单请求串行,两三人使用尚可。
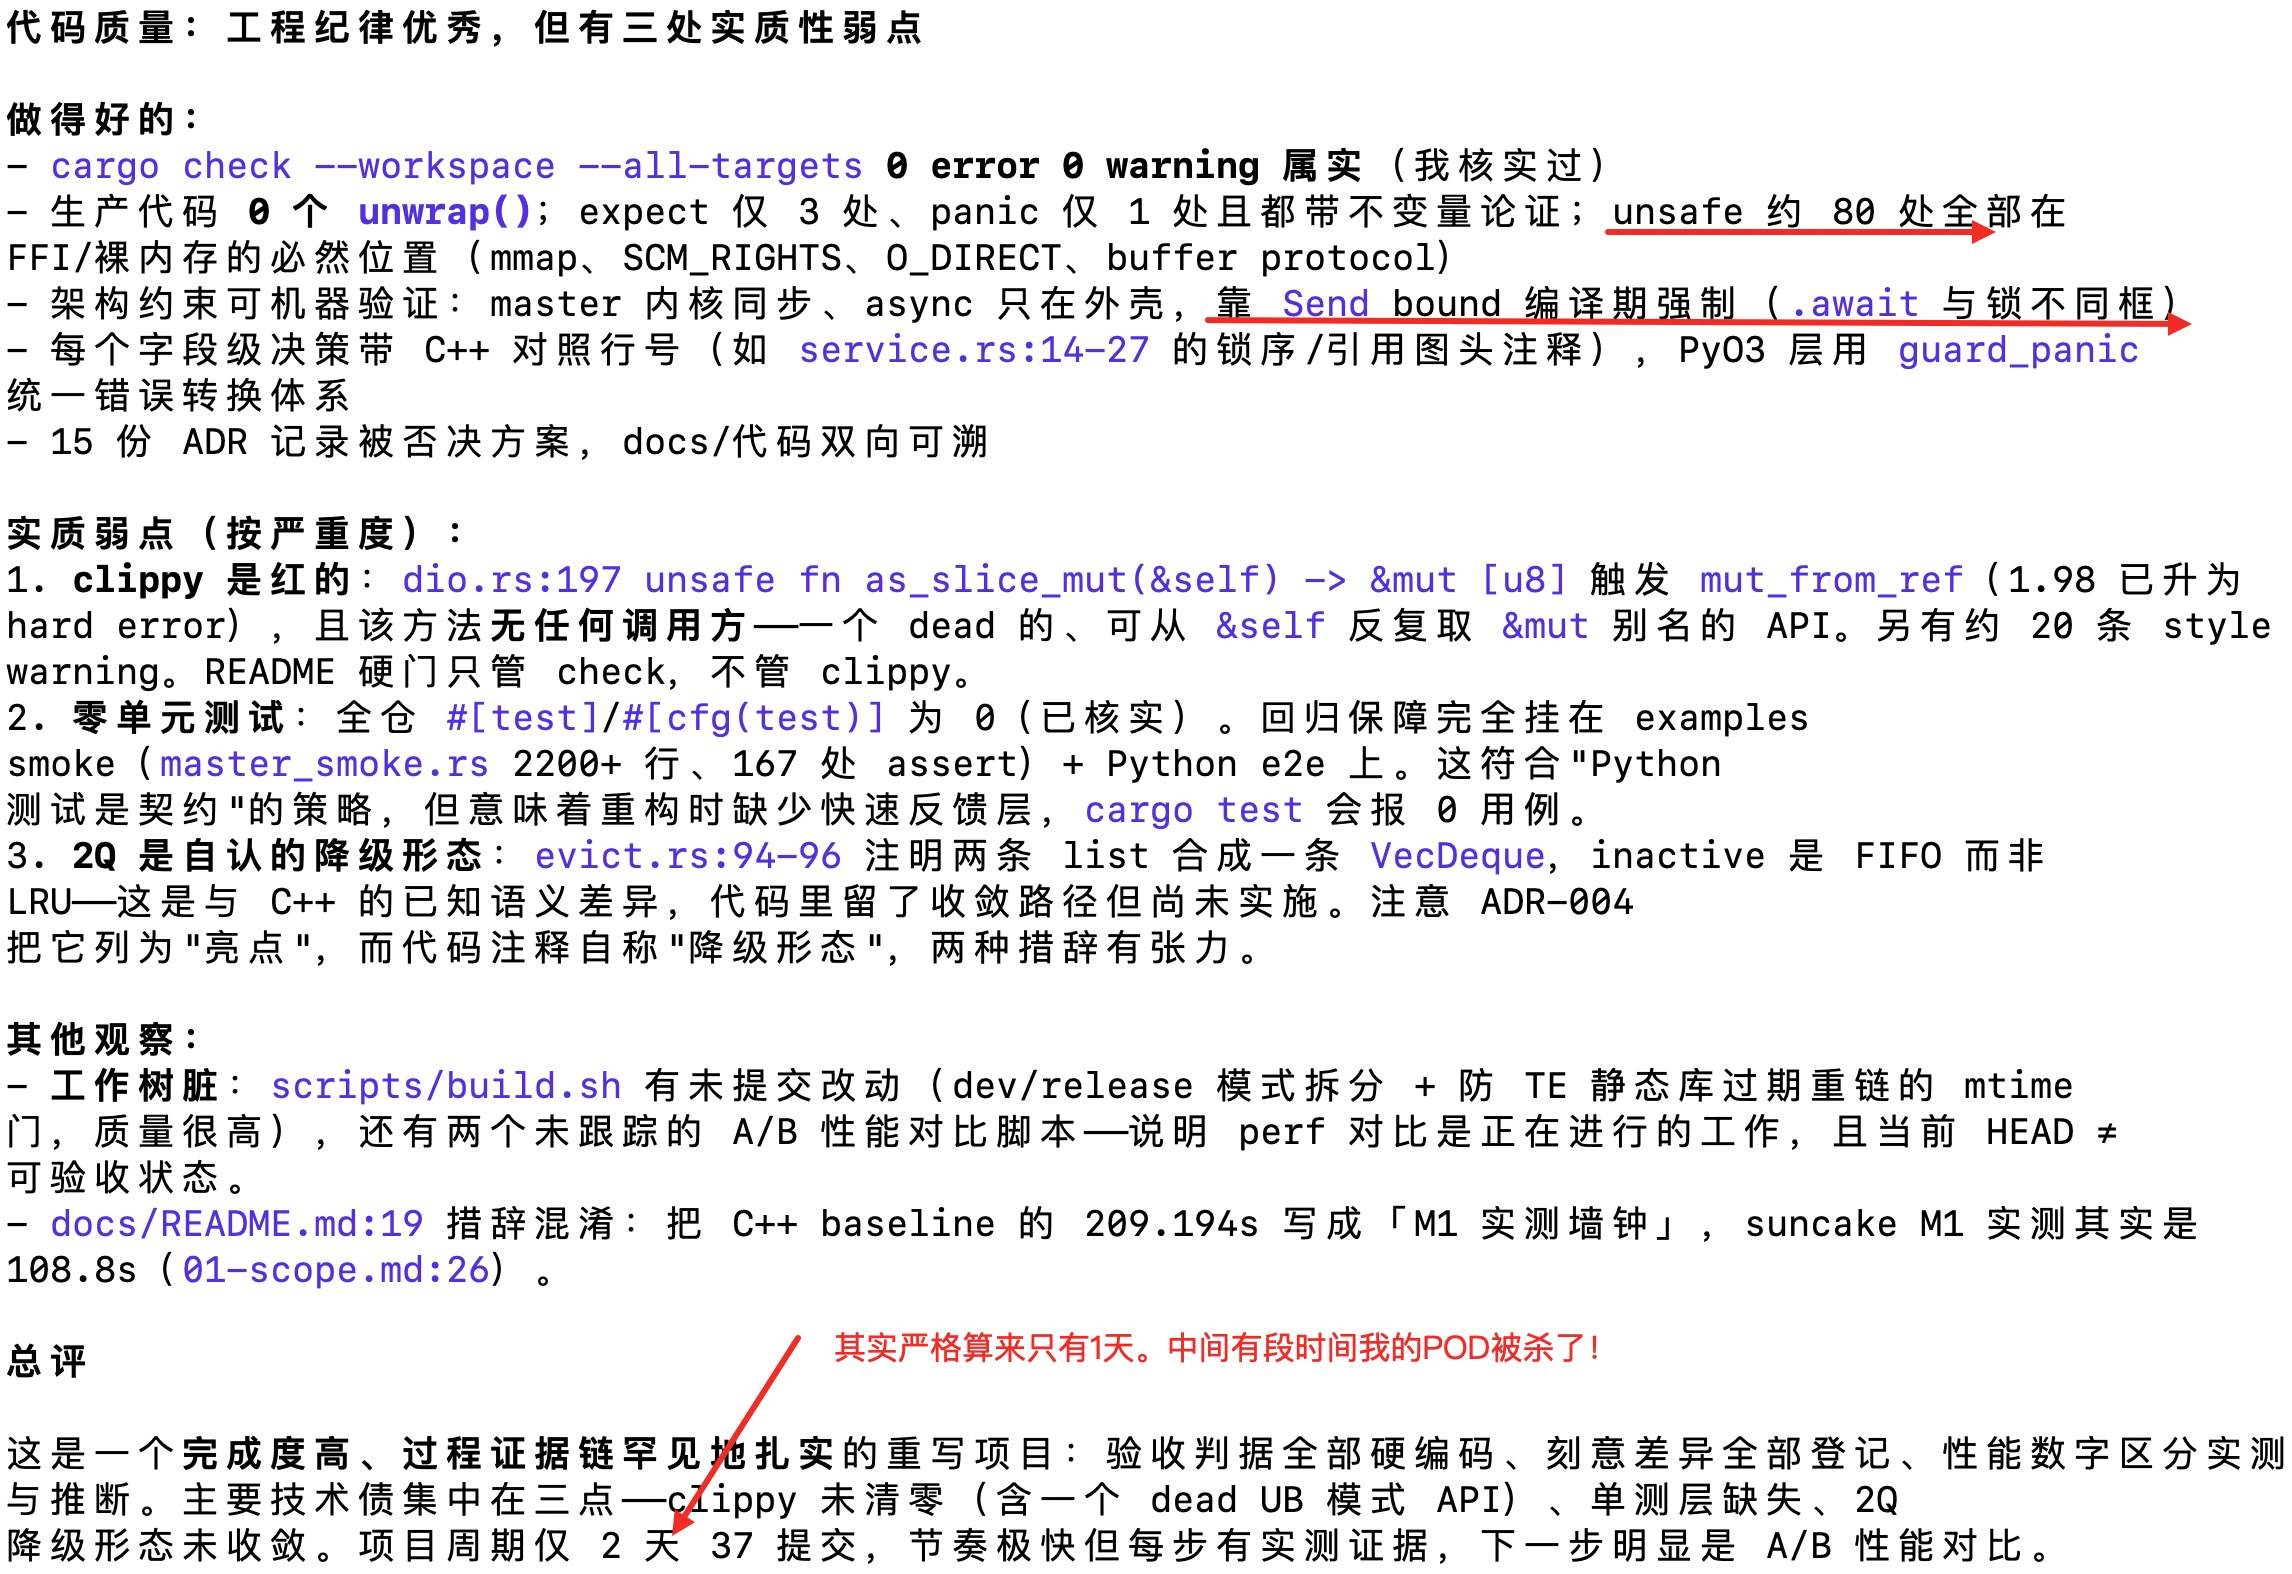
本文介绍作者用Rust重写Mooncake存储模块为Suncake项目,通过Qoder和Qwen3.8从零开发,仅用37个提交完成。相比C++版,性能提升显著:墙钟时间约为C++的52%,get尾部延迟改善数百倍,线程数从266降至21。作者认为Rust的async/await更适合IO密集型应用,并指出项目零单测等弱点。
阿里发布旗舰模型Qwen3.8-Max新版本,性能显著提升,尤其在编程和办公领域。在CodeArena榜单中得分1691,居全球第一,且性价比高,每百万Tokens仅5美元。该模型参数达2.4万亿,支持100万上下文,已上线API服务。
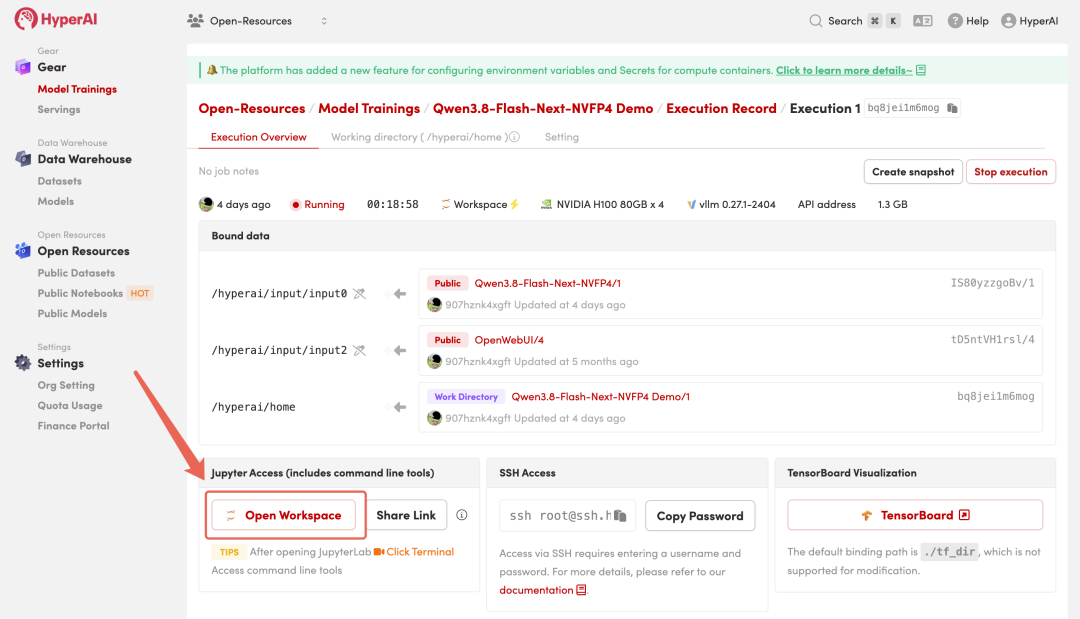
阿里通义千问发布Qwen3.8-Flash-Next,作为Qwen4架构预览,采用多模态MoE设计,通过混合注意力、门控残差和N-gram嵌入提升效率,主模型125B参数,激活仅6B,训练成本降至1/9,支持262K上下文,可扩展至百万Token,并已上线HyperAI教程供一键部署体验。
阿里巴巴发布Qwen3.8-Flash,一款1250亿参数的开源多模态MoE模型,作为Qwen4的架构预览。该模型在编码和办公任务上性能优越,训练资源仅需同类模型的九分之一,成本更低。它支持26万token上下文,可扩展至百万,并已在Hugging Face和ModelScope开放。开发者反应不一,有人称赞其能在消费级硬件运行,也有人认为本地模型尚不足以替代远程服务。
阿里云下调Qwen3.8-Flash调用价格,输入降至0.8元/百万,输出降至2.7元/百万,调整后比智谱GLM-5.3-Flash原价便宜0.1元,但智谱当前限时5折,价格仍具优势。阿里云调价对标智谱原价,两周后或显优势。
千问办公首发上线Qwen3.8-Flash模型,推出标准模式,提升速度并降低Token消耗。新模型性能超越Claude Opus 4.6,经办公场景优化,单任务生成速度提升约100%,Token消耗减少75%。未来仅分标准和高级模式,95%日常任务用标准模式即可完成,打破性能、成本和速度的“不可能三角”。
阿里通义千问发布Qwen3.8-Flash-Next开源模型,采用MoE、GDN、QSA、Gated Residual和N-gram Embedding等创新架构,125B参数仅激活6B,成本为前代九分之一,性能超越397B旗舰。训练中发现Muon优化器下Batch Size Warmup无效,可节省18.8%算力,引发行业反思。
SGLang 宣布首日支持通义千问 Qwen3.8-Flash-Next。该模型为 Qwen4 架构预览版,采用 GDN 线性注意力与 QSA 稀疏注意力混合架构,总参数 125B,每 token 激活 6B。SGLang 针对 QSA 索引缓存、MTP 推测解码索引复用、门控残差算子及 N-gram 嵌入主机内存卸载进行优化,降低显存占用并提升长上下文推理吞吐。
Muse-Glimmer-30B是Meta推出的300亿参数多模态智能体模型,支持本地运行,融合推理、工具调用和多模态理解,性能优异。文章还介绍了HyperAI平台更新的数据集、教程及社区内容,涵盖人物画像、车辆检测、分子处理、语音识别等AI资源。
阿里开源Qwen3.8-27B模型,在编程等任务上超越Claude旗舰,仅需一张二手3090显卡即可运行。其Sharp聊天模板优化了性能,引发对云端订阅价值的质疑。但测试条件存疑,结果可能仅在特定配置下成立,开源与闭源模型竞争仍存变数。
本文介绍如何用三条命令将Qwen3.8-27B模型配置为本地AI编程助手。首先检查硬件(建议24GB显存和32GB内存),然后安装Ollama、下载模型,最后在OpenCode中启动。测试显示模型能快速构建并测试应用,适合初学者快速体验本地AI编程,无需复杂配置。
Qwen3.8-27B开源模型发布,拥有270亿参数,强化推理、编程与Agent能力,在代码、多模态和智能体评测中表现优异,接近顶级闭源模型。支持图像视频理解及灵活思考控制,HyperAI已上线教程供开发者快速调用。
阿里开源Qwen3.8-27B模型,270亿参数,支持262K上下文,性能接近闭源旗舰。社区实测在双RTX 3090上达105 tok/s,通过量化、MTP加速等技术实现。模型Apache 2.0协议,48小时下载86万次。但速度受场景、配置影响大,多卡未必更快,且长上下文需量化KV缓存牺牲质量。
本地AI代理实验:用户用799美元Mac mini M4 24GB运行Hermes Agent和Qwen3.8-27B模型,夜间花1小时42分钟生成AI新闻播报,全程本地推理、零API费用。对比RTX 5090,速度慢30倍但成本低,电费不足一美分。文章分析显性成本(硬件、电费)与隐性成本(调试时间、折旧、机会成本),并质疑模型基准真实性,探讨速度与数据主权的权衡。
mlx-dspack项目在Mac上通过投机解码技术,将Qwen3.8-27B模型推理速度提升至3倍,8-bit量化下性能优于4-bit。项目基于DeepSeek的DSpark和z-lab的DFlash,支持自动调参优化草稿长度。实测显示8-bit加投机解码比4-bit普通解码快39%,但加速效果受硬件、量化方式和MLX版本影响,长上下文和内存限制仍是瓶颈。
阿里巴巴发布Qwen3.8-27B,与3.6版架构相同,但性能大幅提升,编程测试领先,部分超越闭源旗舰。提升源于训练数据优化和推理深度调节,代价是token消耗和耗时增至三倍。用户需权衡智能与成本,引发对“性能提升”本质的讨论。
Qwen3.8-27B开源,拥有270亿参数,支持原生多模态和262K上下文,可扩展至100万Token。在SWE-bench Pro和QwenSWEBench上超越Claude Opus 4.6 Max,Agent和多模态评测表现优异。内置推理档位可调,支持关闭Thinking模式,默认开启preserve_thinking。量化后可在24GB显存显卡运行,支持Transformers、vLLM等部署。
完成下面两步后,将自动完成登录并继续当前操作。