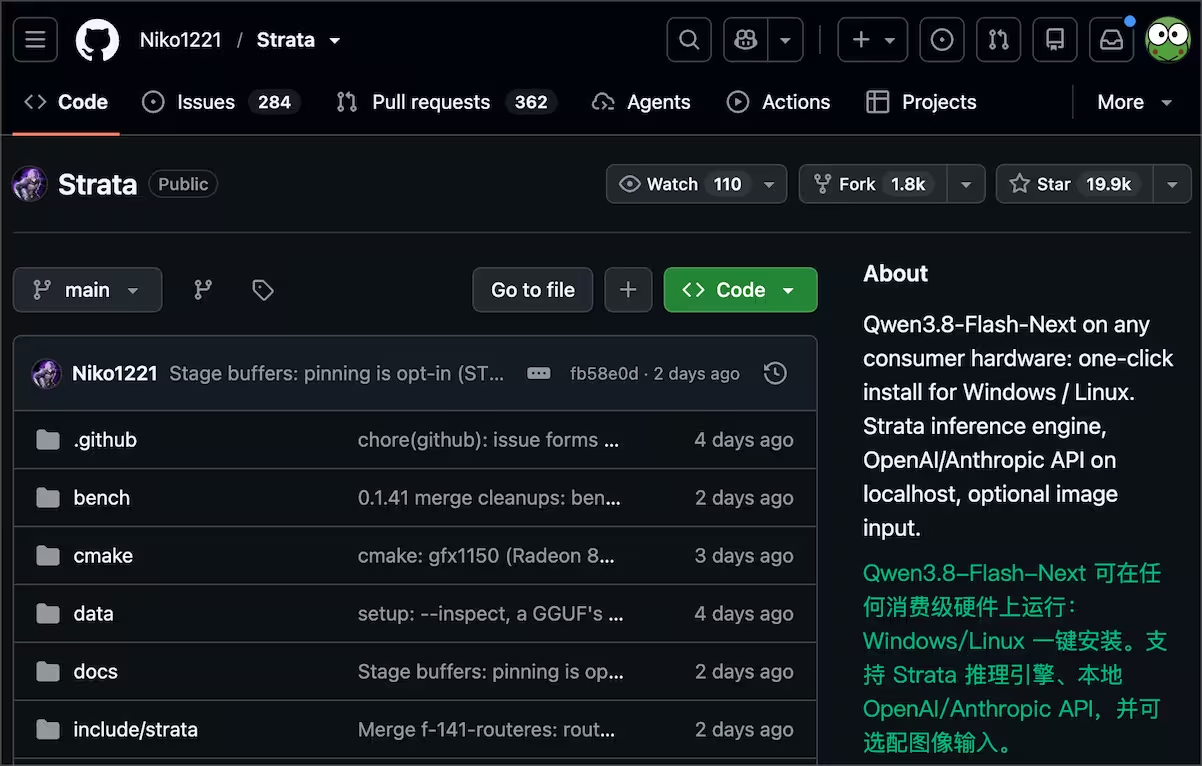
开源项目 Strata 支持在普通电脑本地运行千亿参数大模型 Qwen3.8-Flash-Next,通过将部分模型放入内存和固态硬盘,8GB 显存即可运行,但内存需 32GB 起步、推荐 64GB。生成速度约 20 至 70 tok/s,40 以上可用,无需 API 费用,AMD 用户可用 gufo。
作者在RTX 4090 24GB上以Strata替代Ollama推理Qwen3.8-Flash-Next(512专家MoE),专家权重驻留内存、GPU仅缓存热专家,配256K上下文与int8 KV。解码中位约100–110 tok/s,冷预填充约2500–2800 tok/s。官方GSQ-RCO IQ3_S量化优于Unsloth,整体探索时间从12分钟降至8分钟。服务单请求串行,两三人使用尚可。
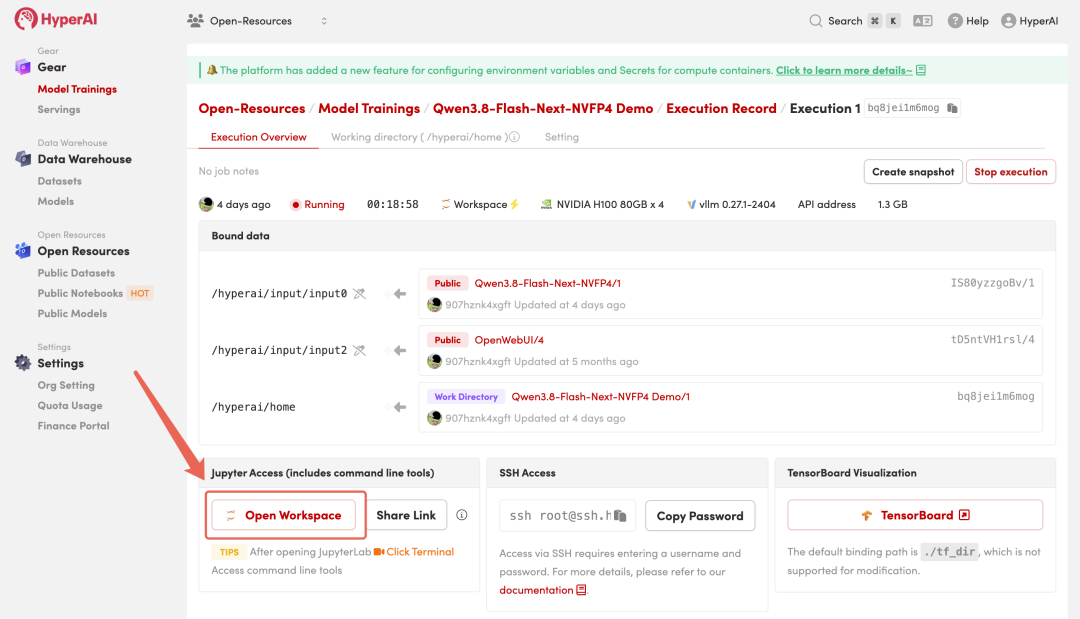
阿里通义千问发布Qwen3.8-Flash-Next,作为Qwen4架构预览,采用多模态MoE设计,通过混合注意力、门控残差和N-gram嵌入提升效率,主模型125B参数,激活仅6B,训练成本降至1/9,支持262K上下文,可扩展至百万Token,并已上线HyperAI教程供一键部署体验。
TensorSharp 是纯 .NET LLM 推理引擎,三天内接入 GLM-5.3-Flash 和 Qwen3.8-Flash-Next 新架构。它支持进程内推理,性能上 decode 速度翻倍,prefill 持平,并强调正确性验证和部署便捷性。对 .NET 团队,这标志着前沿模型架构跟进加速,值得纳入 PoC 评估。
阿里通义千问发布Qwen3.8-Flash-Next开源模型,采用MoE、GDN、QSA、Gated Residual和N-gram Embedding等创新架构,125B参数仅激活6B,成本为前代九分之一,性能超越397B旗舰。训练中发现Muon优化器下Batch Size Warmup无效,可节省18.8%算力,引发行业反思。
完成下面两步后,将自动完成登录并继续当前操作。