通衍灵智依托北京通用人工智能研究院,探索以参数化学习和持续进化为核心的Personal AI:在共享基础模型上,用轻量Personal LoRA承载个人与企业的专属能力,并通过RSI递归自我改进机制筛选有效反馈、增量更新、评估回滚,避免错误积累;同时以TIP训推并行和Paged LoRA优化训练与推理成本。目标是让企业经验沉淀为可迁移的智能资产,降低对单一模型底座的依赖。
谷歌开源Harness²,一种面向Agent的脚手架层递归自我改进方法。它通过双层递归解决无标准答案和过拟合难题:任务级采用提议-探测-合成流程,对比执行轨迹筛选有效修改;改进级将调试经验存入经验库,供后续任务复用。在WorkBuddy-Bench等基准上,GLM-5提升11.5分并反超Gemini 3.5 Flash,经验库还能跨领域迁移涨分。
谷歌歌刚刚发布了开源Harness²的RSI框架,它不动模型权重,只改模型周围的文件和配置,就能让智能体在没见过的任务上持续变强。 谷歌使用 Gemini 3.5 Flash 和 GLM-5 对它进行了法律、办公和专业工作基准测试。即使只修改一轮,其性能也优于原始版本。修改轮数越多,得分越高。 这
谷歌Gemini 4 Argon真正厉害的地方你没想到! 谷歌最新旗舰大模型Gemini 4 Argon全球上线,定价仅为对手五分之一。它能在百万字长文本中深度推理,帮程序员重构千万行代码,还能自主发现硬件漏洞。但分数背后的真相远比排行榜更值得深究。 ## Gemini 4 Argon跑分真相
RSI-Anything让AI先预测再行动,真正的难题才刚刚开始! RSI-Anything是Gen-Verse团队推出的开源递归自我改进框架。它串联起世界模型、外部评价与策略更新,尝试让AI在代码修复、浏览器自动化、实验室方案规划以及化学反应优化任务中持续迭代变强。这项工作最核心的突破,是把每一次行动的真
华为诺亚方舟实验室与UCL联合提出Memento 3智能体系统,以Claude Opus 5为底模,不更新权重,通过“代码即模型”让AI边玩边写规则与模拟代码并自我纠错。该系统在ARC-AGI-3的25款游戏183关全部通关,操作7518次,比人类少约56%,获满分RHAE;玩Pong时策略成熟后无需大模型推理,三局21:0。
多智能体自监督(MASS)让同一个模型分饰三角,从团队记录里自己教自己! 一个270亿参数的模型,没有任何人类标注,两轮自我迭代后每token得分涨到1.6倍。方法叫多智能体自监督(MASS),Sakana AI联合UC Berkeley做出来的。 想象你是一个初二学生,老师让你做一道没有标准答案的开放题:设计一个金融交易策略。
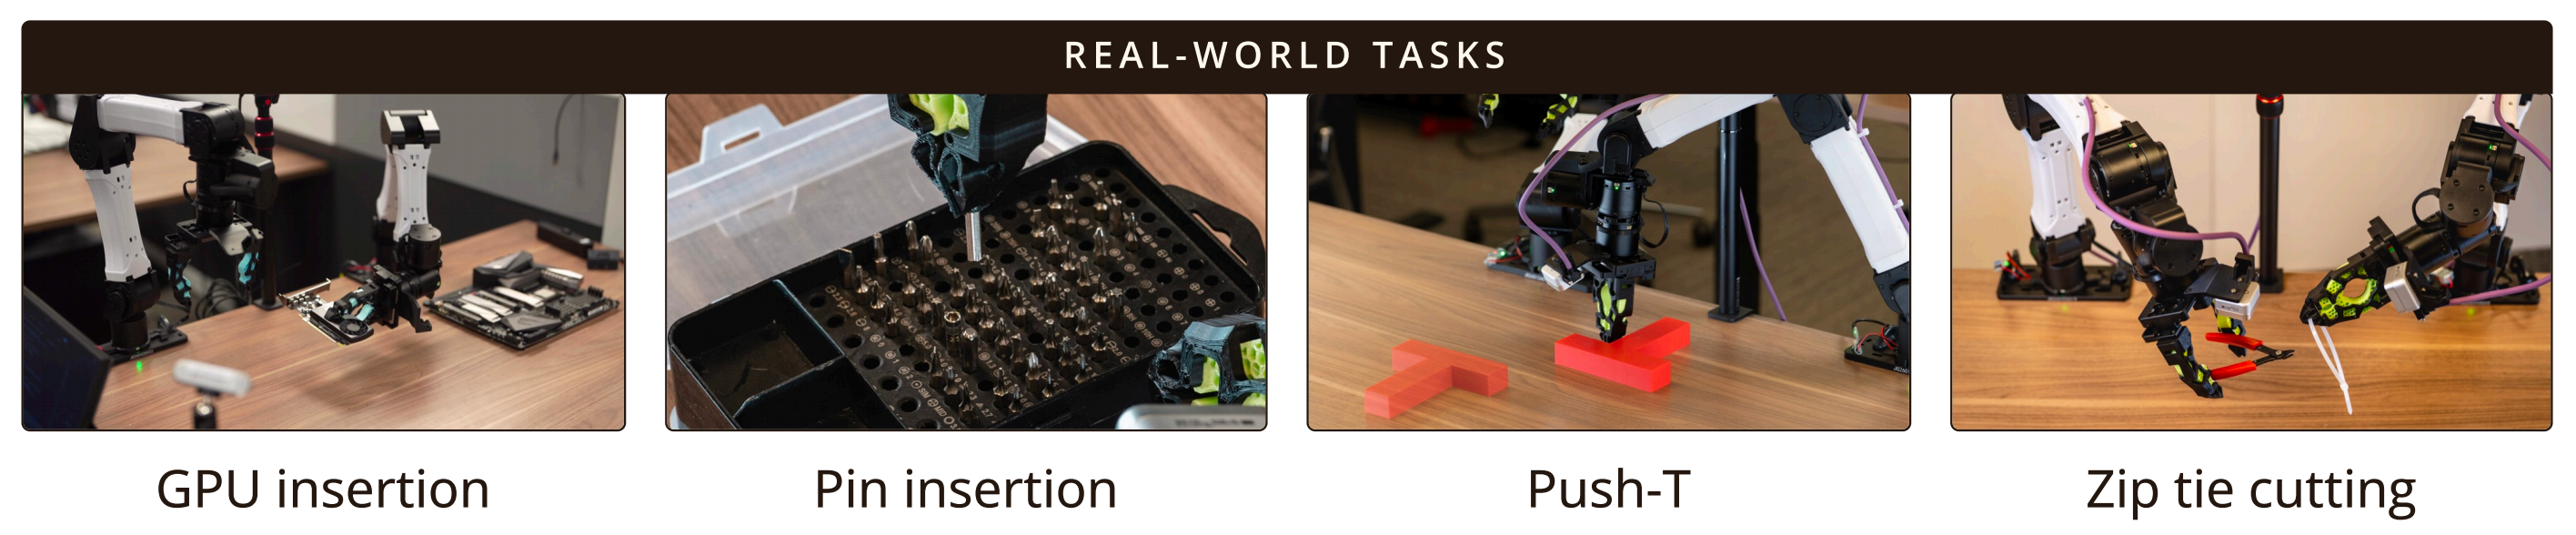
ENPIRE是面向真实机器人策略自改进的智能体框架,分两阶段:先由编码智能体根据少量人类示范自动构建安全约束、自动验证与自动复位环境;再让智能体在真实反馈下自主改进训练算法,并支持多机器人并行加速。该框架将搭建自动化设施本身也自动化,减少人工干预,适用于可程序验证与复位的任务。
辛顿等22位学者发表论文探讨AI递归自我改进。Anthropic数据显示,AI自主研发比例半年增长二十余倍,AI正加速进入AI研发流水线。AI研究员可复制、可同步升级,或带来数百万等效劳动力,理论上1.5年内AI进步提速10倍。但算力、数据、实验时间和科研边际收益递减构成现实约束,尚无证据证明智能爆炸已发生。
谷歌发布Gemini 4 Argon,在多项榜单登顶,性能超越Claude Opus 5.5和GPT-6 Astra,成本约为对手一半,支持百万Token输出,主打编程、金融、法律及网络安全防御。目前仅向审核过的网络安全团队开放。内部评价不一,有人质疑其编程实际表现和刷榜,谷歌予以否认。
一篇综述提出递归自我改进的工程框架,用HCI指数量化十类能力天花板,指出数学科学进展较快,而软件工程、工具使用等交互能力差距较大,最可能率先突破。论文定义自主性L1至L5五级,从执行改进到改写改进机制,并指出安全继承、自主性归因、可靠验证三大挑战。
2026年AI行业面临矛盾:OpenAI五年预计烧钱2780亿美元,但顶级模型连时钟识别正确率仅50.6%;闭源对开源领先仅3.3%,护城河脆弱。CFO严审AI支出,低成本开源模型蚕食高价模型市场。头部实验室仅剩两条出路:打价格战沦为云服务商,或押注递归自我改进实现AI自主迭代。AI智能呈碎片化,专业领域超神、日常场景翻车。千亿赌局成败最终取决于季度财报的真实利润。
前OpenAI成员阿尔梅达指出,大语言模型经RLHF训练后被优化为“助手”而非“自动化工具”,只会生成讨喜文本,导致模式坍缩,在真实决策任务中不可靠。他提出Jev纯决策模型,输出结构化判断而非文字,以类型安全架构解决自动化与递归自我改进难题,强调做对任务比算力更重要。
智谱GLM-5.3-Flash在超10万颗国产AI加速器上两周完成部署,吞吐提升3.2倍。GLM-5.3驱动的Infra Agent参与优化,定位精度与调度问题,将KV传输开销从30%降至1%以下。团队提出dense feedback机制,让AI理解性能变化原因。唐杰称递归自我改进的早期形态已现:模型优化系统,系统服务模型。
智谱创始人唐杰分享了RSI早期案例:GLM-5.3驱动的Infra Agent在超10万张国产芯片集群上从零搭建并优化生产级推理系统,不到两周将端到端吞吐提升至基线的3.2倍。该Agent能自主读取反馈、提出假设、修改代码并迭代,定位并修复了KV Transfer中Python GIL并发阻塞等问题。唐杰强调尚未实现RSI,目标设定与风险判断仍由人负责。
云知声发布U2-Flash,率先交出国产RSI早期答卷。该模型采用稀疏MoE架构,总参数266B、单次仅激活约10B,速度提升2.1倍,能力反超上一代U2。其核心是后训练闭环:自主生成任务、异步Agent RL、多教师在线策略蒸馏,让模型参与生成数据、分析轨迹乃至维护训练系统,已显露L3级自我改进特征。
谷歌提出Dream-RSI方法,让智能体将历史探索记录构建为虚拟回放模拟器,在决策树上反复演练搜索策略,无需改动底层模型即可大幅压缩大模型调用量,最高达162倍。该方法在算法工程、数学优化和GPU内核任务上均显著提升效率,核心是迭代上层搜索策略而非模型本身。
传统AI智能体因缺乏终止规则、纠错机制和记忆体系而越用越废。解决方案为“循环工程+图谱工程”双架构:循环工程通过量化终止条件、独立技能配置和四层外部校验闸门实现可控执行;图谱工程用SCHEMA.md、aliases.csv和结构化输出固化记忆;再配合动态工作流按节点状态差异化派单,以及元循环自动复盘、人工审批规则修改,最终形成可自我纠错、持续进化的多智能体系统。
AI圈热炒新词RSI(递归自我改进),指AI自主写代码、跑实验、改进下一代模型,思想可追溯至1965年“智能爆炸”设想。OpenAI、Anthropic已实现部分自动化研究。同时,Anthropic、OpenAI高管渲染AI末日风险,呼吁减速监管,英伟达黄仁勋则反驳。文章认为,末日论与反末日论之争,实质是算力、资本与产业利益的分配博弈。
生数科技发布世界模型Motus2,使机器人通过“行动—预测—评估”闭环实现自进化,并融合触觉与记忆。真机测试中,规划加强化学习将成功率提升10个百分点,触觉提升12.5个百分点。模型基于13万小时人类第一视角数据训练,具备L3“在世界中行动”能力,向自主智能体迈进。
完成下面两步后,将自动完成登录并继续当前操作。