Databricks与NVIDIA扩大合作,AI Runtime(AIR)正式可用。开发者可在无服务器NVIDIA GPU上使用NeMo、NGC容器和Nemotron工具包训练、微调并评估开源模型,无需管理GPU基础设施。AIR支持多节点分布式训练、自定义容器环境、MLflow实验追踪和Unity Catalog数据治理,并可通过Genie Code辅助调试。微调后的模型可经Databricks Model Serving部署用于实时推理,实现从企业数据到定制模型再到生产应用的完整流程。
Databricks宣布AI Runtime(AIR)正式可用,将全托管GPU基础设施引入其数据平台,使企业能在数据所在处训练大模型。AIR简化GPU配置与运维,支持秒级启动、多节点分布式训练,并原生集成Lakeflow与MLflow,便于调试和监控。它通过Unity Catalog统一治理数据访问,提供虚拟机级隔离和私有网络,并支持GPU成本追踪。Robinhood、Merck等数百家公司已用其训练和部署深度学习模型。
Databricks研究团队利用AI Runtime(AIR)支持AI Functions等模型研发,覆盖数十亿至近万亿参数模型的训练。AIR提供GPU健康检查与故障隔离、快速启动、MLflow实验追踪和Unity Catalog数据治理,并支持智能体驱动研究,使训练任务量增长8倍,提升实验效率。
FactSet 的 Text-to-Formula 系统将自然语言转换为 FactSet 查询语言,最初依赖 RAG,但复杂查询效果不佳。团队改用微调开源模型,每两到三周重新训练一次。借助 Databricks AI Runtime 的无服务器 GPU,无需配置基础设施,训练部署周期从数天缩短至数小时,并保持数据治理与 MLflow 实验追踪。
本文介绍优化大模型微调性能的方法。作者以Qwen 27B为例,指出GPU利用率98%仍具误导性,需用torch trace深入分析。通过融合内核(如Flash Linear Attention、causal-conv1d)减少算子数量,并将批次改为1D打包张量消除填充,训练时间从7小时44分降至1小时17分,提速6倍。
Flo Health利用Databricks构建隐私优先、AI评审驱动的后训练流程,将医疗安全性从34%提升至约61%,实用性从42%提升至76%,综合评分从16%升至47%。团队通过AI评审和合成数据将医疗标准转化为训练信号,并在H100 GPU上微调开源模型,以降低推理成本并增强模型控制力。
TinyFish在Databricks上构建了专用网络原生模型的训练、评估与部署流程,用于企业级网页智能体。模型采用监督微调并转向DPO,通过AI Runtime使用GPU,MLflow评估完整任务成功率,Model Serving负责生产部署。内部基准显示2178项任务成功1691项,成功率77.6%;15天内运行29万余次,单次成本约0.088美元。
GitHub migrated more than 800,000 lines of Copilot runtime code from TypeScript and Node.js to Rust in about 14.5 weeks using AI-assisted development. The incremental migration used N-API...
Databricks将向量搜索实现为原生SQL的top-k排序连接(NEAREST BY),而非依赖外部实时端点。它将批量向量搜索视为大规模连接,借助Photon的融合GEMM内核、SIMD距离函数和分组top-k聚合,并支持以Delta表存储的IVF索引加速近似查询,在十亿级向量上兼顾性能、容错与成本。
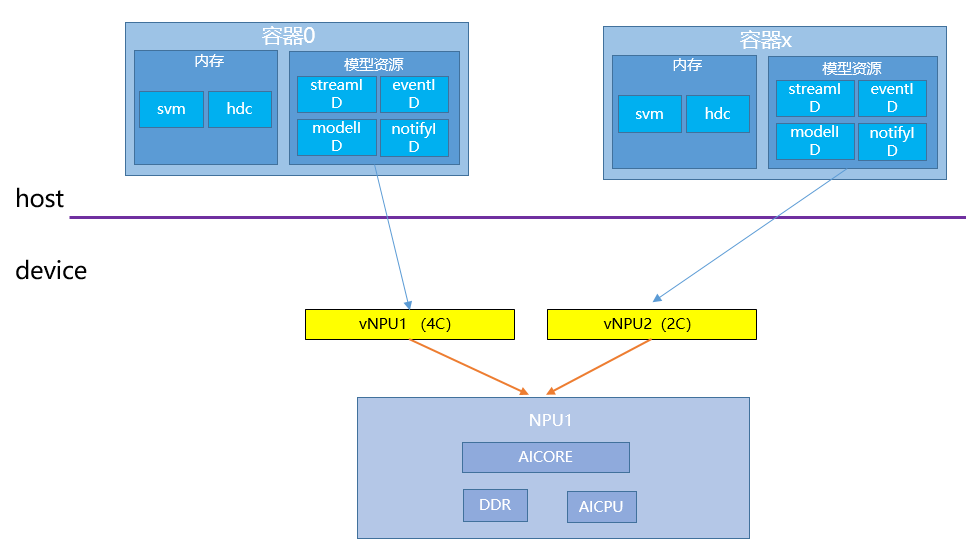
本文介绍昇腾Ascend 310P3 NPU的vNPU虚拟化使用方法。vNPU可将物理NPU划分为多个隔离实例,类比NVIDIA MIG。文章演示两种Docker运行方式:原生Docker需手动用npu-smi创建vNPU并挂载设备;Ascend Docker Runtime支持静态挂载(复用已创建vNPU)和动态虚拟化(启动时自动创建并释放实例)。通过环境变量指定设备与模板,容器内可正常使用npu-smi查看资源。
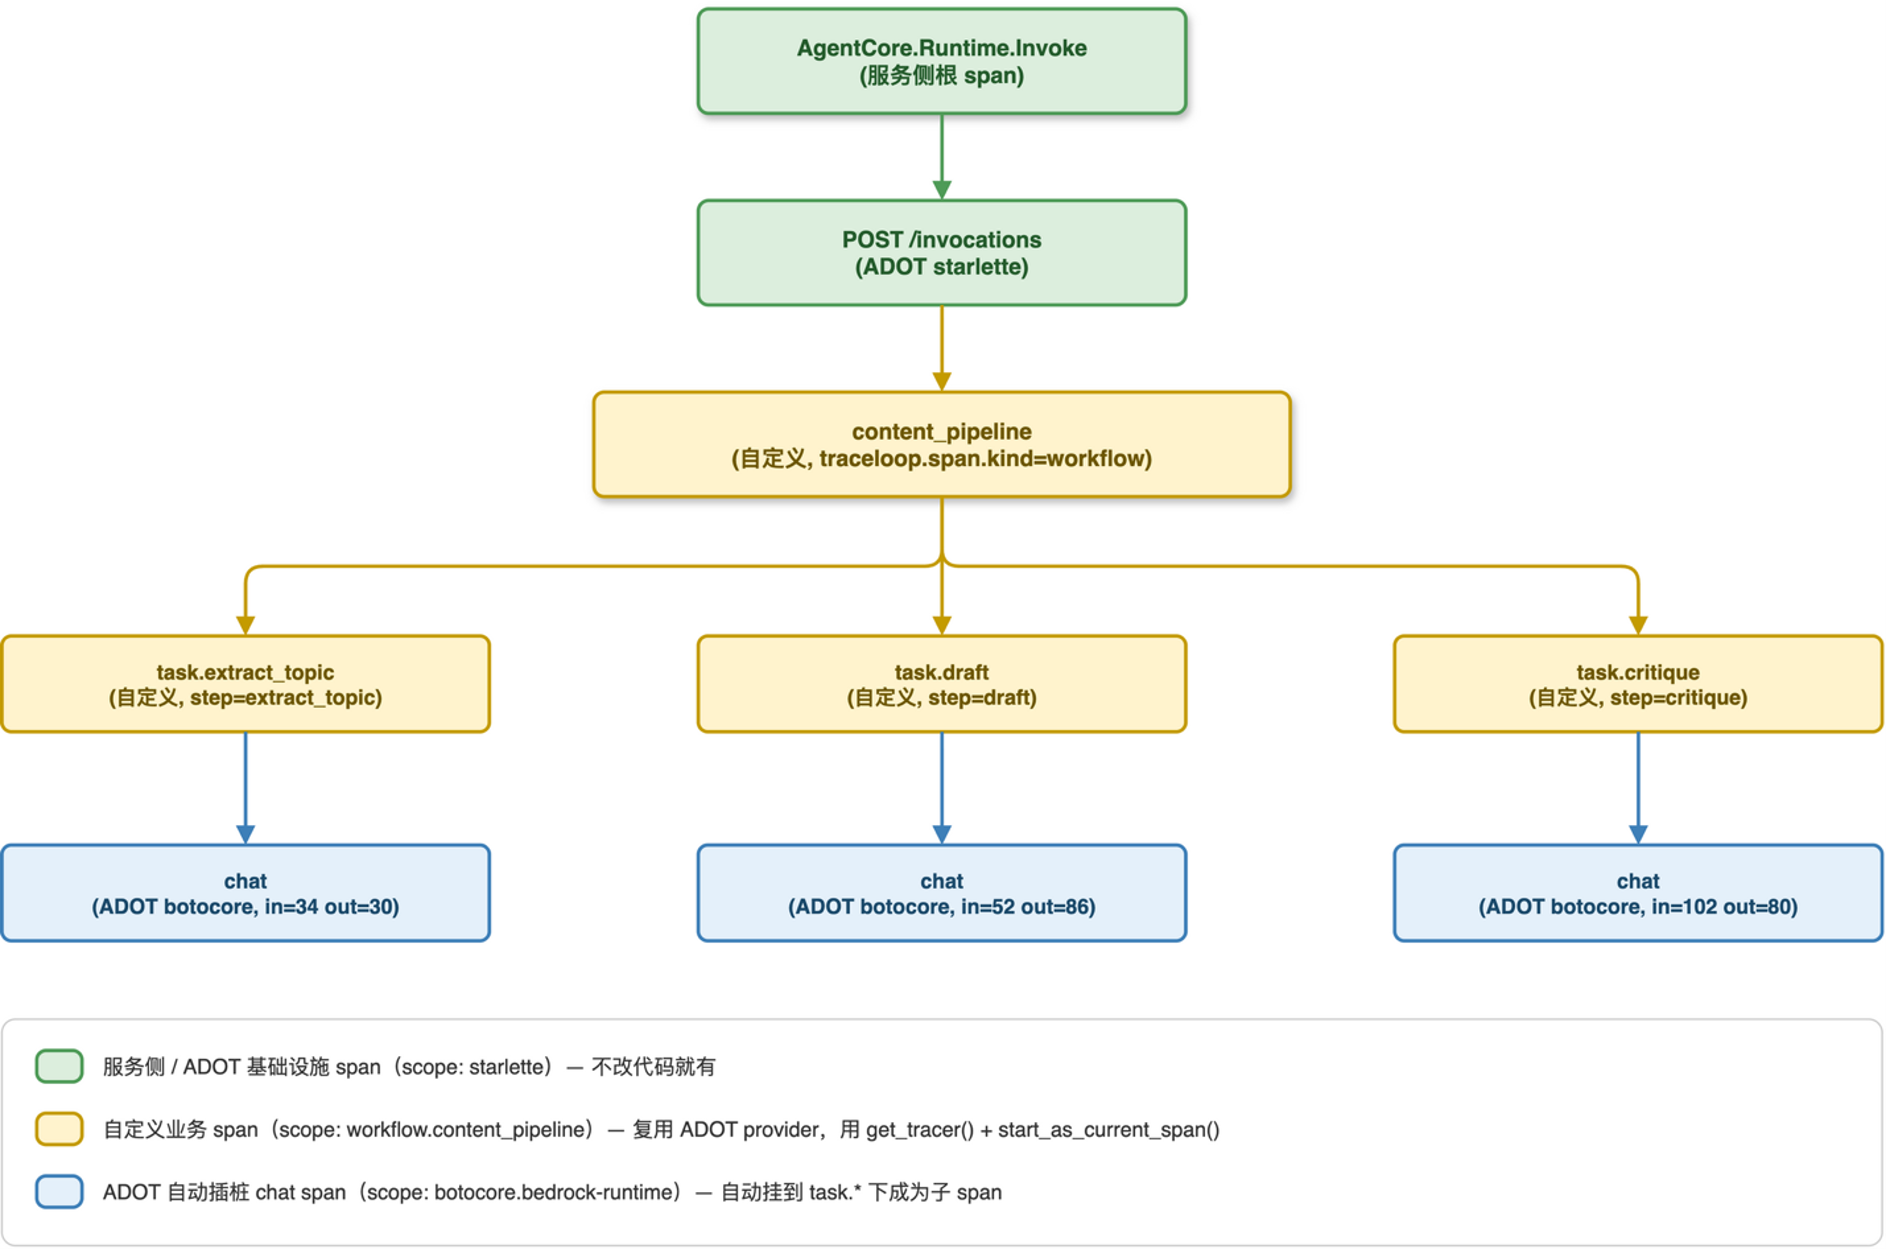
Amazon Bedrock AgentCore Runtime的可观测性基于OpenTelemetry,但自动插桩依赖aws-opentelemetry-distro。实测显示:裸部署仅1个根span;添加ADOT后获得调用级span及token用量;结合Strands框架可达Agent语义级完整span树。无框架工作流可用OTEL原生API自定义span/metric补全业务语义。跨资源trace拼接依赖ADOT注入trace context,否则各资源独立成树。
本文介绍Ascend 310P3 NPU的vNPU虚拟化使用方法。原生Docker需手动用npu-smi创建vNPU并挂载设备;Ascend Docker Runtime支持静态挂载(复用已创建vNPU)和动态虚拟化(启动时自动创建释放)。通过环境变量指定设备与模板,容器内可见310Pvir01实例,动态实例随容器退出自动回收。
在大规模AI训练中,GPU利用率取决于“好吞吐”,即有效计算时间占比。数据加载和检查点机制是关键:频繁异步保存检查点(如每30分钟)可减少故障恢复成本,提升好吞吐至91%;数据管道需重叠预取和本地缓存,避免GPU空闲。同时,检查点需包含数据位置和随机数状态,确保恢复后训练正确。
Microsoft has outlined an AI governance architecture spanning nine governance domains and four functions: policy, control, visibility, and proof. The approach connects policies with runtime...
WebCodex是一个基于Rust构建的AI Agent运行时,通过MCP协议连接GPT、Claude等线上Agent与本地设备,支持多设备、多项目协作及文件操作。其Server+Runner架构稳定高效,内存占用低,跨平台兼容。最新版本新增Computer Use、文件上传下载和多窗口协作功能,开发者已用它自举开发,未来期望构建跨设备云端Agent。
Tetragon v1.7.0通过Runtime Hooks在容器创建时同步通知agent,使policyfilter在进程执行前就绪,避免API server异步延迟导致的策略漏事件或误放行。支持CRI-O OCI hooks和containerd NRI两种方式,agent不可达时可按namespace配置fail-open或fail-closed。无hook时仅保证best-effort,不保证策略在容器启动前生效。
本文阐述HAProxy Runtime API与reload的运维分界:Runtime API通过stats socket可热修改服务器权重、状态、stick-table、ACL/Map条目及前端开关,但仅内存生效;结构变更如新增bind、frontend或规则树需修改配置并reload。Master CLI用于多进程管理,强调热改适合运行态调整,结构变更走文件,并需注意持久化纪律。
AI workflows have two needs that trade off directly. Running reliably in production requires persisting and distributing every step so it survives crashes, deploys, and restarts. But that same...
Kubernetes控制器利用本地缓存,通过list+watch机制与API服务器同步,避免直接查询。读取操作快速但可能返回旧数据,写入需处理资源版本冲突。索引可优化查询但增加内存开销,缓存可配置以平衡性能与资源。
ZGI Agent Runtime 已在 Gitee 开源,旨在解决 Agent 在生产环境中的执行、追踪和管理问题。文章强调,Agent 需具备任务记录、权限隔离、停止回滚等基础能力,而非仅靠智能。开源对国内团队有现实意义,建议先在测试环境跑通低风险任务验证稳定性。
完成下面两步后,将自动完成登录并继续当前操作。