小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
一分钟读论文:《旧轨迹里挖出新环境》

论文指出终端代码智能体后训练的瓶颈在于可执行环境而非轨迹数量。Terminal-Universe框架从已有轨迹中重建37.3k个环境,通过回放文件操作和补全缺失部分,并扩展单轮及多轮任务。SFT后,Terminal-Bench提升11.9分,EvoCode-Bench多轮提升13.8分,显示环境是可持续生成任务的关键资产。

一分钟读论文:《旧轨迹里挖出新环境》

Micropaper Micropaper · 2026-09-06T00:00:00Z
抄作业和改错题,哪个更能养出AI天才? - 蝈蝈俊

AI大模型训练分为预训练和后训练,后训练包括SFT(监督微调)和OPD(偏好纠正)。SFT直接提供标准答案,效率高但易导致灾难性遗忘和虚假对齐;OPD通过试错优化,效率较低。工业界通常先进行SFT再进行OPD。然而,真正的突破性智能需要自学,并依赖真实世界锚点,否则可能崩溃。未来超级智能可能无需教师,人类将变为见证者。

抄作业和改错题,哪个更能养出AI天才? - 蝈蝈俊

蝈蝈俊 蝈蝈俊 · 2026-09-02T00:53:00Z

本文介绍RLHF及其变体DPO、GRPO,旨在解决SFT无法表达相对偏好的问题。SFT仅最大化单一参考答案似然,无法区分多个合理回答的优劣。RLHF通过奖励模型和KL约束优化策略,但存在奖励过优化、对齐税等风险。DPO省去显式奖励模型和在线采样,GRPO在可验证奖励场景下省去critic。三者各有适用场景,对齐税是工程问题也是结构性风险。

【Transformer 与注意力机制】33|RLHF:从 PPO 到 DPO,再到 GRPO

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-08-08T00:00:00Z
如何使用SFT和QLoRA为AI代理定制大型语言模型

本教程介绍如何使用QLoRA对大型语言模型进行监督微调,以定制AI代理行为。通过Unsloth和Hugging Face工具,加载Qwen 1.5B模型,在本地用少量示例训练LoRA适配器,仅更新约4%参数,内存占用低。微调后模型响应更简洁、符合客服场景,适合资源有限环境。

如何使用SFT和QLoRA为AI代理定制大型语言模型

freeCodeCamp.org freeCodeCamp.org · 2026-08-06T16:13:59Z
Text-only LLM SFT 训练数据预处理:从收集到数据打包的完整指南

本文系统介绍纯文本LLM监督微调(SFT)训练数据预处理全流程,涵盖数据收集、格式统一、清洗过滤、去重、分布评估、混合策略及打包管理。强调数据质量优于数量,提供多任务采样、语种比例、难度分布等实操建议,并结合客户案例说明,旨在提升模型微调效果。

Text-only LLM SFT 训练数据预处理:从收集到数据打包的完整指南

亚马逊AWS官方博客 亚马逊AWS官方博客 · 2026-07-31T09:17:20Z
SFT战略定方向RL战术搞创新,3B模型靠平衡干翻闭源巨无霸

2026年,开源小模型通过平衡强化学习(RL)与监督微调(SFT),可超越闭源大模型。SFT提供战略方向,RL负责战术创新,两者失衡会导致模型僵化或混乱。GRPO、RULER、ART等工具优化平衡,使3B模型准确率从62%升至89%,突破纯SFT的72%上限,实现高效进化。

SFT战略定方向RL战术搞创新,3B模型靠平衡干翻闭源巨无霸

极道 极道 · 2026-07-23T00:24:00Z

南京大学的研究揭示了工具使用智能体在开放世界中的泛化脆弱性,提出了四级分层偏移框架,分析了SFT和RL训练范式的结构性弱点,并提出PAFT方法,通过引入扰动增强微调,提升模型的鲁棒性和泛化能力。

AI 范式雷达:《开放世界中的工具使用智能体——静态训练的脆弱性与修复》

Micropaper Micropaper · 2026-07-05T00:00:00Z

后训练是一个复杂的数据流水线,包含多个阶段,如SFT、奖励模型和策略优化。每个阶段旨在将预训练模型转变为更符合人类指令和偏好的模型。SFT主要调整回答格式,奖励模型提供训练信号,策略优化提升生成候选的能力。评测确保模型的安全性和准确性,整体流程强调数据回流和持续优化,以提升模型性能和可靠性。

【强化学习与大模型后训练】06|后训练全景:SFT → RM → RLHF → 评测

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-05-29T00:00:00Z

这篇文章讨论了监督微调(SFT)在语言模型训练中的重要性,强调数据质量、模板设计和损失函数的影响。SFT通过指令与回答对训练模型,确保模型能够有效生成助手回答。此外,SFT是后续强化学习(RLHF)的基础,强调样本去重、数据来源和模板一致性的重要性,以避免模型学习错误的行为模式。

【强化学习与大模型后训练】07|监督微调(SFT):指令数据、模板与训练细节

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-05-29T00:00:00Z
SFT别急着接RL!你的多模态大模型可能一直在“带伤训练”

PRISM团队的研究表明,监督微调(SFT)并未促进强化学习(RL),反而可能导致模型性能下降。研究提出了SFT、分布对齐和RL的三阶段流程,强调在多模态模型中,SFT引入的分布偏差需要单独处理。通过对抗博弈对齐分布,PRISM显著提升了模型在推理任务上的表现,修复了SFT的副作用。

SFT别急着接RL!你的多模态大模型可能一直在“带伤训练”

量子位 量子位 · 2026-05-17T03:42:11Z
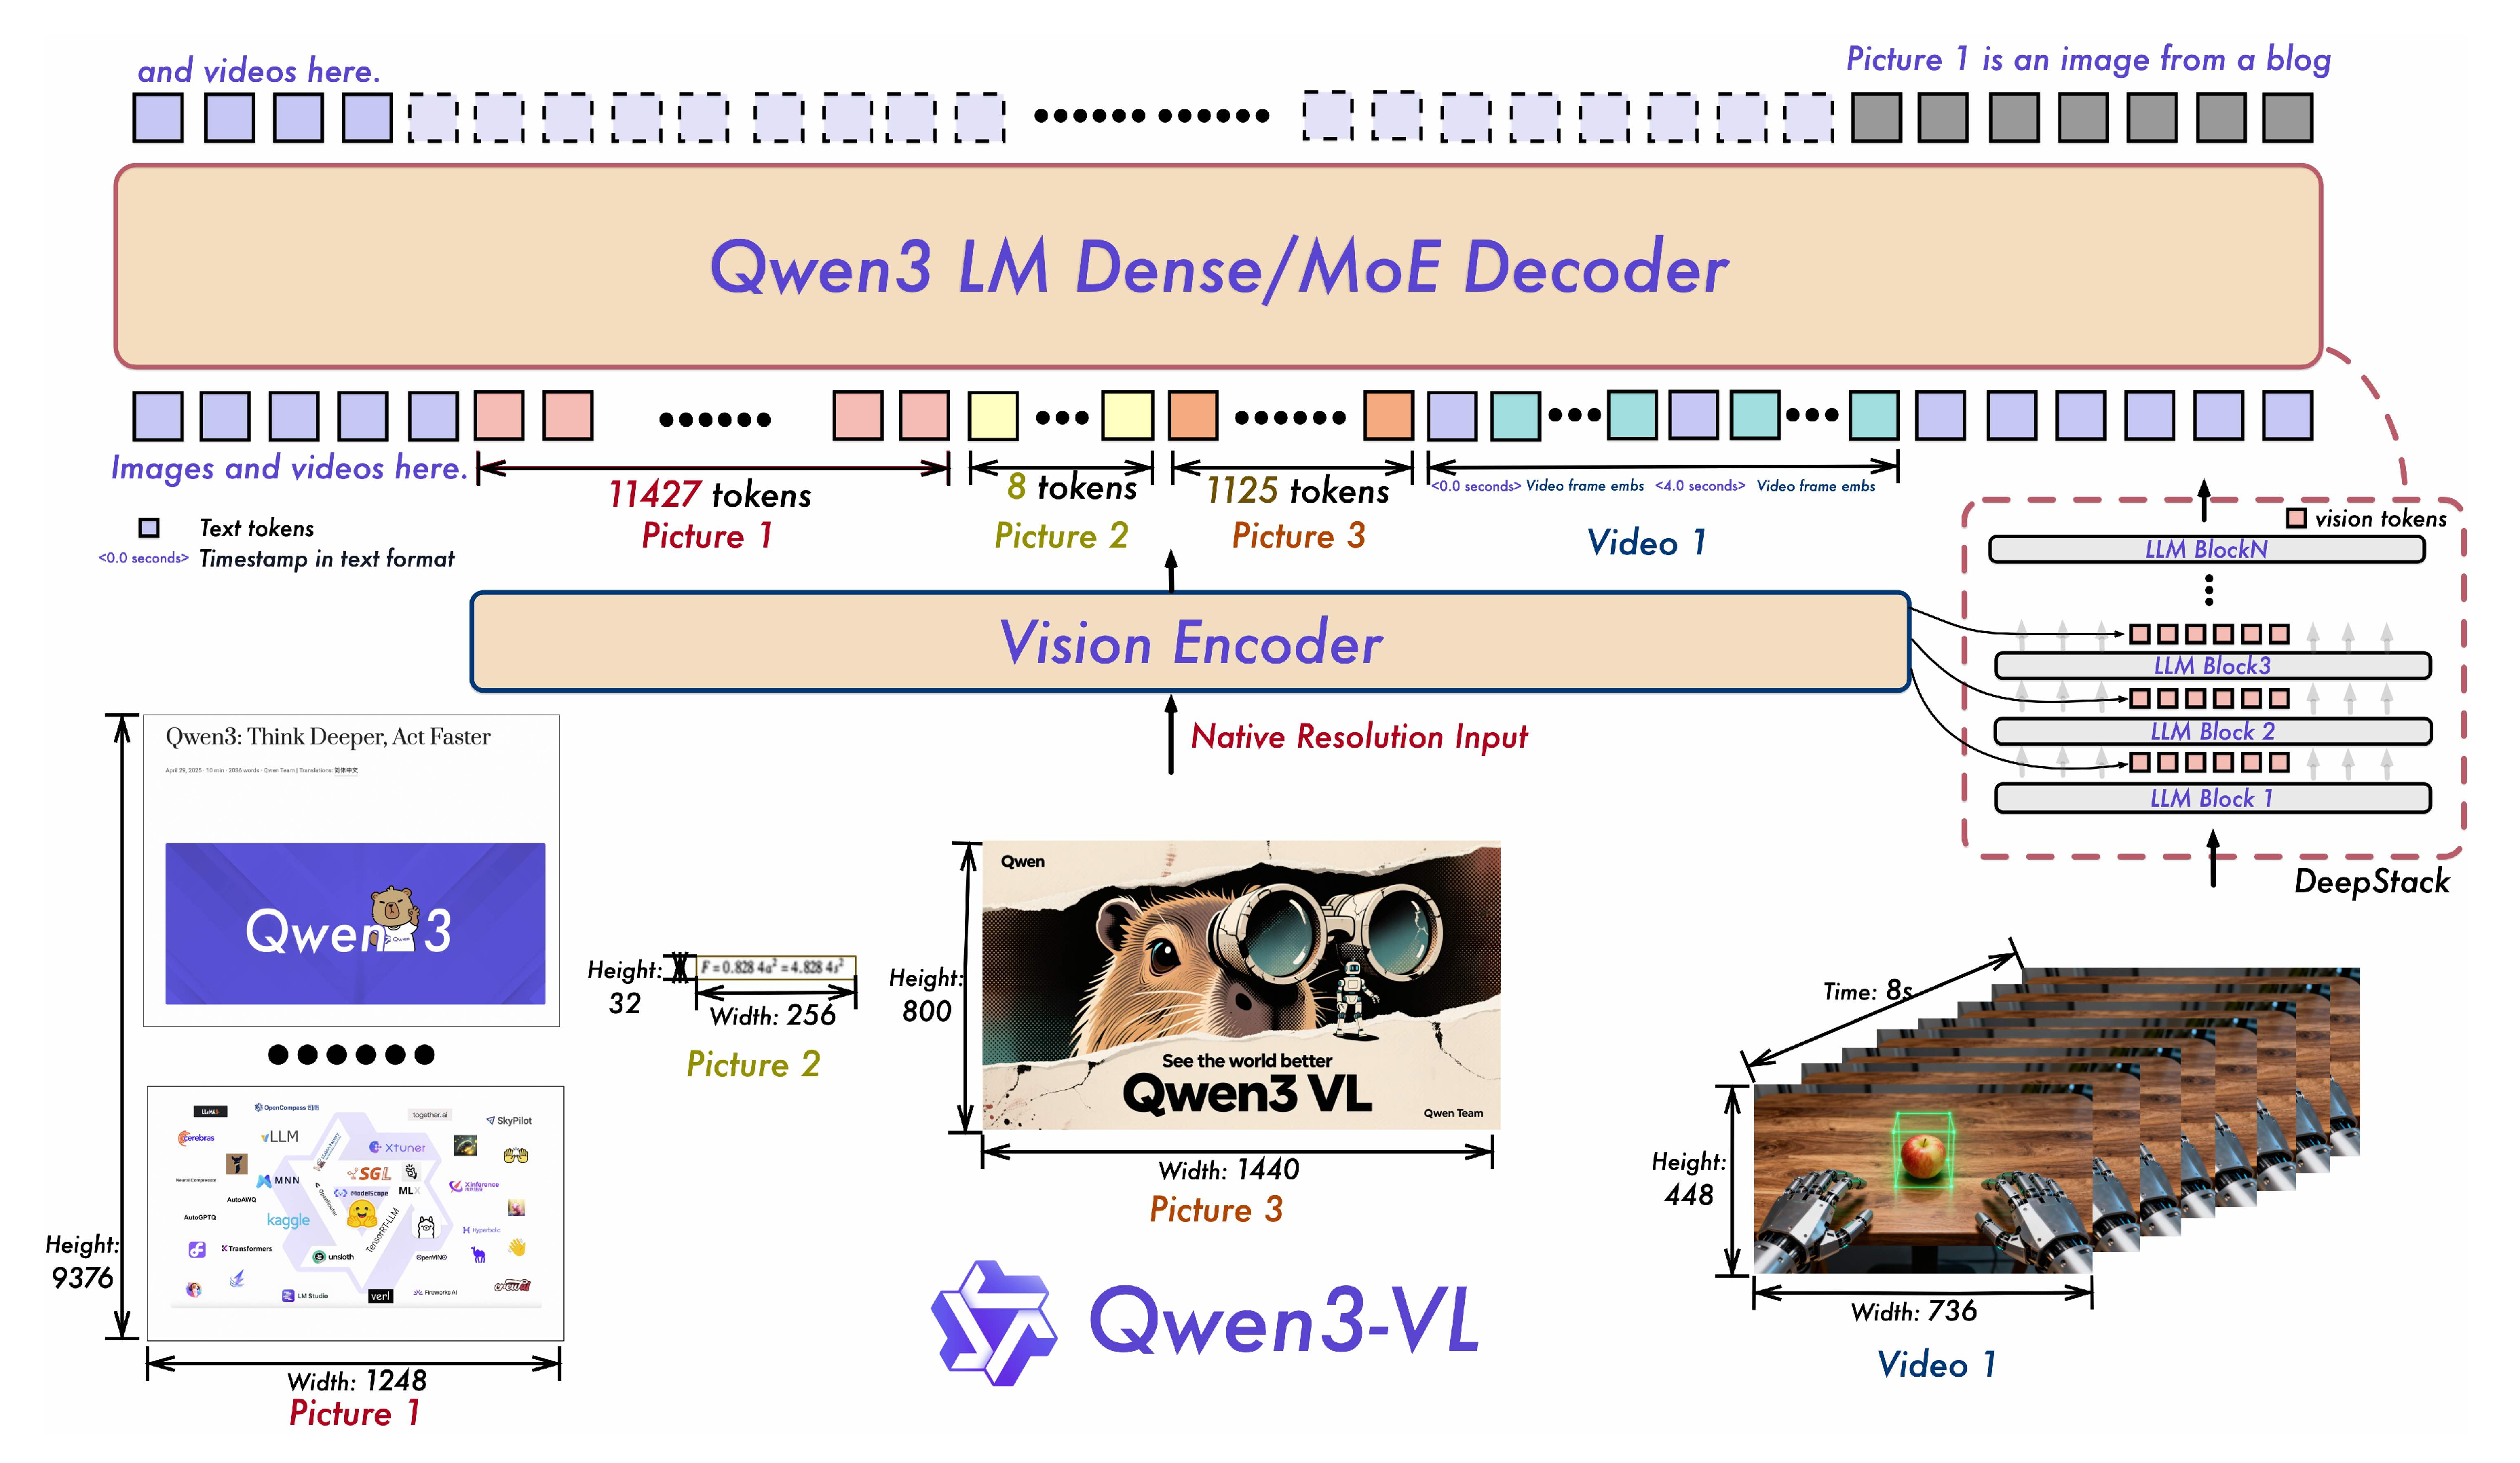
一文通透Qwen3-VL——在交错式MRoPE、DeepStack、文本时间戳对齐机制的基础上,先预训练,再后训练(即分别SFT、蒸馏、RL)

Qwen系列模型最新升级为Qwen3-VL,在视觉理解和视频处理方面有显著提升。引入多维旋转位置编码(MRoPE)和DeepStack技术,增强了对复杂场景的推理能力,支持长文档和长视频处理,具备更高的上下文长度和精确的时间定位能力,推动多模态理解的进步。

一文通透Qwen3-VL——在交错式MRoPE、DeepStack、文本时间戳对齐机制的基础上,先预训练,再后训练(即分别SFT、蒸馏、RL)

结构之法 算法之道 结构之法 算法之道 · 2026-05-08T07:57:45Z

大模型训练应视为流水线,分为数据工程、预训练、中训、微调和对齐等阶段。每个环节有不同的算力需求和挑战,数据质量至关重要。预训练需处理大量干净数据以确保模型稳定性,中训通过调整数据配比提升能力,微调教会模型理解指令,对齐阶段则使用多种算法优化模型表现。整体训练过程复杂,需关注数据、算力和工程细节。

【大模型基础设施工程】05:训练全景:Pre-train、SFT、RLHF、DPO、蒸馏

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-04-22T00:00:00Z
nanobot-sft

本文讨论了纳米机器人在监督微调(SFT)中的应用,重点在于数据构造和模型训练过程。模型通过处理用户和助手消息学习生成合适的回复,并强调了在SFT阶段模型如何有效停止输出,提出了线性衰减的学习率策略以提高训练稳定性。

nanobot-sft

plus studio plus studio · 2026-01-18T00:00:00Z

研究表明,在多模态大模型训练中,样本难度比训练范式更为重要。中兴通讯团队首次通过GRPO-only方法,在视觉推理和感知任务中超越传统的SFT+RL范式,提出了PISM和CMAB两种难度量化策略,显著提升了模型性能,验证了难度感知采样的有效性。

精准锁定「硬骨头」:难样本筛选破局SFT依赖,GRPO-only斩获感知推理双最优

量子位 量子位 · 2025-11-28T04:16:50Z

机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。

EMNLP2025 | SFT与RL的结合,vivo AI Lab提出新的后训练方法

机器之心 机器之心 · 2025-09-22T02:52:57Z

机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。

SFT远不如RL?永不过时的剃刀原则打开「终身学习」大模型训练的大门

机器之心 机器之心 · 2025-09-09T12:20:08Z

机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。

多模态后训练反常识:长思维链SFT和RL的协同困境

机器之心 机器之心 · 2025-08-02T12:44:48Z

机器之心数据服务现已上线,提供高效稳定的数据获取,简化用户的数据爬取流程。

首次结合RL与SFT各自优势,动态引导模型实现推理⾼效训练

机器之心 机器之心 · 2025-07-28T02:25:06Z

机器之心数据服务现已上线,提供高效稳定的数据获取服务,帮助用户轻松获取所需数据。

SFT+RL双管齐下:ReasonGen-R1如何破解文生图「指令不遵」难题?

机器之心 机器之心 · 2025-06-16T09:18:57Z

机器之心数据服务现已上线,提供高效稳定的数据获取,简化数据爬取流程。

无需SFT也不用RL,样本级推理优化神器SLOT来了,准确率轻松+10%

机器之心 机器之心 · 2025-06-09T08:13:19Z
  • <<
  • <
  • 1 (current)
  • 2
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码